AI API 费用对比:大模型 API 到底怎么收费
大模型 API 的价格由哪几部分组成,账单为什么会越滚越大,以及 15 家供应商的输入价、输出价到底差多少。数据为 2026 年 7 月 24 日实测。
- 大模型 API 最多按四项分别计费,可大多数价格对比只看其中一项。
- 输出 token 的价格,中位数是输入 token 的 4 倍,最高能到 12 倍。
- 截至 2026 年 7 月 24 日,15 家供应商公布的输入价,每百万 token 最低 $0.01,最高 $150。
大模型 API 的价格,到底是怎么算的
市面上的 AI API 费用对比,几乎都是一个模型只列一个数,而且列的基本是输入价。可在供应商公布的四个数里,输入价恰恰是最没参考价值的一个。一个模型要分开计四项费用:你发出去的 token、它写回来的 token、从缓存里读的 token,以及部分供应商还会收的“写入缓存”的 token。每一项都有自己的单价,而且彼此差得很远。
token 是模型处理文字的最小单位,英文里大约 4 个 token 对应 3 个单词,所以 100 万 token 差不多是 75 万个英文单词。价格之所以按每百万 token 报,是因为单条消息实在太便宜,按条报的话满屏都是 0。但这样报价也遮住了一件事:在真实对话里,每聊一轮都要把前面说过的所有内容重新发一遍,四项费用叠起来的速度比你想的快得多。
下面这张表列了几个模型的全部四项单价,来自驱动本站模型选择器和费用计算器的同一份模型数据。看一眼就明白,光看输入价能得到的信息有多有限:这里的输入价在 0.30 到 2.50 美元之间,输出价却从 1.20 拉到 15.00 美元,而输出正是波动最大的那一项。
- 输入:你发出去的所有内容,包括这条消息、之前的聊天记录、系统提示词、附带的文字。
- 输出:模型写回来的所有内容;如果是会“先思考再回答”的模型,思考过程产生的 token 也算在里面。
- 读取缓存:供应商见过的重复内容,按远低于新输入的单价收费。
- 写入缓存:有些供应商会为“把这段内容放进缓存”单独收一笔钱。
| 模型 | 输入(美元 / 百万 token) | 输出(美元 / 百万 token) | 读取缓存 | 写入缓存 |
|---|---|---|---|---|
| Claude Haiku 4.5 | 1.00 | 5.00 | 0.10 | 1.25 |
| Claude Sonnet 5 | 2.00 | 10.00 | 0.20 | 2.50 |
| GPT-5.6 Luna | 1.00 | 6.00 | 0.10 | 1.25 |
| GPT-5.6 Terra | 2.50 | 15.00 | 0.25 | 3.125 |
| Kimi k2.5 | 0.60 | 3.00 | 0.10 | 0.60 |
| Qwen3.7 Plus | 0.50 | 3.00 | 0.05 | 0.625 |
| MiniMax-M2.5 | 0.30 | 1.20 | 0.03 | 0.375 |
输出比输入贵,这一半才是大头
大模型定价里最靠谱的规律就一条:写的比读的贵。为了拿数据说话,我们把 Oriveo 模型数据里所有公布了单 token 价格的文本模型(覆盖全部 15 家供应商)都拿出来,拿每个模型自己的输出价去比它自己的输入价,数据截至 2026 年 7 月 24 日。
排在中间的那个模型,输出价正好是输入价的 4 倍。大约每 10 个模型里有 1 个,输出和输入一样贵,甚至更便宜,这在第三方托管的开源权重模型里很常见。另一头呢,大约每 7 个里有 1 个,输出价超过输入价的 6 倍,差距最大的一个达到 12 倍。
这直接关系到你怎么省钱。大家最先想到的是把提问写短一点,但那通常不是最管用的办法。让模型答得短一点、给输出长度设个上限,或者换一个不爱长篇大论“边想边说”的模型,比从问题里删掉一段话更能压低账单。带推理功能的模型尤其要留意:它们生成的思考过程,哪怕你从头到尾没看到,也按输出计费。
| 输出价是输入价的几倍 | 占有公布价格的文本模型的比例 |
|---|---|
| 一样贵或更便宜(1 倍及以下) | 10% |
| 1 到 2 倍 | 11% |
| 2 到 4 倍 | 39% |
| 4 到 6 倍 | 25% |
| 6 倍以上 | 15% |
账单到底是被什么推高的
很多人第一次收到 API 账单都会吓一跳,原因通常是下面这几条之一,而且没有一个是模型的标价。这几条对每家供应商都成立,因为它们来自聊天 API 本身的工作方式,跟哪家供应商的政策无关。
最大的一个是每轮都要重发聊天记录。API 调用是“没有记忆”的:模型不记得你上一轮说了什么,所以客户端每发一条消息,都得把整段对话再发一遍。一个已经聊了 40 轮的对话,到第 41 轮时,会把前 40 轮的内容全当作输入发出去。所以一段对话的成本,大致随长度的平方增长,这也是为什么同样的内容,聊在一个长对话里,可能比拆成 20 个短对话还贵。
提示词缓存(prompt caching)能起到抵消作用,值得先弄明白再决定用不用。供应商支持缓存的话,重复的内容就按“读取缓存”计费,不再按新输入算。在我们测的这批数据里,大约每 5 个模型有 1 个公布了缓存读取价;有的话,缓存价的中位数是该模型输入价的 10%,最低不到 1%,最高约 58%。有些供应商写入缓存时还要另外收费,通常比普通输入贵一些,所以缓存要在同一段内容被反复用好几次时才划算,只用一次反而亏。
- 聊天记录:每一轮都完整重发,所以对话越长,花得越不成比例。
- 系统提示词和预设:可复用的指令会加在每一条消息前面,token 数就这样被悄悄翻倍。
- 附件:丢进对话里的文档或图片会变成输入 token,而且这个对话之后的每一轮都会带着它。
- 推理 token:会思考的模型按输出计费,不管思考过程你看不看得到。
- 重试和重新生成:重新生成一次,等于又发了一次完整的收费请求,不是免费的修正。
15 家供应商的价格分布
下面这张表,是 Oriveo 接入的 15 家供应商各自公布的输入价区间快照。只统计公布了单 token 价格的文本模型,列出每家最便宜和最贵的那一个。它只是告诉你各家大致落在哪个价位,不是推荐:同一家供应商里,最便宜的和最贵的模型,基本没法互相替代。
数据来源和方法写在这里,方便你自己核对:每个数字都来自 Oriveo 线上环境的模型数据(api.oriveoai.com/api/metadata),版本 47,生成于 2026-07-24T01:00:09Z。应用给每条消息算费用,用的就是这一份数据,本站的费用计算器也是。价格单位是美元每百万 token,数据截至 2026 年 7 月 24 日。图像生成模型,以及按请求而不是按 token 计价的模型没有统计,因为对它们来说,单 token 价格没有意义。
有两点特别显眼。第一是跨度:整份数据里最便宜的输入价是每百万 token $0.01,最贵的是 $150,同一个模型选择器里,两行之间差了一万五千倍,数据截至 2026 年 7 月 24 日。第二是模型多和价格低是两回事:聚合平台因为转售很多家的模型,价格区间最宽;而只卖自家模型的供应商,价格都紧紧围绕自己的几个档位。
这里的每个数字都别当成一成不变的。供应商随时会调价、推出更便宜的档位、下线旧模型,下表里有好几行在过去一个季度里就变过。任何引用模型价格的文章都只是一张照片,所以才需要实时数据和计算器,本文也才写明了取数日期,而不是让你以为这些数字永远有效。
| 供应商 | 公布了 token 价格的文本模型数 | 最低输入价(美元 / 百万 token) | 最高输入价(美元 / 百万 token) |
|---|---|---|---|
| OpenAI | 49 | 0.05 | 150 |
| Anthropic (Claude) | 10 | 1.00 | 15 |
| Google Gemini | 21 | 0.075 | 2.00 |
| xAI Grok | 6 | 1.00 | 2.00 |
| DeepSeek | 4 | 0.14 | 0.435 |
| Mistral | 32 | 0.04 | 2.00 |
| Qwen | 49 | 0.035 | 2.80 |
| Kimi | 9 | 0.20 | 2.00 |
| MiniMax | 7 | 0.30 | 0.60 |
| Z.ai | 12 | 0.07 | 1.40 |
| Groq | 7 | 0.03 | 0.59 |
| Together AI | 69 | 0.02 | 3.50 |
| Fireworks AI | 15 | 0.07 | 2.80 |
| OpenRouter | 305 | 0.01 | 150 |
| SiliconFlow | 49 | 0.04 | 1.74 |
同一个模型,为什么会有好几个价
把两份模型目录打开对比,你会发现同一个模型标着不同的价格。这通常不是标错了。开源权重模型有好几家平台在托管运行,各家的硬件、速度和利润都不一样,所以同一个模型在这家和在那家,价格确实可以不同。上面那份数据里,同一个开源模型系列在好几家供应商那里的价格就真的不一样。
第二个原因是你从哪一层买。聚合平台夹在你和底层供应商之间,总得有办法养活自己:可能是在 token 单价上加一点差价,可能是收充值手续费,可能是按请求收一个百分比,也可能是搞一套额度体系(credits),额度和 token 怎么换算由平台自己定,而不是供应商的价目表。这些做法本身都没问题,关键是规则公不公开。比如 OpenRouter 把收费规则公开写明:截至 2026 年 7 月 24 日,它公布的政策是银行卡充值收 5.5% 的手续费、最低 $0.80;自带 API Key 的话,每月前 100 万次请求不收费,超出部分按模型正常价的 5% 从 credits 里扣。
比较平台的时候,值得问的不是“1 个 credit 多少钱”,而是“从供应商的标价到我实际被扣的钱,中间那条换算路径有没有公开”。如果一个平台用 credits 计价,又不公布怎么换算,那你比的就不是模型价格,而是这个平台的定价政策,而平台的政策可以在模型价格一分没动的情况下说改就改。
订阅和按量付费,哪个对你更划算
这是大多数人真正想问的问题,但它没有通用答案。固定月费的订阅和按量计费的 API,在某个用量上会打平,这个平衡点取决于你自己的使用习惯:每条消息多长、回答多长、选哪个模型、一个对话聊多久。不看你的数据就直接报一个“能省百分之几”,都是在瞎猜。
自己算一下大概只要五分钟,算术也不难。挑一个有代表性的一周,别挑最忙的那周。数一数发了多少条消息。估一下模型回答的平均字数,乘以约 1.35 换成 token 数。再加上输入那一边,别忘了每一轮都要把前面的对话重发一遍。然后乘以模型公布的输入价和输出价,再跟你在考虑的月费比一比。本站的费用计算器会按实时价格替你算好,省得你自己去盯价格。
有几条规律比较稳,不用编数字也能说清。用得少、时多时少,偶尔换着用几个模型而不是天天重度用一个,或者大部分是短问短答的时候,按量付费往往更划算。每天都稳定重度使用的话,订阅往往更划算,而且它还有一个实实在在的好处:账单是可预期的。最糟糕的是按量付费却看不到每条消息花了多少钱,两头都占不到便宜,而每条消息附一个费用预估,就是为了避免这种情况。
想省钱,具体怎么做
看清了这几项费用,大部分省钱的办法其实是养成几个习惯,而不是到处找最便宜的供应商。按对普通聊天场景的影响,从大到小排列如下:
通常没用的做法,是把所有事情都换成目录里最便宜的模型。一个价格只有五分之一、却要试三次才答对的模型,算不上省钱,还白搭了你的时间。这条建议真正有用的版本是让模型和任务对得上:提取信息、整理格式、写摘要、做翻译交给便宜的模型,真正难的活儿,也就是你原本要花钱请人做的那种,再交给贵的模型。
- 换话题就新开一个对话。这是效果最大的一招,因为不用再为重发一堆无关的聊天记录付钱。
- 想要短答案,就直接说要短答案。大约每 10 个模型里有 9 个,输出是更贵的那一项。
- 让模型和任务匹配,别什么事都默认用最强的那个。
- 系统提示词和可复用的预设写精简一点,每条用到它们的消息都要为它们付费。
- 供应商支持提示词缓存、而你又反复用同一段长内容时,记得用上。
- 附件用完就从对话里拿掉,别让它跟着后面每一轮一路重发。
- 同一种用法打算重复上百次之前,先看一眼那条消息的费用预估。
Oriveo 怎么把费用摆给你看
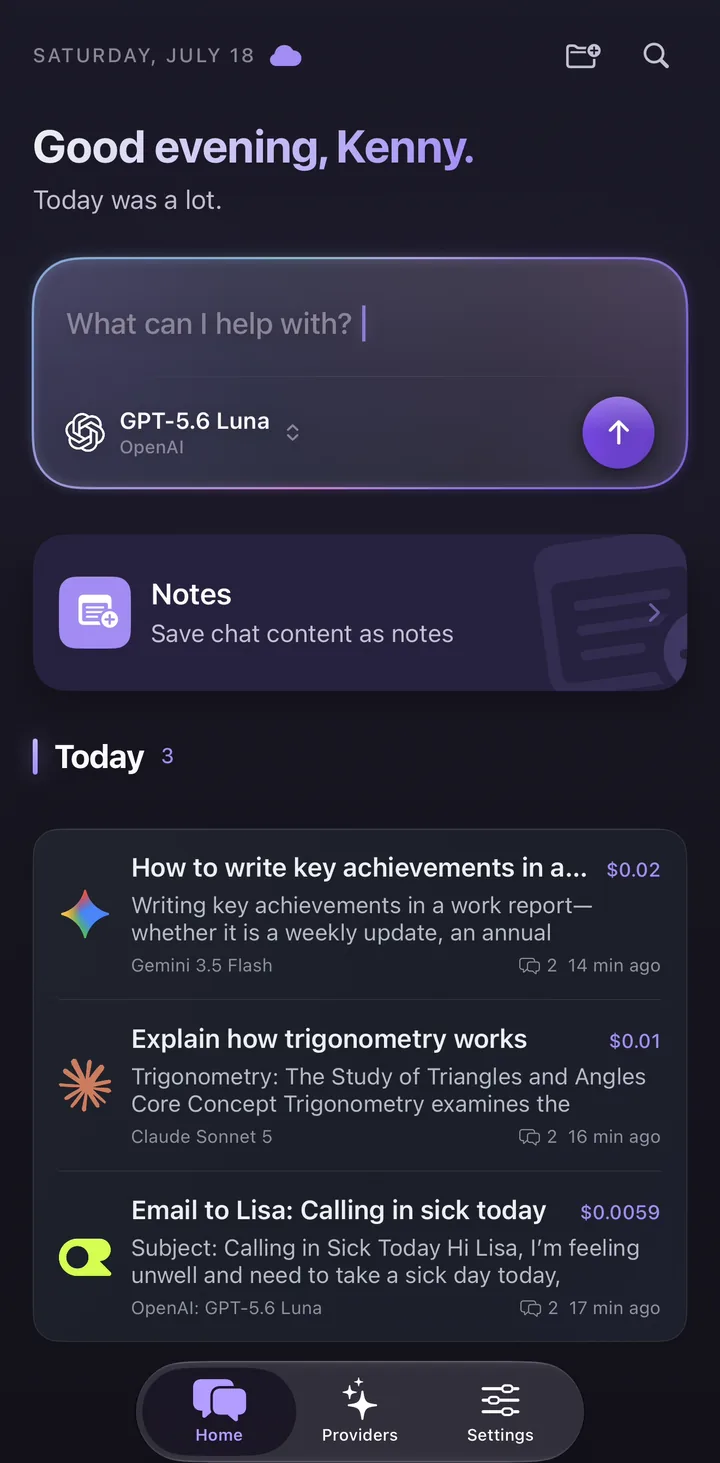
Oriveo 里每条消息都带一个预估费用:答案一结束,就按供应商公布的 token 价格和实际上报的 token 数算出来。所有档位都有这个功能,包括不用登录的那一档,因为一个只有付费才能看到的费用,帮不了你判断要不要付费。上面表里用的那份模型数据,就是这些价格的来源,所以你不用自己维护价目表。
这是预估,也明确标着是预估。供应商各有各的取整方式、最小计费单位、账号专属费率,偶尔还有促销价,而且 token 数是供应商事后才上报的。这个预估的作用,是让你在一个月里心里有数、做出判断;最终以供应商的账单为准,两者对不上时,账单才是对的。
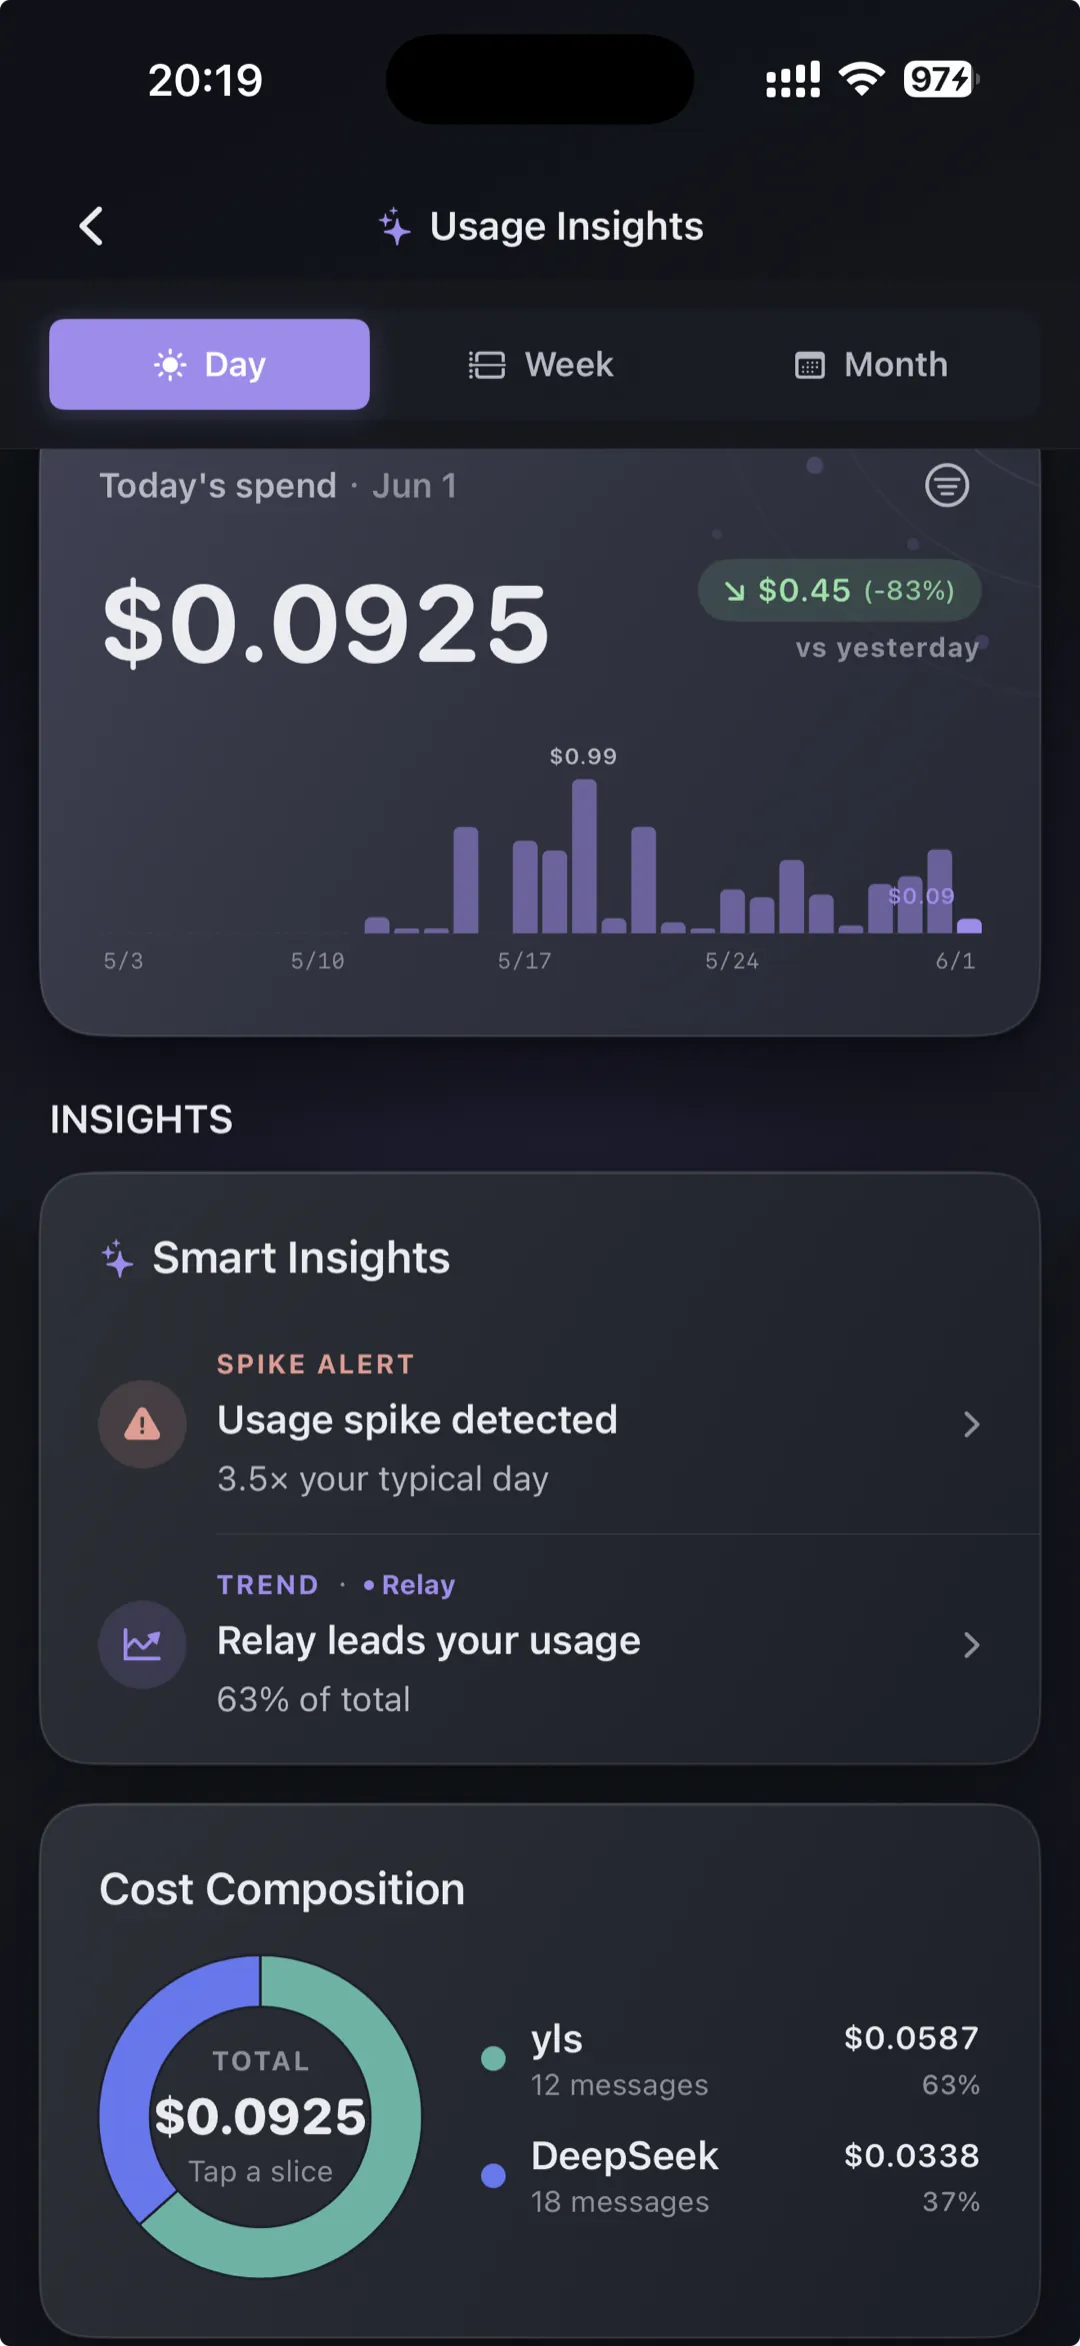
更细的分析在付费方案里。Usage Insights(按供应商和模型拆分的花费、月度趋势、预算提醒)属于 Pro 和终身版,截至 2026 年 7 月 24 日,价格是月付 $9.99、年付 $59.99,或一次性 $149.99。这些方案买的只是软件功能,不含任何 AI 用量、模型额度或供应商订阅,所以应用本身的价格和你用掉的 token 的价格,永远不会被捆成一个拆不开的数字。
这些数字没法告诉你的事
价格表只是起点,不是结论。有三件事表里没写,但值得说清楚,因为它们经常把一个光看价格似乎已经定了的对比整个翻过来。
第一是每个任务实际用掉的 token 数。两个单价相同的模型,得到同一个答案所花的 token 可以差很多,一个啰嗦的便宜模型,做完一件事的花费可能比一个惜字如金的贵模型还高。第二是重试率:答得不对、需要重新生成,就要收两次钱。第三是 token 计费以外的所有事:调用频率限制、响应速度、上下文长度、在你所在地区能不能用,以及模型能不能读你工作里用的那些文件格式。
正确用这类对比的方式,是拿它来缩小候选范围。先把明显超出预算的排除掉,挑两三个放到你自己的真实工作里试一试,然后看做完一件事花多少钱,而不是看一百万 token 多少钱。每条消息的费用预估,就是为了让这个试验一天就能做完,而不是等一个结算周期。