مقارنة تكلفة AI API: كيف يُسعَّر النموذج فعلًا
كيف يُحسب سعر LLM API فعلًا، وما الذي يرفع الفاتورة، وكم يتراوح سعر الإدخال والإخراج عند 15 مزوّدًا، مقيسًا بتاريخ 24 يوليو 2026.
- واجهات LLM API تحاسب على أربعة عدّادات منفصلة كحد أقصى، ومعظم مقارنات الأسعار تنظر إلى واحد منها فقط.
- القيمة الوسطى لسعر tokens الإخراج أربعة أضعاف سعر tokens الإدخال، وقد يصل الفارق إلى اثني عشر ضعفًا.
- أسعار الإدخال المنشورة عند 15 مزوّدًا تمتد من $0.01 إلى $150 لكل مليون token بتاريخ 24 يوليو 2026.
كيف يعمل تسعير LLM API فعلًا
تقريبًا كل مقارنة لتكاليف AI API تنقل رقمًا واحدًا لكل نموذج، وهذا الرقم غالبًا هو سعر الإدخال. وهو أقل الأرقام الأربعة التي ينشرها المزوّد فائدة. فالنموذج يحاسب على عدّادات منفصلة: الرموز (tokens) التي ترسلها إليه، والتي يكتبها في رده، والتي تُقرأ من ذاكرة مؤقتة (cache)، وعند بعض المزوّدين الرموز التي تُكتب في تلك الذاكرة. لكل عدّاد سعره، والأسعار متباعدة.
الـ token يساوي تقريبًا ثلاثة أرباع الكلمة الإنجليزية، فمليون token قرابة 750,000 كلمة. وتُذكر الأسعار لكل مليون token لأن الرسالة الواحدة رخيصة جدًا، ولو سُعّرت الرسالة وحدها لكانت الأرقام أصفارًا. لكن هذا العرض يُخفي سرعة تراكم العدّادات في محادثة حقيقية، فكل رد يعيد إرسال كل ما قيل قبله.
يعرض الجدول أدناه العدّادات الأربعة كلها لعدد قليل من النماذج، من بيانات metadata نفسها التي تشغّل قائمة النماذج وحاسبة التكلفة في هذا الموقع. ولنلاحظ كم يقول عمود الإدخال قليلًا: أسعار الإدخال هنا تتراوح بين 0.30 و2.50 دولار، بينما تمتد أسعار الإخراج من 1.20 إلى 15.00 دولارًا، والإخراج هو العدّاد الذي يتحرك أكثر.
- الإدخال — كل ما ترسله: رسالتك، والمحادثة حتى الآن، وأي تعليمات نظام، وأي نص مرفق.
- الإخراج — كل ما يكتبه النموذج في رده، بما فيه tokens التفكير في النماذج التي تنتجها.
- قراءة الإدخال من الذاكرة المؤقتة — سياق متكرر سبق أن رآه المزوّد، ويُحاسَب بسعر أقل بكثير من الإدخال الجديد.
- كتابة الذاكرة المؤقتة — ما يأخذه بعض المزوّدين مقابل وضع هذا السياق في الذاكرة المؤقتة أول مرة.
| النموذج | الإدخال (USD / مليون token) | الإخراج (USD / مليون token) | قراءة الإدخال من الذاكرة المؤقتة | كتابة الذاكرة المؤقتة |
|---|---|---|---|---|
| Claude Haiku 4.5 | 1.00 | 5.00 | 0.10 | 1.25 |
| Claude Sonnet 5 | 2.00 | 10.00 | 0.20 | 2.50 |
| GPT-5.6 Luna | 1.00 | 6.00 | 0.10 | 1.25 |
| GPT-5.6 Terra | 2.50 | 15.00 | 0.25 | 3.125 |
| Kimi k2.5 | 0.60 | 3.00 | 0.10 | 0.60 |
| Qwen3.7 Plus | 0.50 | 3.00 | 0.05 | 0.625 |
| MiniMax-M2.5 | 0.30 | 1.20 | 0.03 | 0.375 |
tokens الإخراج هي النصف الأغلى
أثبت نمط في تسعير LLM أن الكتابة أغلى من القراءة. ولنعطي رقمًا بدل انطباع، أخذنا كل نموذج نصي في بيانات Oriveo (metadata) ينشر سعرًا لكل token، عبر المزوّدين الـ 15 كلهم، وقارنّا سعر إخراج كل نموذج بسعر إدخاله هو، بتاريخ 24 يوليو 2026.
في منتصف الترتيب، يأخذ النموذج على الإخراج أربعة أضعاف ما يأخذه على الإدخال بالضبط. نموذج من كل عشرة تقريبًا يأخذ السعر نفسه للاثنين أو أقل على الإخراج، وهذا شائع في النماذج مفتوحة الأوزان التي تقدّمها جهات تستضيف تشغيل النماذج. وفي الطرف الآخر، نموذج من كل سبعة تقريبًا يأخذ أكثر من ستة أضعاف، وأكبر فجوة في البيانات اثنا عشر ضعفًا.
وهذا له أثر مباشر على طريقة إنفاقك. اختصار طلبك هو أول تحسين يفكر فيه الجميع، وهو غالبًا الأصغر أثرًا. أن تطلب إجابة أقصر، أو تضع حدًا لطول الإخراج، أو تختار نموذجًا لا يفكّر بصوت عالٍ طويلًا، سيحرّك الفاتورة أكثر من حذف فقرة من السؤال. ونماذج التفكير تستحق نظرة ثانية هنا، لأن tokens التفكير التي تولّدها تُحاسَب كإخراج حتى لو لم تظهر لك.
| سعر الإخراج مقارنةً بسعر الإدخال | حصة النماذج النصية المسعّرة |
|---|---|
| السعر نفسه أو أرخص (1× أو أقل) | 10% |
| من 1× إلى 2× | 11% |
| من 2× إلى 4× | 39% |
| من 4× إلى 6× | 25% |
| أكثر من 6× | 15% |
ما الذي يرفع فاتورتك فعلًا
أغلب الناس تفاجئهم أول فاتورة API لسبب من أربعة، وليس أي منها السعر المكتوب بالخط الكبير للنموذج. والآليات أدناه صحيحة عند كل مزوّد، لأنها تنتج من طريقة عمل واجهات المحادثة، لا من سياسة شركة بعينها.
أكبرها إعادة إرسال السياق. استدعاء API لا يحتفظ بحالة: النموذج لا يتذكر ردك السابق، فيضطر التطبيق إلى إعادة إرسال المحادثة كلها مع كل رسالة. محادثة وصلت إلى أربعين جولة ترسل سجل الجولات الأربعين كإدخال في الجولة الحادية والأربعين. لذلك تنمو كلفة المحادثة تقريبًا بمربع طولها، ولهذا قد تكلّف محادثة طويلة واحدة أكثر من عشرين محادثة قصيرة تتناول الموضوع نفسه.
التخزين المؤقت للطلبات (prompt caching) هو الوزن المقابل، ويستحق أن تفهمه قبل أن تتجاهله. المزوّدون الذين يدعمونه يحاسبون السياق المتكرر كقراءة من الذاكرة المؤقتة بدل إدخال جديد. في البيانات التي قسناها، نموذج من كل خمسة تقريبًا ينشر سعر قراءة من الذاكرة المؤقتة، وحيث يوجد تكون قيمة هذا السعر الوسطى 10% من سعر إدخال النموذج نفسه: أقل قيمة وجدناها أقل من 1%، وأعلاها نحو 58%. وبعض المزوّدين يأخذ أيضًا مقابل الكتابة في الذاكرة المؤقتة، وعادةً بسعر أعلى من الإدخال العادي، فالتخزين المؤقت يفيد حين يُعاد استخدام السياق نفسه عدة مرات، لا حين يُستخدم مرة واحدة.
- سجل المحادثة — يُعاد إرساله كاملًا في كل جولة، فالمحادثات الطويلة أغلى بشكل غير متناسب.
- تعليمات النظام والإعدادات الجاهزة — التعليمات التي تعيد استخدامها تُضاف قبل كل رسالة، فتضاعف عدد الـ tokens بصمت.
- المرفقات — مستند أو صورة تضعها في المحادثة تصبح tokens إدخال، وتبقى في السياق مع كل جولة لاحقة في تلك المحادثة.
- tokens التفكير — تُحاسَب كإخراج في النماذج التي تولّدها، سواء عُرض التفكير أم لا.
- إعادة المحاولة وإعادة التوليد — الإجابة المعاد توليدها طلب ثانٍ كامل يُحاسَب عليه، وليست تصحيحًا مجانيًا.
خريطة الأسعار عند 15 مزوّدًا
الجدول أدناه لقطة لنطاق سعر الإدخال المنشور عند كل مزوّد من المزوّدين الـ 15 الذين يتصل بهم Oriveo. يحسب فقط النماذج النصية التي تنشر سعرًا لكل token، ويعرض أرخصها وأغلاها عند ذلك المزوّد. هو خريطة لموقع كل مزوّد وليس توصية: أرخص نموذج عند مزوّد وأغلاه نادرًا ما يكون أحدهما بديلًا للآخر.
المصدر والمنهج، لتتمكن من التحقق: كل رقم يأتي من بيانات metadata الخاصة بـ Oriveo في الإنتاج على api.oriveoai.com/api/metadata، إصدار العقد 47، وقت التوليد 2026-07-24T01:00:09Z، وهي البيانات نفسها التي يستخدمها التطبيق لتسعير الرسائل والتي تقف خلف حاسبة التكلفة في هذا الموقع. الأسعار بالدولار الأمريكي لكل مليون token، بتاريخ 24 يوليو 2026. استبعدنا نماذج توليد الصور والنماذج التي يسعّرها المزوّد لكل طلب لا لكل token، لأن رقمًا لكل token لا معنى له فيها.
يلفت النظر أمران. الأول التباين: أرخص سعر إدخال في البيانات كلها $0.01 لكل مليون token وأغلاه $150، أي فرق خمسة عشر ألف ضعف بين صفّين في القائمة نفسها بتاريخ 24 يوليو 2026. والثاني أن اتساع الفهرس والرخص محوران مختلفان: المجمّعون (aggregators) عندهم أوسع نطاق لأنهم يعيدون بيع نماذج شركات كثيرة، بينما مزوّدو الشركة الواحدة تتقارب أسعارهم حول تدرّجهم الخاص.
كل رقم هنا قابل للتغيّر. المزوّدون يعيدون التسعير، ويطلقون باقات أرخص، ويوقفون نماذج باستمرار؛ وتغيّرت عدة صفوف أدناه خلال الربع الماضي. أي مقال ينقل أسعار النماذج هو صورة ثابتة للحظة، ولهذا توجد البيانات الحية والحاسبة، ولهذا تذكر هذه الصفحة تاريخ اللقطة بدل أن توحي بأن الأرقام دائمة.
| المزوّد | نماذج نصية بسعر token منشور | أدنى إدخال (USD / مليون) | أعلى إدخال (USD / مليون) |
|---|---|---|---|
| OpenAI | 49 | 0.05 | 150 |
| Anthropic (Claude) | 10 | 1.00 | 15 |
| Google Gemini | 21 | 0.075 | 2.00 |
| xAI Grok | 6 | 1.00 | 2.00 |
| DeepSeek | 4 | 0.14 | 0.435 |
| Mistral | 32 | 0.04 | 2.00 |
| Qwen | 49 | 0.035 | 2.80 |
| Kimi | 9 | 0.20 | 2.00 |
| MiniMax | 7 | 0.30 | 0.60 |
| Z.ai | 12 | 0.07 | 1.40 |
| Groq | 7 | 0.03 | 0.59 |
| Together AI | 69 | 0.02 | 3.50 |
| Fireworks AI | 15 | 0.07 | 2.80 |
| OpenRouter | 305 | 0.01 | 150 |
| SiliconFlow | 49 | 0.04 | 1.74 |
لماذا يكون للنموذج نفسه أكثر من سعر
إذا فتحت دليلَي نماذج ستجد النموذج نفسه بأسعار مختلفة. وهذا ليس خطأً في العادة. النماذج مفتوحة الأوزان تقدّمها عدة جهات استضافة، ولكل منها عتادها وقدرتها على التشغيل وهامش ربحها، فقد يكلّف النموذج شيئًا عند جهة وشيئًا آخر عند غيرها، وبشكل مشروع. وفي البيانات أعلاه، تظهر عائلة الأوزان المفتوحة نفسها عند عدة مزوّدين بأسعار مختلفة فعلًا.
السبب الثاني هو الجهة التي تشتري عن طريقها. المجمّعون يقفون بينك وبين المزوّد الأصلي ولا بد أن يموّلوا هذا الموقع بطريقة ما: فرق في أسعار الـ tokens، أو رسوم شحن، أو نسبة على الطلبات، أو نظام أرصدة تحدد المنصة نفسها تحويله إلى tokens بدل قائمة أسعار المزوّد. ولا شيء من هذا سيئ بذاته؛ المهم هل الآلية منشورة. فـ OpenRouter مثلًا يوثّق شروطه علنًا: بتاريخ 24 يوليو 2026 سياسته المنشورة رسوم 5.5% على شحن الرصيد بالبطاقة بحد أدنى $0.80، ولمن يستخدم مفاتيحه الخاصة فأول مليون طلب كل شهر مجانًا، ثم تُخصم 5% من السعر المعتاد للنموذج من رصيده بعد ذلك.
عند المقارنة بين المنصات، السؤال الذي يستحق أن يُطرح ليس «كم يساوي الرصيد» بل «ما الطريق المنشور من سعر قائمة المزوّد إلى ما أُحاسَب عليه». فإن كانت المنصة تسعّر بالأرصدة ولا تنشر هذا التحويل، فأنت لا تقارن بسعر النموذج، بل بسياسة تسعير المنصة، وهذه السياسة قد تتغير دون أن يتغير سعر النموذج أصلًا.
اشتراك أم دفع حسب الاستخدام: أيهما أرخص لك
هذا هو السؤال الذي يأتي به معظم الناس فعلًا، وليس له جواب عام. الاشتراك الشهري الثابت والوصول المحاسَب بالاستخدام عبر API يتساويان عند حجم استخدام معين، ونقطة التساوي هذه تتوقف على رسائلك أنت: طولها، وطول الإجابات، والنموذج الذي تختاره، ومدى طول محادثاتك. ومن يذكر لك نسبة توفير دون أرقامك فهو يخمّن.
يمكن حساب ذلك في نحو خمس دقائق، والحساب ليس صعبًا. يُؤخذ أسبوع عادي فعلًا لا أكثر أسابيعك ازدحامًا. تُعدّ الرسائل. يُقدَّر متوسط طول الإجابات بالكلمات ويُضرب في 1.35 تقريبًا للحصول على الـ tokens. ثم يُضاف جانب الإدخال، مع تذكّر أن كل جولة تعيد إرسال المحادثة حتى تلك اللحظة. بعد ذلك يُضرب الناتج في سعري الإدخال والإخراج المنشورين للنموذج، ويُقارَن بالرسم الشهري الذي تفكر فيه. حاسبة التكلفة في هذا الموقع تفعل ذلك بالأسعار الحية، فلا تحتاج أن تحتفظ بالأسعار بنفسك.
هناك أنماط ثابتة بما يكفي لنذكرها دون أن نخترع أرقامًا. الوصول المحاسَب بالاستخدام يكون غالبًا أرخص حين يكون الاستخدام خفيفًا أو متقطعًا، وحين تستخدم عدة نماذج من وقت لآخر بدل نموذج واحد بكثافة، وحين يكون معظم عملك أسئلة قصيرة بإجابات قصيرة. والاشتراكات تكون غالبًا أرخص عند حجم يومي مرتفع باستمرار، ولها ميزة حقيقية غير مالية: فاتورة يمكن توقعها. أما الوصول المحاسَب بالاستخدام دون رؤية لتكلفة كل رسالة فهو أسوأ الاثنين، وهذا بالضبط ما يُراد للتكلفة التقديرية على كل رسالة أن تمنعه.
كيف تخفّض ما تنفقه فعلًا
بعد أن ترى العدّادات، يأتي معظم التوفير من عادات قليلة، وليس من البحث عن أرخص مزوّد. مرتبة تقريبًا بحسب أثرها في الرقم، لحمل محادثة عادي:
ما لا ينفع غالبًا هو نقل كل شيء إلى أرخص نموذج في الفهرس. نموذج يحتاج ثلاث محاولات ليصيب الإجابة بخُمس السعر ليس توفيرًا، وهو يكلّفك الوقت أيضًا. والمعنى المفيد لهذه النصيحة هو مطابقة النموذج للمهمة: النماذج الرخيصة للاستخراج والتنسيق والتلخيص والترجمة، والغالية للعمل الذي كنت ستدفع لشخص كي ينجزه.
- فتح محادثة جديدة لكل موضوع جديد. هذا أكبر عامل وحده، لأنه يوقف الدفع مقابل إعادة إرسال سجل لا علاقة له بالموضوع.
- طلب إجابات أقصر حين تكون الإجابة الأقصر هي المطلوبة. الإخراج هو العدّاد الأغلى في نحو تسعة نماذج من كل عشرة.
- مطابقة النموذج للمهمة بدل افتراض الأقوى لكل شيء.
- إبقاء تعليمات النظام والإعدادات الجاهزة قصيرة، فهي تُحاسَب مع كل رسالة تستخدمها.
- استخدام التخزين المؤقت للطلبات حيث يدعمه المزوّد وحين يُعاد استخدام السياق الطويل نفسه مرارًا.
- إزالة المرفقات من المحادثة بعد الانتهاء منها، بدل حملها في كل جولة لاحقة.
- مراجعة التقدير على الرسالة قبل تكرار النمط نفسه مئة مرة.
كيف يعرض Oriveo التكلفة
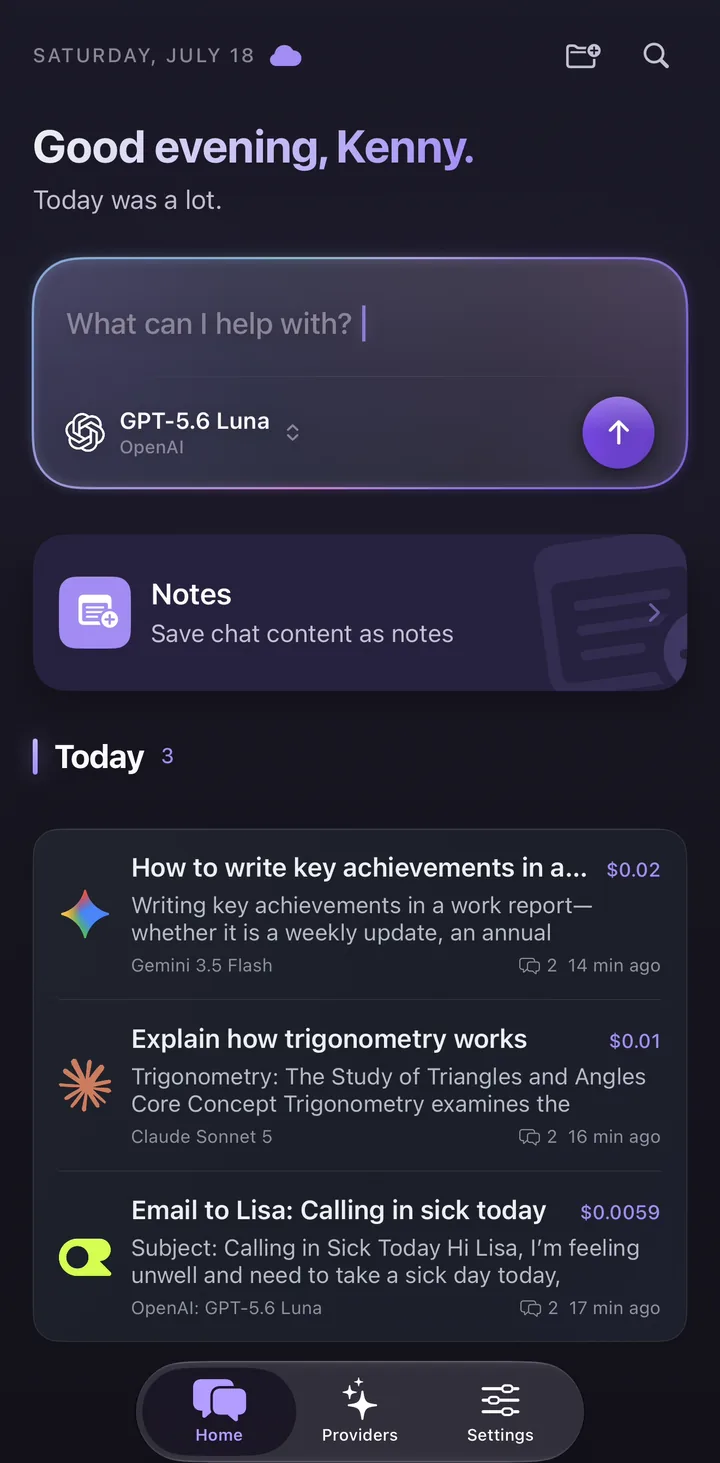
كل رسالة في Oriveo معها تكلفة تقديرية، تُحسب من أسعار الـ tokens التي ينشرها المزوّد ومن الـ tokens التي يبلّغ بها فعلًا، لحظة انتهاء الإجابة. هذا التقدير متاح في كل الباقات، حتى التي بلا تسجيل دخول، لأن تكلفة لا تراها إلا في خطة مدفوعة لا تساعدك على أن تقرر هل تدفع مقابل أي شيء. وبيانات metadata نفسها المستخدمة في الجداول أعلاه هي التي تمدّ التطبيق بهذه الأسعار، ولهذا لا يحتاج أن تحدّث قائمة أسعار بنفسك.
هو تقدير، ومكتوب عليه أنه تقدير. المزوّدون يطبّقون تقريبهم الخاص وحدودهم الدنيا للفوترة وأسعارًا خاصة بكل حساب وأحيانًا أسعارًا ترويجية، وأعداد الـ tokens يبلّغ بها المزوّد بعد الحدث. التقدير موجود ليساعدك في قراراتك خلال الشهر؛ وفاتورة المزوّد هي الحكم الأخير، وعند الاختلاف تكون الفاتورة هي الصحيحة.
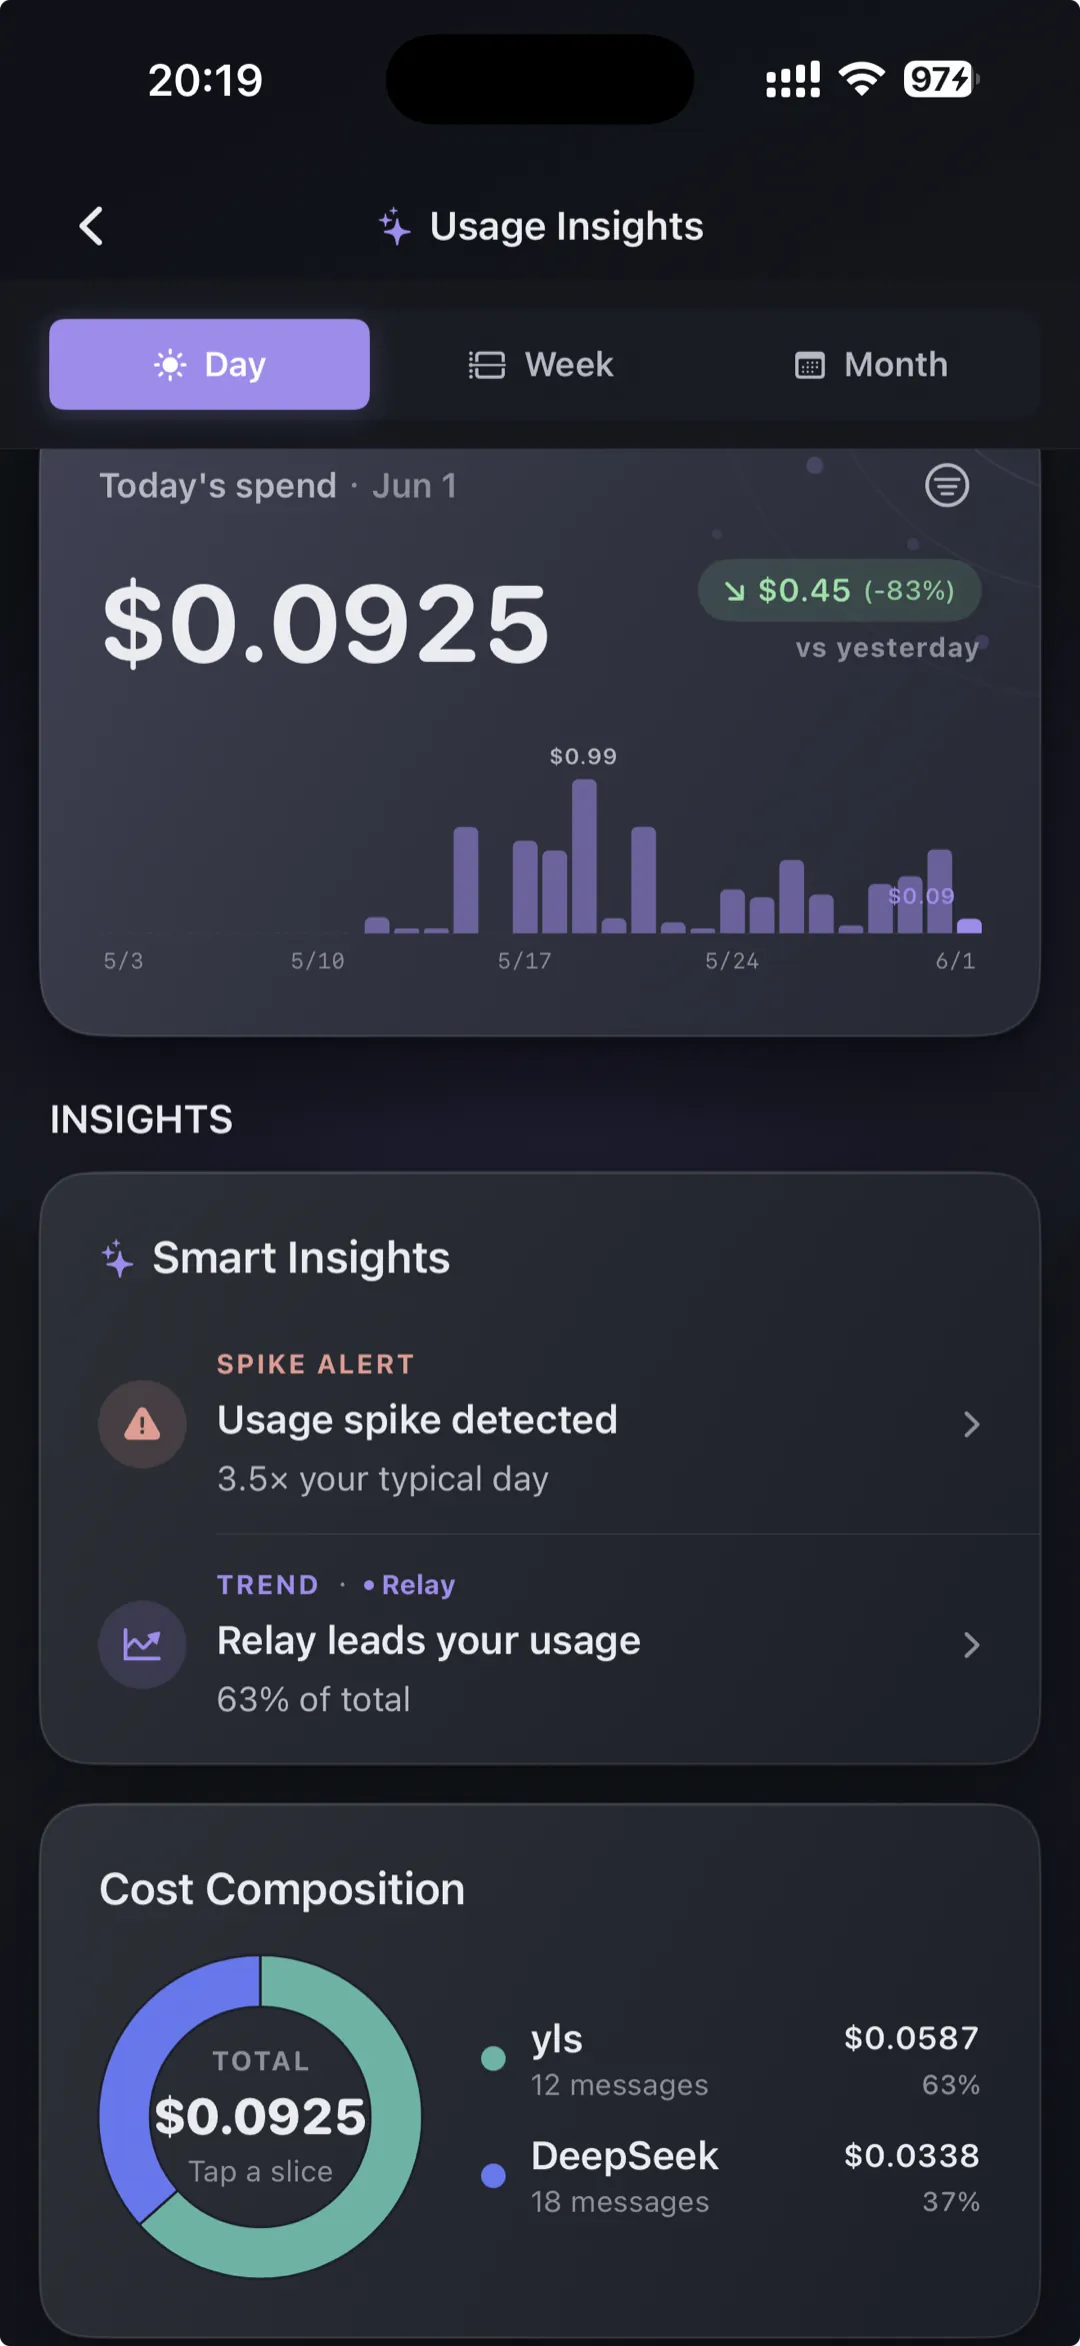
التحليل الأعمق في الخطط المدفوعة. Usage Insights — الإنفاق مفصّلًا حسب المزوّد والنموذج، والاتجاهات الشهرية، وتنبيهات الميزانية — جزء من Pro و Lifetime، وتكلّف $9.99 شهريًا أو $59.99 سنويًا أو $149.99 مرة واحدة بتاريخ 24 يوليو 2026. هذه الخطط تشتري ميزات برمجية فقط: لا تشمل أي استخدام للذكاء الاصطناعي ولا أرصدة نماذج ولا اشتراك مزوّد، فلا يُجمع سعر التطبيق وسعر الـ tokens في رقم واحد لا يمكن فصله.
ما لا تستطيع هذه الأرقام أن تقوله
جدول الأسعار نقطة بداية وليس قرارًا. هناك ثلاثة أشياء يتركها خارجه تستحق أن تُذكر صراحةً، لأنها كثيرًا ما تقلب مقارنة بدت محسومة على السعر وحده.
الأول هو عدد الـ tokens لكل مهمة. نموذجان بالسعر نفسه قد يختلفان كثيرًا في عدد الـ tokens التي ينفقانها للوصول إلى الإجابة نفسها، وقد يكلّف نموذج رخيص ثرثار أكثر لكل مهمة منجزة من نموذج غالٍ مقتضب. والثاني معدل إعادة المحاولة: الإجابة التي تحتاج إلى إعادة توليد تُحاسَب مرتين. والثالث كل ما هو خارج عدّاد الـ tokens: حدود الطلبات، وسرعة الاستجابة، وحجم السياق، والتوفر في منطقتك، وهل يستطيع النموذج قراءة صيغ الملفات التي تعمل بها.
الطريقة الأمينة لاستخدام مقارنة كهذه أن تكون مصفاة للقائمة المختصرة. تُستبعد الصفوف التي هي خارج ميزانيتك بوضوح، ويُجرَّب اثنان أو ثلاثة على عملك الحقيقي، وتُقارَن كلفة المهمة المنجزة بدل كلفة مليون token. والتقدير على كل رسالة موجود بالضبط ليأخذ هذا الاختبار يومًا واحدًا لا دورة فوترة كاملة.
الأسئلة الشائعة
كم تكلّف رسالة واحدة إلى LLM API فعلًا؟
لماذا الإخراج أغلى من الإدخال؟
هل يخفّض التخزين المؤقت للطلبات الفاتورة فعلًا؟
هل API بالدفع حسب الاستخدام أرخص من اشتراك شهري في الذكاء الاصطناعي؟
لماذا يكلّف النموذج نفسه مبالغ مختلفة على منصات مختلفة؟
ما مدى حداثة الأسعار في هذا المقال؟
هل يضيف Oriveo هامشًا على ما يأخذه المزوّدون؟
قراءات ذات صلة
تكلفة كل رسالة تراها لحظة إرسالها
يعرض Oriveo تكلفة تقديرية على كل رسالة بسعر قائمة المزوّد، عبر 15 مزوّدًا رسميًا و 700+ نموذج، على iPhone و Android والويب، ومن دون هامش على استخدام المزوّد.