Perbandingan biaya API AI: begini cara harga LLM bekerja
Dari apa harga API LLM sebenarnya tersusun, apa yang mendorong tagihanmu, dan rentang harga masukan serta keluaran yang nyata di 15 penyedia, diukur pada 24 Juli 2026.
- API LLM menagih lewat hingga empat meter terpisah, dan sebagian besar perbandingan harga hanya melihat satu di antaranya.
- Token keluaran berharga median empat kali token masukan, dan hingga dua belas kali.
- Harga masukan yang diterbitkan di 15 penyedia merentang dari $0.01 sampai $150 per juta token per 24 Juli 2026.
Bagaimana harga API LLM sebenarnya bekerja
Hampir setiap perbandingan biaya API AI mengutip satu angka per model, dan angka itu hampir selalu harga masukan. Itu yang paling tidak berguna di antara empat angka yang diterbitkan penyedia. Sebuah model menagih pada meter terpisah: token yang kamu kirim masuk, token yang ditulis balik oleh model, token yang dibaca dari cache, dan — pada sebagian penyedia — token yang ditulis ke cache itu. Tiap meter punya tarifnya sendiri, dan tarif-tarif itu tidak berdekatan.
Satu token kira-kira tiga perempat kata bahasa Inggris, jadi satu juta token berada di sekitar 750,000 kata. Harga dikutip per juta token karena satu pesan begitu murah, sampai harga per pesan hanya akan berisi nol. Cara mengutip seperti itu menyembunyikan betapa cepat meter-meter ini menumpuk dalam percakapan nyata, karena setiap giliran mengirim ulang semua yang sudah dikatakan sebelumnya.
Tabel di bawah menunjukkan keempat meter untuk segelintir model, diambil dari umpan metadata yang sama yang menggerakkan pemilih model dan kalkulator biaya di situs ini. Perhatikan betapa sedikit informasi dari kolom masukan: harga masukan di sini berkisar dari 0,30 sampai 2,50 dolar, sedangkan harga keluaran membentang dari 1,20 sampai 15,00 dolar, dan keluaran adalah meter yang paling menggerakkan tagihan.
- Masukan — semua yang kamu kirim: pesanmu, percakapan sejauh ini, prompt sistem apa pun, teks lampiran apa pun.
- Keluaran — semua yang ditulis balik model, termasuk token penalaran pada model yang menghasilkannya.
- Baca masukan dari cache — konteks berulang yang sudah pernah dilihat penyedia, ditagih jauh lebih rendah daripada masukan baru.
- Tulis cache — yang ditagih sebagian penyedia untuk menaruh konteks itu ke dalam cache pada awalnya.
| Model | Masukan (USD / 1 jt token) | Keluaran (USD / 1 jt token) | Baca masukan dari cache | Tulis cache |
|---|---|---|---|---|
| Claude Haiku 4.5 | 1.00 | 5.00 | 0.10 | 1.25 |
| Claude Sonnet 5 | 2.00 | 10.00 | 0.20 | 2.50 |
| GPT-5.6 Luna | 1.00 | 6.00 | 0.10 | 1.25 |
| GPT-5.6 Terra | 2.50 | 15.00 | 0.25 | 3.125 |
| Kimi k2.5 | 0.60 | 3.00 | 0.10 | 0.60 |
| Qwen3.7 Plus | 0.50 | 3.00 | 0.05 | 0.625 |
| MiniMax-M2.5 | 0.30 | 1.20 | 0.03 | 0.375 |
Token keluaran adalah separuh yang mahal
Pola paling andal dalam harga LLM adalah menulis lebih mahal daripada membaca. Supaya ada angkanya, bukan hanya kesannya, kami mengambil setiap model teks di umpan metadata Oriveo yang menerbitkan harga per token — di seluruh 15 penyedia — lalu membandingkan tarif keluaran tiap model dengan tarif masukannya sendiri, per 24 Juli 2026.
Model pada median menagih keluaran tepat empat kali harga masukan. Sekitar satu dari sepuluh model menagih sama untuk keduanya, atau lebih murah untuk keluaran, yang khas pada model open-weight yang dilayani host inferensi. Di ujung lain, kira-kira satu dari tujuh menagih lebih dari enam kali, dan celah terlebar di umpan ini dua belas kali.
Ini langsung mengubah cara kamu berbelanja. Memangkas prompt adalah optimasi yang paling sering dicoba pertama kali, dan biasanya itu pengungkit yang lebih kecil. Meminta jawaban yang lebih pendek, membatasi panjang keluaran, atau memilih model yang tidak berpikir panjang-panjang akan menggeser tagihan lebih jauh daripada memotong satu paragraf dari pertanyaan. Model penalaran layak dilihat sekali lagi di sini, karena token berpikir yang mereka hasilkan ditagih sebagai keluaran meskipun kamu tidak pernah melihatnya.
| Harga keluaran dibanding harga masukan | Porsi model teks yang dihargai |
|---|---|
| Sama atau lebih murah (1× atau kurang) | 10% |
| 1× sampai 2× | 11% |
| 2× sampai 4× | 39% |
| 4× sampai 6× | 25% |
| Lebih dari 6× | 15% |
Apa yang sebenarnya mendorong tagihanmu
Tagihan API pertama biasanya mengejutkan karena salah satu dari empat alasan, dan tidak satu pun adalah harga judul modelnya. Mekanisme di bawah berlaku untuk setiap penyedia, karena mengikuti cara API chat bekerja, bukan kebijakan vendor mana pun.
Yang terbesar adalah pengiriman ulang konteks. Panggilan API tidak menyimpan keadaan: model tidak ingat giliran sebelumnya, jadi klien harus mengirim ulang seluruh percakapan pada setiap pesan. Utas yang sudah berjalan empat puluh giliran mengirim empat puluh giliran riwayat sebagai masukan pada giliran keempat puluh satu. Karena itu biaya sebuah percakapan tumbuh kira-kira mengikuti kuadrat panjangnya, dan itulah sebabnya satu utas panjang bisa lebih mahal daripada dua puluh utas pendek yang membahas hal yang sama.
Cache prompt adalah penyeimbangnya, dan layak dipahami sebelum kamu mengabaikannya. Penyedia yang mendukungnya menagih konteks yang berulang sebagai pembacaan cache, bukan sebagai masukan baru. Di umpan yang kami ukur, sekitar satu dari lima model menerbitkan harga baca cache, dan bila ada, tarif cache itu berada pada median 10% dari harga masukan model itu sendiri — yang terendah kami temukan di bawah 1%, yang tertinggi sekitar 58%. Sebagian penyedia juga menagih penulisan cache, biasanya lebih mahal daripada masukan biasa, jadi caching baru menguntungkan jika konteks yang sama dipakai ulang beberapa kali, dan tidak jika hanya dipakai sekali.
- Riwayat percakapan — dikirim ulang utuh di setiap giliran, jadi utas panjang biayanya naik tidak proporsional.
- Prompt sistem dan preset — instruksi yang bisa dipakai ulang diletakkan di depan setiap pesan, diam-diam memperbesar jumlah tokennya.
- Lampiran — dokumen atau gambar yang dimasukkan ke obrolan menjadi token masukan, dan tetap berada di konteks untuk setiap giliran berikutnya di utas itu.
- Token penalaran — ditagih sebagai keluaran pada model yang menghasilkannya, baik penalarannya ditampilkan atau tidak.
- Percobaan ulang dan regenerasi — jawaban yang dibuat ulang adalah permintaan penuh kedua yang ditagih, bukan koreksi gratis.
Peta harga di 15 penyedia
Tabel di bawah adalah potret rentang harga masukan yang diterbitkan di masing-masing 15 penyedia yang dihubungkan Oriveo. Tabel ini hanya menghitung model teks yang menerbitkan harga per token, dan menunjukkan yang termurah serta yang termahal di penyedia itu. Ini peta posisi tiap penyedia, bukan rekomendasi: model termurah di suatu penyedia dan yang termahal jarang bisa saling menggantikan.
Sumber dan metodenya, supaya kamu bisa mengecek: setiap angka berasal dari umpan metadata produksi Oriveo di api.oriveoai.com/api/metadata, versi kontrak 47, dibuat 2026-07-24T01:00:09Z — umpan yang sama yang dipakai aplikasi untuk memberi harga pesan, dan yang sama di balik kalkulator biaya di situs ini. Harga dalam dolar AS per juta token, per 24 Juli 2026. Model pembuatan gambar dan model yang dihargai penyedia per permintaan, bukan per token, dikeluarkan, karena angka per token tidak akan berarti untuk mereka.
Dua hal menonjol. Pertama, sebarannya: harga masukan termurah di seluruh umpan adalah $0.01 per juta token dan yang termahal $150, faktor lima belas ribu antara dua baris di pemilih yang sama per 24 Juli 2026. Kedua, keluasan katalog dan kemurahan adalah sumbu yang berbeda — agregator membawa rentang terlebar karena mereka menjual kembali banyak vendor, sementara penyedia tunggal mengelompok rapat di sekitar tingkatan mereka sendiri.
Perlakukan setiap angka di sini sebagai mudah kedaluwarsa. Penyedia mengubah harga, meluncurkan tingkat yang lebih murah, dan memensiunkan model terus-menerus; beberapa baris di bawah berubah dalam kuartal terakhir. Artikel apa pun yang mengutip harga model adalah foto, dan itulah sebabnya umpan langsung serta kalkulator ada, dan halaman ini menyatakan tanggal pengambilannya alih-alih menyiratkan angkanya permanen.
| Penyedia | Model teks dengan harga token yang diterbitkan | Masukan terendah (USD / 1 jt) | Masukan tertinggi (USD / 1 jt) |
|---|---|---|---|
| OpenAI | 49 | 0.05 | 150 |
| Anthropic (Claude) | 10 | 1.00 | 15 |
| Google Gemini | 21 | 0.075 | 2.00 |
| xAI Grok | 6 | 1.00 | 2.00 |
| DeepSeek | 4 | 0.14 | 0.435 |
| Mistral | 32 | 0.04 | 2.00 |
| Qwen | 49 | 0.035 | 2.80 |
| Kimi | 9 | 0.20 | 2.00 |
| MiniMax | 7 | 0.30 | 0.60 |
| Z.ai | 12 | 0.07 | 1.40 |
| Groq | 7 | 0.03 | 0.59 |
| Together AI | 69 | 0.02 | 3.50 |
| Fireworks AI | 15 | 0.07 | 2.80 |
| OpenRouter | 305 | 0.01 | 150 |
| SiliconFlow | 49 | 0.04 | 1.74 |
Mengapa model yang sama punya lebih dari satu harga
Buka dua direktori model dan kamu akan menemukan model yang sama tercantum pada tarif berbeda. Itu biasanya bukan kesalahan. Model open-weight dilayani beberapa host inferensi, masing-masing dengan perangkat keras, throughput, dan margin sendiri, jadi sebuah model sah-sah saja berharga sekian di satu host dan lain di host lain. Di umpan di atas, keluarga open-weight yang sama muncul di beberapa penyedia pada tarif yang benar-benar berbeda.
Alasan kedua adalah lapisan tempat kamu membeli. Agregator duduk di antara kamu dan penyedia di baliknya, dan harus membiayai posisi itu dengan suatu cara — lewat selisih pada harga token, biaya pengisian, persentase pada permintaan, atau sistem kredit yang konversinya ke token ditentukan platform, bukan daftar harga penyedia. Tidak satu pun dari itu buruk dengan sendirinya; yang penting adalah apakah mekanismenya diterbitkan. OpenRouter, misalnya, mendokumentasikan ketentuannya secara terbuka: per 24 Juli 2026, kebijakan yang diterbitkan adalah biaya 5.5% pada pengisian kartu dengan minimum $0.80, dan untuk key yang kamu bawa sendiri, satu juta permintaan pertama tiap bulan tanpa biaya, dengan 5% dari harga normal model dipotong dalam kredit di atas itu.
Ketika kamu membandingkan platform, pertanyaan yang layak diajukan bukan “berapa harga satu kredit”, melainkan “apa rute yang diterbitkan dari harga daftar penyedia ke apa yang ditagihkan kepadamu”. Jika sebuah platform memberi harga dalam kredit dan tidak menerbitkan konversi itu, perbandingan yang kamu buat bukan dengan harga model — melainkan dengan kebijakan harga platform, dan kebijakan itu bisa berubah tanpa harga model berubah sama sekali.
Langganan atau bayar sesuai pemakaian: mana yang lebih murah untukmu
Inilah pertanyaan yang sebenarnya dibawa kebanyakan orang, dan tidak ada jawaban umum. Langganan bulanan tetap dan akses API yang diukur bersilangan pada suatu volume pemakaian, dan titik silang itu bergantung pada pesanmu sendiri: seberapa panjang pesannya, seberapa panjang jawabannya, model mana yang kamu pilih, dan seberapa panjang utasnya berjalan. Siapa pun yang mengutip persentase penghematan tanpa angkamu sedang menebak.
Kamu bisa menghitungnya dalam kira-kira lima menit, dan hitungannya tidak sulit. Ambil pekan yang benar-benar tipikal, bukan yang tersibuk. Hitung pesannya. Perkirakan panjang rata-rata jawaban yang kamu dapat dalam kata, lalu kalikan kira-kira 1.35 untuk mendapat token. Tambahkan sisi masukan, ingat bahwa setiap giliran mengirim ulang utas sejauh ini. Kalikan dengan tarif masukan dan keluaran yang diterbitkan model, lalu bandingkan dengan biaya bulanan yang sedang kamu pertimbangkan. Kalkulator biaya di situs ini menghitungnya dari harga yang sedang berlaku, sehingga kamu tidak harus menyimpan tarifnya sendiri.
Beberapa pola struktural cukup stabil untuk dinyatakan tanpa mengarang angka. Akses yang diukur cenderung menang ketika pemakaian ringan atau melonjak, ketika kamu memakai beberapa model sesekali alih-alih satu secara berat, dan ketika sebagian besar pekerjaanmu adalah pertanyaan pendek dengan jawaban pendek. Langganan cenderung menang pada volume harian yang konsisten tinggi, dan punya keuntungan nonfinansial yang nyata: tagihan yang bisa diprediksi. Akses yang diukur tanpa keterlihatan biaya per pesan adalah yang terburuk dari keduanya, dan persis itulah kegagalan yang hendak dicegah estimasi biaya pada tiap pesan.
Bagaimana benar-benar mengurangi yang kamu belanjakan
Begitu meter-meternya terlihat, sebagian besar penghematan datang dari sejumlah kecil kebiasaan, bukan dari berburu penyedia termurah. Kira-kira menurut seberapa jauh mereka menggerakkan angka, untuk beban obrolan yang tipikal:
Yang biasanya tidak berhasil adalah memindahkan semuanya ke model termurah di katalog. Model yang butuh tiga percobaan untuk mendapat jawaban yang benar pada seperlima harga bukan penghematan, dan itu juga menghabiskan waktumu. Versi yang berguna dari saran ini adalah mencocokkan model dengan tugas — model murah untuk ekstraksi, pemformatan, ringkasan, dan penerjemahan; yang mahal untuk pekerjaan yang tadinya kamu bayar orang untuk mengerjakannya.
- Mulai percakapan baru untuk topik baru. Ini pengungkit terbesar, karena itu menghentikanmu membayar untuk mengirim ulang riwayat yang tidak relevan.
- Minta jawaban yang lebih pendek ketika kamu memang ingin jawaban yang lebih pendek. Keluaran adalah meter yang lebih mahal pada sekitar sembilan dari sepuluh model.
- Cocokkan model dengan tugas, alih-alih selalu memakai yang terkuat untuk segalanya.
- Jaga prompt sistem dan preset yang bisa dipakai ulang tetap ringkas — mereka ditagih pada setiap pesan yang memakainya.
- Pakai cache prompt di tempat penyedia mendukungnya dan kamu memakai ulang konteks panjang yang sama berulang kali.
- Keluarkan lampiran dari utas begitu kamu selesai dengannya, alih-alih membawanya di setiap giliran berikutnya.
- Cek estimasi pada sebuah pesan sebelum mengulang pola itu seratus kali.
Bagaimana Oriveo menampilkan biayanya
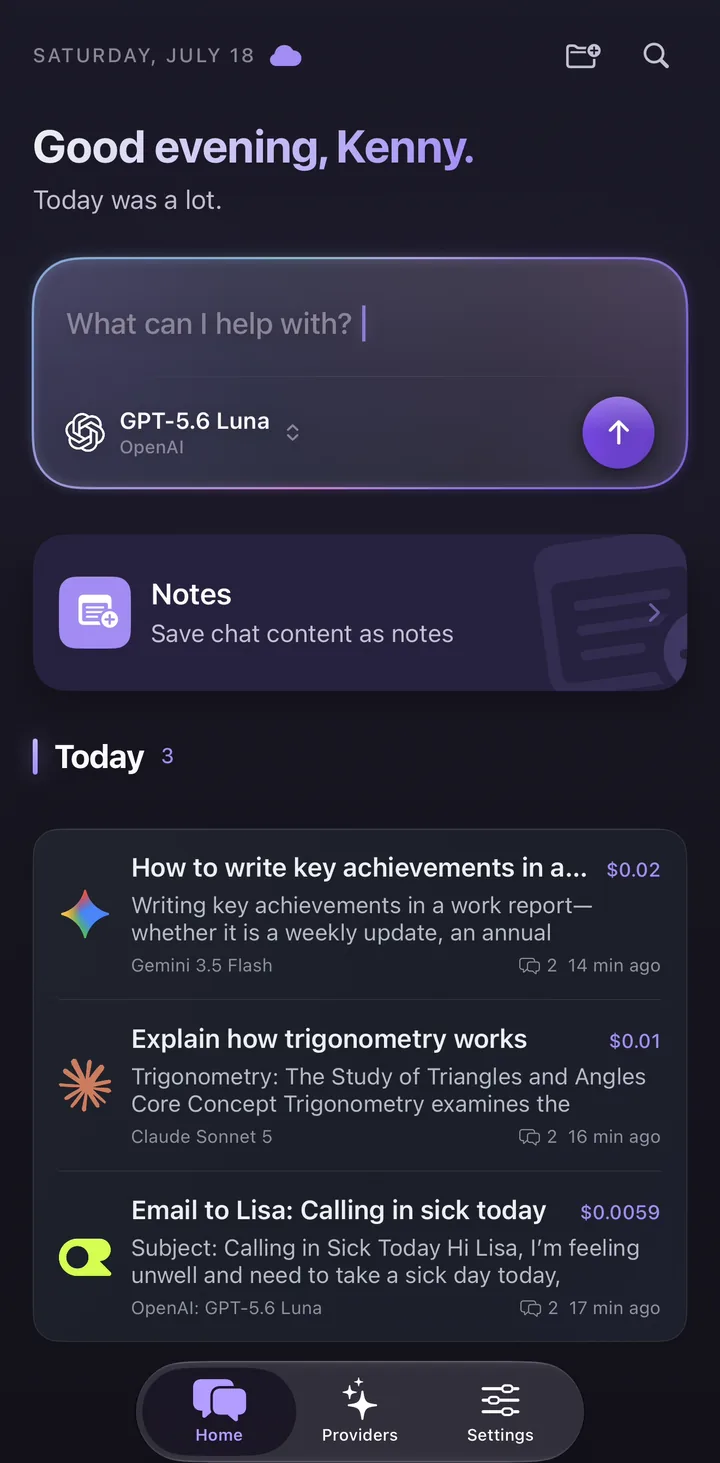
Setiap pesan di Oriveo membawa estimasi biaya, dihitung dari harga token yang diterbitkan penyedia dan token yang benar-benar dilaporkan, pada saat jawaban selesai. Estimasi itu tersedia di setiap tingkat, termasuk yang tanpa akun, karena biaya yang hanya bisa dilihat di paket berbayar tidak membantumu memutuskan apakah perlu membayar apa pun. Umpan metadata yang sama yang dipakai di tabel di atas yang memasok harga-harga itu, dan itulah sebabnya aplikasi tidak mengharuskanmu memelihara daftar harga.
Itu estimasi, dan diberi label sebagai estimasi. Penyedia menerapkan pembulatan, satuan tertagih minimum, tarif per akun, dan harga promosi sesekali mereka sendiri, dan jumlah token dilaporkan penyedia setelah kejadian. Estimasi ada untuk mengarahkan keputusan selama bulan berjalan; tagihan penyedia adalah keputusan akhir, dan ketika keduanya tidak sepakat, tagihanlah yang benar.
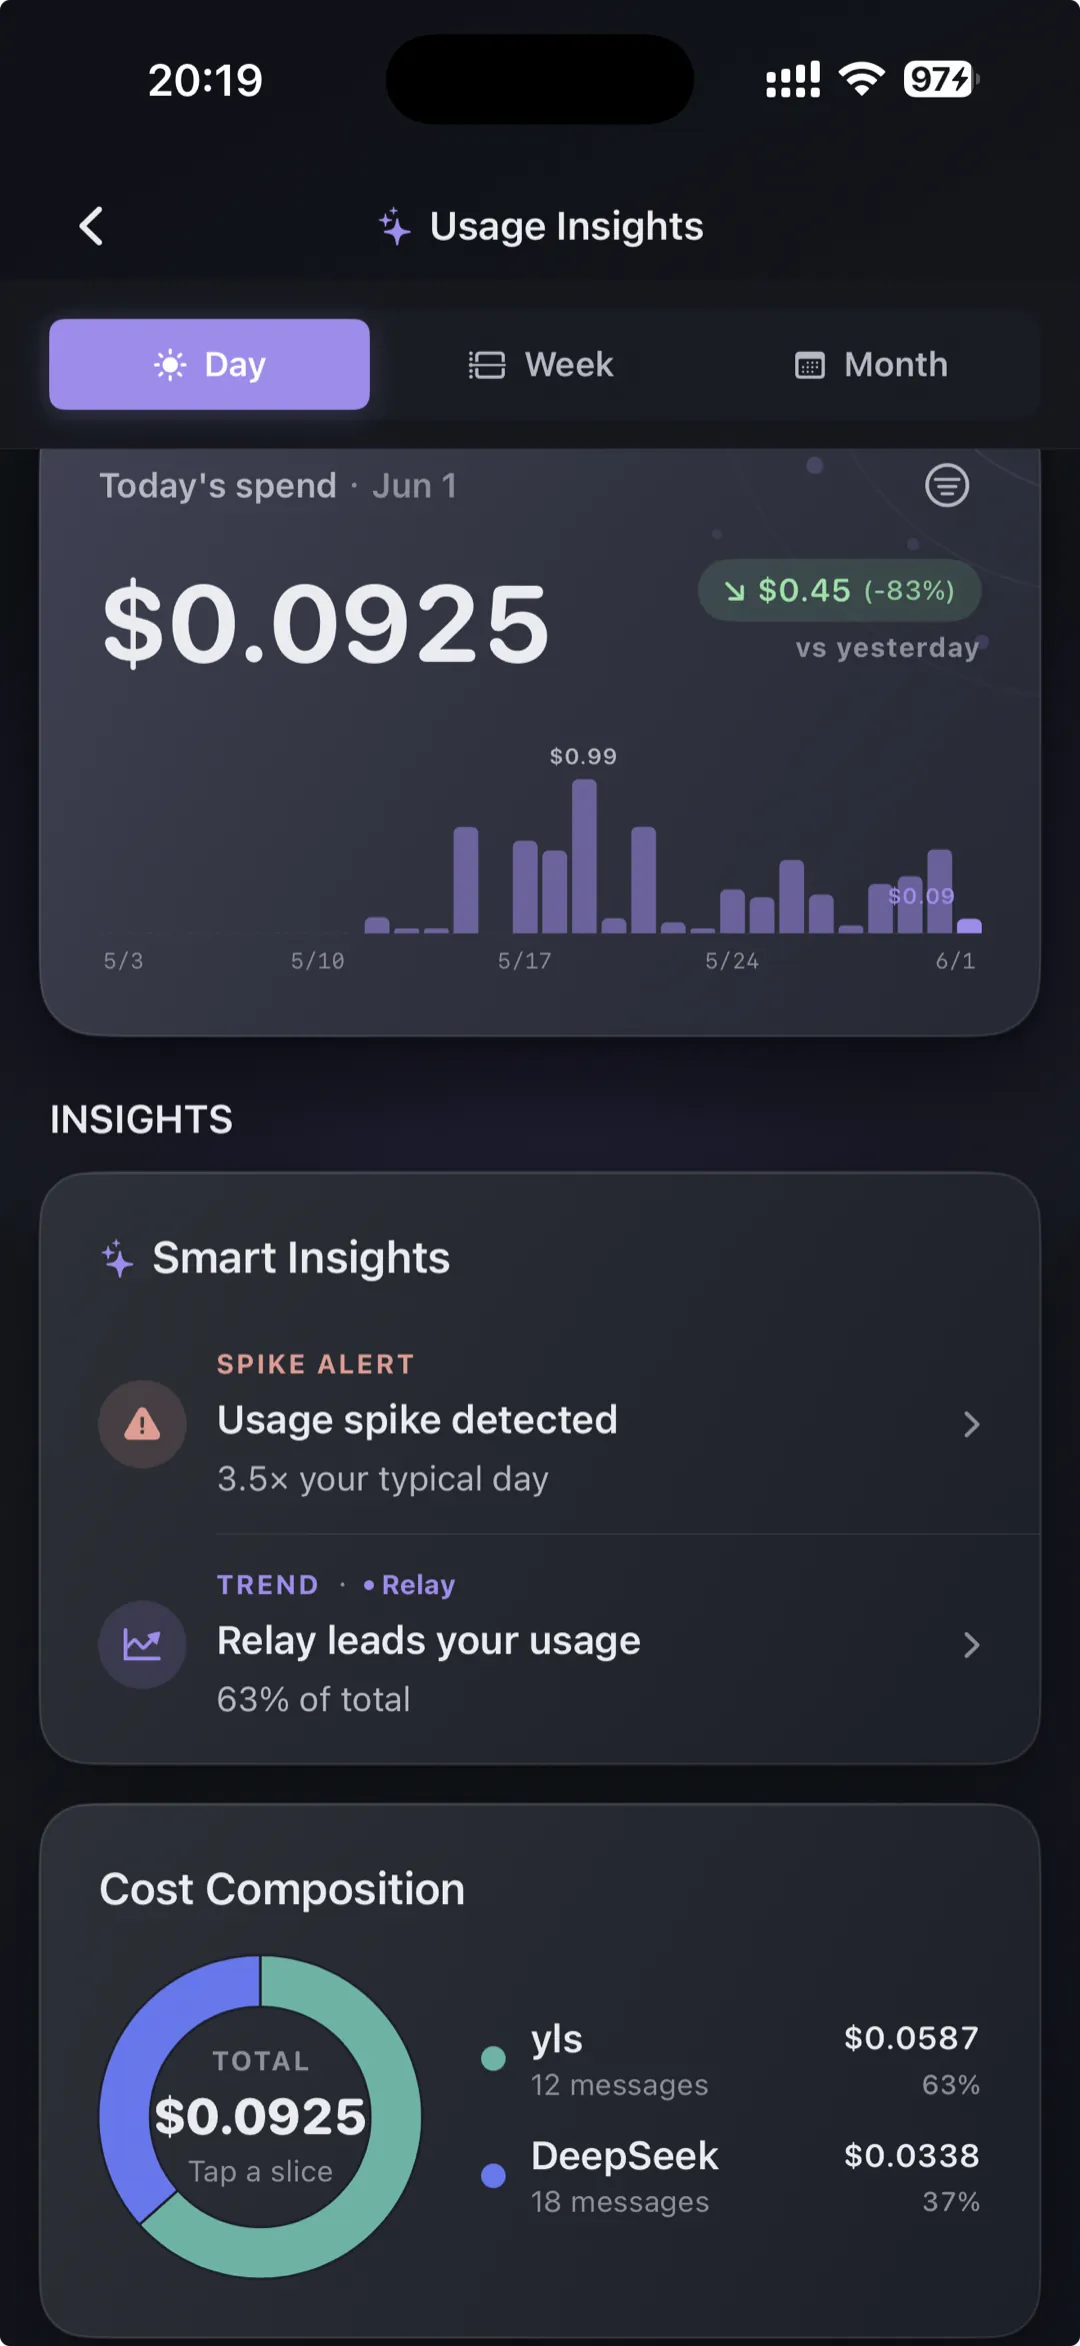
Analisis yang lebih dalam berada di balik paket berbayar. Usage Insights — pengeluaran dipecah per penyedia dan model, tren bulanan, dan peringatan anggaran — adalah bagian Pro dan Lifetime, yang berharga $9.99 sebulan, $59.99 setahun, atau $149.99 sekali bayar per 24 Juli 2026. Paket itu membeli fitur perangkat lunak saja: tidak mencakup pemakaian AI, kredit model, atau langganan penyedia, jadi harga aplikasi dan harga tokenmu tidak pernah digabung menjadi satu angka yang tidak bisa kamu uraikan.
Apa yang tidak bisa diberitahukan angka-angka ini
Tabel harga adalah titik awal, bukan keputusan. Tiga hal yang tidak tercakup di dalamnya layak dikatakan terus terang, karena ketiganya rutin membalik perbandingan yang tampak selesai dari harga saja.
Yang pertama adalah token per tugas. Dua model pada tarif yang sama bisa berbeda jauh dalam berapa banyak token yang mereka habiskan untuk mencapai jawaban yang sama, dan model murah yang bertele-tele bisa lebih mahal per pekerjaan selesai daripada model mahal yang ringkas. Yang kedua adalah tingkat percobaan ulang: jawaban yang harus kamu buat ulang ditagih dua kali. Yang ketiga adalah segala sesuatu di luar meter token — batas laju, latensi, jendela konteks, ketersediaan di wilayahmu, dan apakah model bisa membaca format berkas yang kamu pakai.
Cara jujur memakai perbandingan seperti ini adalah sebagai saringan daftar pendek. Singkirkan baris yang jelas di luar anggaranmu, coba dua atau tiga kandidat pada pekerjaan nyatamu, dan lihat berapa biaya tugas yang selesai, bukan berapa biaya satu juta token. Estimasi per pesan ada persis agar eksperimen ini memakan waktu sehari, bukan satu siklus tagihan.
Pertanyaan yang sering diajukan
Berapa biaya satu pesan ke API LLM sebenarnya?
Mengapa keluaran lebih mahal daripada masukan?
Apakah cache prompt benar-benar mengurangi tagihan?
Apakah API bayar sesuai pemakaian lebih murah daripada langganan AI bulanan?
Mengapa model yang sama berharga berbeda di platform yang berbeda?
Seberapa mutakhir harga dalam artikel ini?
Apakah Oriveo menambah markup di atas yang ditagih penyedia?
Bacaan terkait
Lihat berapa biaya tiap pesan saat kamu mengirimnya
Oriveo menampilkan estimasi biaya pada setiap pesan pada harga daftar penyedia, di 15 penyedia resmi dan 700+ model, di iPhone, Android, dan web — tanpa markup pada pemakaian penyedia.