Comparatif des coûts d’API d’IA : comment les prix des LLM se forment vraiment
De quoi est vraiment fait le prix d’une API de LLM, ce qui fait monter la facture, et la vraie fourchette d’entrée et de sortie chez 15 fournisseurs, mesurée le 24 juillet 2026.
- Les API de LLM facturent jusqu’à quatre compteurs séparés, et la plupart des comparatifs de prix n’en regardent qu’un.
- Les tokens de sortie coûtent, en médiane, quatre fois les tokens d’entrée, et jusqu’à douze fois.
- Les prix d’entrée publiés chez 15 fournisseurs vont de 0,01 $ à 150 $ par million de tokens, au 24 juillet 2026.
Comment le prix d’une API LLM est vraiment construit
Presque chaque comparatif de coûts d’API d’IA cite un nombre par modèle, et ce nombre est presque toujours le prix d’entrée. C’est le moins utile des quatre qu’un fournisseur publie. Un modèle facture sur des compteurs séparés : les tokens que vous envoyez, les tokens qu’il écrit en retour, les tokens lus depuis un cache, et — chez certains fournisseurs — les tokens écrits dans ce cache. Chaque compteur a son tarif, et ces tarifs ne sont pas proches.
Un token vaut à peu près les trois quarts d’un mot anglais, donc un million de tokens approche 750 000 mots. Les prix sont donnés par million de tokens parce que les messages, pris un par un, sont si bon marché qu’un prix au message ne serait que des zéros. Ce cadrage cache à quelle vitesse les compteurs s’additionnent dans une vraie conversation, où chaque tour renvoie tout ce qui a été dit avant.
Le tableau ci-dessous montre les quatre compteurs pour une poignée de modèles, tirés du même flux de métadonnées que le sélecteur de modèles et le calculateur de coût de ce site. La colonne d’entrée dit peu de chose : ici, les prix d’entrée vont de 0,30 à 2,50 $, tandis que les prix de sortie vont de 1,20 à 15,00 $, et c’est la sortie qui bouge le plus.
- Entrée — tout ce que vous envoyez : votre message, la conversation jusque-là, tout prompt système, tout texte joint.
- Sortie — tout ce que le modèle écrit en retour, y compris les tokens de raisonnement sur les modèles qui en produisent.
- Lecture d’entrée en cache — le contexte répété que le fournisseur a déjà vu, facturé bien moins cher qu’une entrée fraîche.
- Écriture de cache — ce que certains fournisseurs facturent pour placer ce contexte dans le cache la première fois.
| Modèle | Entrée (USD / million de tokens) | Sortie (USD / million de tokens) | Lecture d’entrée en cache | Écriture de cache |
|---|---|---|---|---|
| Claude Haiku 4.5 | 1,00 | 5,00 | 0,10 | 1,25 |
| Claude Sonnet 5 | 2,00 | 10,00 | 0,20 | 2,50 |
| GPT-5.6 Luna | 1,00 | 6,00 | 0,10 | 1,25 |
| GPT-5.6 Terra | 2,50 | 15,00 | 0,25 | 3,125 |
| Kimi k2.5 | 0,60 | 3,00 | 0,10 | 0,60 |
| Qwen3.7 Plus | 0,50 | 3,00 | 0,05 | 0,625 |
| MiniMax-M2.5 | 0,30 | 1,20 | 0,03 | 0,375 |
Les tokens de sortie sont la moitié chère
Le motif le plus fiable dans les prix des LLM, c’est qu’écrire coûte plus que lire. Pour mettre un nombre dessus plutôt qu’une impression, on a pris chaque modèle texte du flux de métadonnées d’Oriveo qui publie un prix par token — chez les 15 fournisseurs — et comparé le tarif de sortie de chaque modèle à son propre tarif d’entrée, au 24 juillet 2026.
Le modèle médian facture exactement quatre fois plus la sortie que l’entrée. Environ un modèle sur dix facture la même chose pour les deux, ou moins pour la sortie, ce qui est typique des modèles à poids ouverts servis par des hébergeurs d’inférence. À l’autre bout, environ un sur sept facture plus de six fois, et l’écart le plus large du flux est de douze fois.
Ça change directement la façon dont vous dépensez. Raccourcir le prompt est l’optimisation que tout le monde tente en premier, et c’est en général le plus petit levier. Demander une réponse plus courte, plafonner la longueur de sortie ou choisir un modèle qui ne pense pas longuement à voix haute fera bouger la facture plus que de rogner un paragraphe de la question. Les modèles de raisonnement méritent un second regard : les tokens de réflexion qu’ils génèrent sont facturés comme de la sortie, même quand vous ne les voyez jamais.
| Prix de sortie comparé au prix d’entrée | Part des modèles texte tarifés |
|---|---|
| Identique ou moins cher (1× ou moins) | 10 % |
| 1× à 2× | 11 % |
| 2× à 4× | 39 % |
| 4× à 6× | 25 % |
| Plus de 6× | 15 % |
Ce qui fait vraiment monter la facture
La première facture d’API surprend en général pour l’une de ces quatre raisons, et aucune n’est le prix affiché du modèle. Les mécaniques ci-dessous sont vraies chez chaque fournisseur, parce qu’elles viennent du fonctionnement des API de chat, pas de la politique d’un vendeur.
La plus grosse, c’est le renvoi du contexte. Un appel d’API est sans état : le modèle n’a aucun souvenir du tour précédent, donc le client doit renvoyer toute la conversation avec chaque message. Un fil qui a duré quarante tours envoie quarante tours d’historique en entrée au quarante et unième. Le coût d’une conversation croît donc à peu près avec le carré de sa longueur. C’est pour ça qu’un long fil peut coûter plus que vingt fils courts qui couvrent le même terrain.
Le cache de prompt est le contrepoids, et il vaut d’être compris avant de l’écarter. Les fournisseurs qui le prennent en charge font facturer le contexte répété comme une lecture en cache, et non comme une entrée fraîche. Dans le flux mesuré, environ un modèle sur cinq publie un prix de lecture en cache, et là où il existe le tarif en cache se situe à une médiane de 10 % du propre prix d’entrée de ce modèle. Le plus bas trouvé est sous 1 %, le plus haut autour de 58 %. Certains fournisseurs facturent aussi l’écriture du cache, en général avec une prime sur l’entrée normale. Le cache est donc rentable quand le même contexte est réutilisé plusieurs fois, pas quand il ne sert qu’une fois.
- Historique de conversation — renvoyé en entier à chaque tour, donc les longs fils coûtent de façon disproportionnée.
- Prompts système et presets — des instructions réutilisables sont ajoutées devant chaque message, et multiplient discrètement leur nombre de tokens.
- Pièces jointes — un document ou une image déposé dans un chat devient des tokens d’entrée, et reste dans le contexte à chaque tour suivant de ce fil.
- Tokens de raisonnement — facturés comme de la sortie sur les modèles qui en génèrent, que le raisonnement soit affiché ou non.
- Nouvelles tentatives et régénérations — une réponse régénérée est une seconde requête facturée en entier, pas une correction offerte.
Le paysage des prix chez 15 fournisseurs
Le tableau ci-dessous est un instantané de la fourchette de prix d’entrée publiée chez chacun des 15 fournisseurs auxquels Oriveo se connecte. Il ne compte que les modèles texte qui publient un prix par token, et il montre le moins cher et le plus cher chez ce fournisseur. C’est une carte de l’endroit où chaque fournisseur se situe, pas une recommandation : le modèle le moins cher d’un fournisseur et le plus cher sont rarement interchangeables.
La source et la méthode, pour que vous puissiez vérifier : chaque nombre vient du flux de métadonnées de production d’Oriveo, à api.oriveoai.com/api/metadata, version de contrat 47, généré le 2026-07-24T01:00:09Z. C’est le même flux que l’app utilise pour tarifer les messages, et le même que celui du calculateur de coût de ce site. Les prix sont en dollars US par million de tokens, au 24 juillet 2026. Les modèles de génération d’images, et les modèles que le fournisseur tarife à la requête plutôt qu’au token, sont exclus : un chiffre par token n’aurait pas de sens pour eux.
Deux choses ressortent. D’abord l’écart : le prix d’entrée le plus bas de tout le flux est 0,01 $ par million de tokens, le plus haut est 150 $, soit un facteur de quinze mille entre deux lignes du même sélecteur, au 24 juillet 2026. Ensuite, l’ampleur du catalogue et le bas prix ne sont pas le même axe. Les agrégateurs portent la fourchette la plus large parce qu’ils revendent beaucoup de vendeurs, tandis que les fournisseurs qui ne vendent que leurs propres modèles se regroupent de près autour de leurs paliers.
Traitez chaque nombre ici comme périssable. Les fournisseurs changent leurs prix, lancent des paliers moins chers et retirent des modèles en continu. Plusieurs lignes ci-dessous ont changé au cours du trimestre passé. Un article qui cite des prix de modèles est une photo. C’est pour ça que le flux en direct et le calculateur existent, et que cette page donne sa date de capture au lieu de laisser croire que les nombres sont permanents.
| Fournisseur | Modèles texte avec un prix de token publié | Entrée la plus basse (USD / million) | Entrée la plus haute (USD / million) |
|---|---|---|---|
| OpenAI | 49 | 0,05 | 150 |
| Anthropic (Claude) | 10 | 1,00 | 15 |
| Google Gemini | 21 | 0,075 | 2,00 |
| xAI Grok | 6 | 1,00 | 2,00 |
| DeepSeek | 4 | 0,14 | 0,435 |
| Mistral | 32 | 0,04 | 2,00 |
| Qwen | 49 | 0,035 | 2,80 |
| Kimi | 9 | 0,20 | 2,00 |
| MiniMax | 7 | 0,30 | 0,60 |
| Z.ai | 12 | 0,07 | 1,40 |
| Groq | 7 | 0,03 | 0,59 |
| Together AI | 69 | 0,02 | 3,50 |
| Fireworks AI | 15 | 0,07 | 2,80 |
| OpenRouter | 305 | 0,01 | 150 |
| SiliconFlow | 49 | 0,04 | 1,74 |
Pourquoi le même modèle a plus d’un prix
Ouvrez deux annuaires de modèles et vous trouverez le même modèle à des tarifs différents. Ce n’est en général pas une erreur. Les modèles à poids ouverts sont servis par plusieurs hébergeurs d’inférence, chacun avec son matériel, son débit et sa marge. Un modèle peut donc légitimement coûter une chose chez l’un et autre chose chez l’autre. Dans le flux ci-dessus, la même famille à poids ouverts apparaît chez plusieurs fournisseurs, à des tarifs vraiment différents.
La seconde raison, c’est la couche par laquelle vous achetez. Les agrégateurs se placent entre vous et le fournisseur, et ils doivent financer cette place d’une façon ou d’une autre : un écart sur le prix des tokens, des frais de recharge, un pourcentage sur les requêtes, ou un système de crédits dont la conversion en tokens est définie par la plateforme, pas par la grille du fournisseur. Aucun de ces mécanismes n’est mauvais en soi. Ce qui compte, c’est s’il est publié. OpenRouter, par exemple, documente ses conditions ouvertement. Au 24 juillet 2026, sa politique publiée prévoit des frais de 5,5 % sur les recharges par carte, avec un minimum de 0,80 $, et, pour les clés que vous apportez vous-même, le premier million de requêtes chaque mois sans frais, puis 5 % du prix normal du modèle déduit en crédits au-delà.
Quand vous comparez des plateformes, la question utile n’est pas « combien coûte un crédit », mais « quel chemin publié va du tarif officiel du fournisseur à ce qu’on vous facture ». Si une plateforme tarife en crédits et ne publie pas cette conversion, vous ne comparez pas le prix du modèle. Vous comparez la politique tarifaire de la plateforme, et cette politique peut changer sans que le prix du modèle bouge.
Abonnement ou paiement à l’usage : lequel vous coûte moins
C’est la question avec laquelle la plupart des gens arrivent, et elle n’a pas de réponse générale. Un abonnement mensuel forfaitaire et un accès API au compteur se croisent à un certain volume, et ce point dépend de vos messages : leur longueur, la longueur des réponses, le modèle que vous choisissez, et la durée de vos fils. Quelqu’un qui cite un pourcentage d’économie sans vos nombres est en train de deviner.
Vous pouvez le calculer en cinq minutes environ, et l’arithmétique n’est pas dure. Prenez une semaine vraiment typique, pas votre plus chargée. Comptez les messages. Estimez la longueur moyenne des réponses en mots, et multipliez par environ 1,35 pour obtenir des tokens. Ajoutez le côté entrée, en vous rappelant que chaque tour renvoie le fil jusque-là. Multipliez par les tarifs d’entrée et de sortie publiés du modèle, et comparez ça au forfait mensuel que vous envisagez. Le calculateur de coût de ce site le fait avec des prix en direct, pour que vous n’ayez pas à tenir les tarifs vous-même.
Quelques motifs sont assez stables pour être dits sans inventer de nombres. L’accès au compteur tend à gagner quand l’usage est léger ou en pics, quand vous utilisez plusieurs modèles de temps en temps plutôt qu’un seul lourdement, et quand une grande part du travail, ce sont de courtes questions avec de courtes réponses. Les abonnements tendent à gagner quand le volume quotidien est élevé et régulier, et ils ont un vrai avantage qui n’est pas financier : une facture prévisible. L’accès au compteur sans visibilité sur le coût par message est le pire des deux. C’est exactement le travers qu’une estimation de coût sur chaque message sert à éviter.
Comment réduire vraiment ce que vous dépensez
Une fois que vous voyez les compteurs, la plupart des économies viennent d’un petit nombre d’habitudes, pas de la chasse au fournisseur le moins cher. Dans l’ordre approximatif de ce qui fait bouger le chiffre, pour un usage de chat typique :
Ce qui ne marche en général pas, c’est de tout basculer vers le modèle le moins cher du catalogue. Un modèle qui a besoin de trois essais pour obtenir une bonne réponse, à un cinquième du prix, n’est pas une économie, et il vous coûte le temps en plus. La version utile du conseil, c’est d’assortir le modèle à la tâche : des modèles bon marché pour l’extraction, la mise en forme, le résumé et la traduction, des modèles chers pour le travail que vous auriez payé quelqu’un à faire.
- Ouvrez une nouvelle conversation pour un nouveau sujet. C’est le plus grand levier, parce que vous cessez de payer le renvoi d’un historique hors sujet.
- Demandez des réponses plus courtes quand vous en voulez une plus courte. La sortie est le compteur le plus cher sur environ neuf modèles sur dix.
- Assortissez le modèle à la tâche, au lieu de prendre par défaut le plus fort pour tout.
- Gardez les prompts système et les presets réutilisables serrés : ils sont facturés sur chaque message qui les utilise.
- Utilisez le cache de prompt là où le fournisseur le prend en charge, et là où vous réutilisez le même long contexte plusieurs fois.
- Retirez les pièces jointes d’un fil une fois que vous en avez fini, au lieu de les traîner à chaque tour suivant.
- Regardez l’estimation sur un message avant de répéter ce schéma cent fois.
Comment Oriveo vous montre le coût
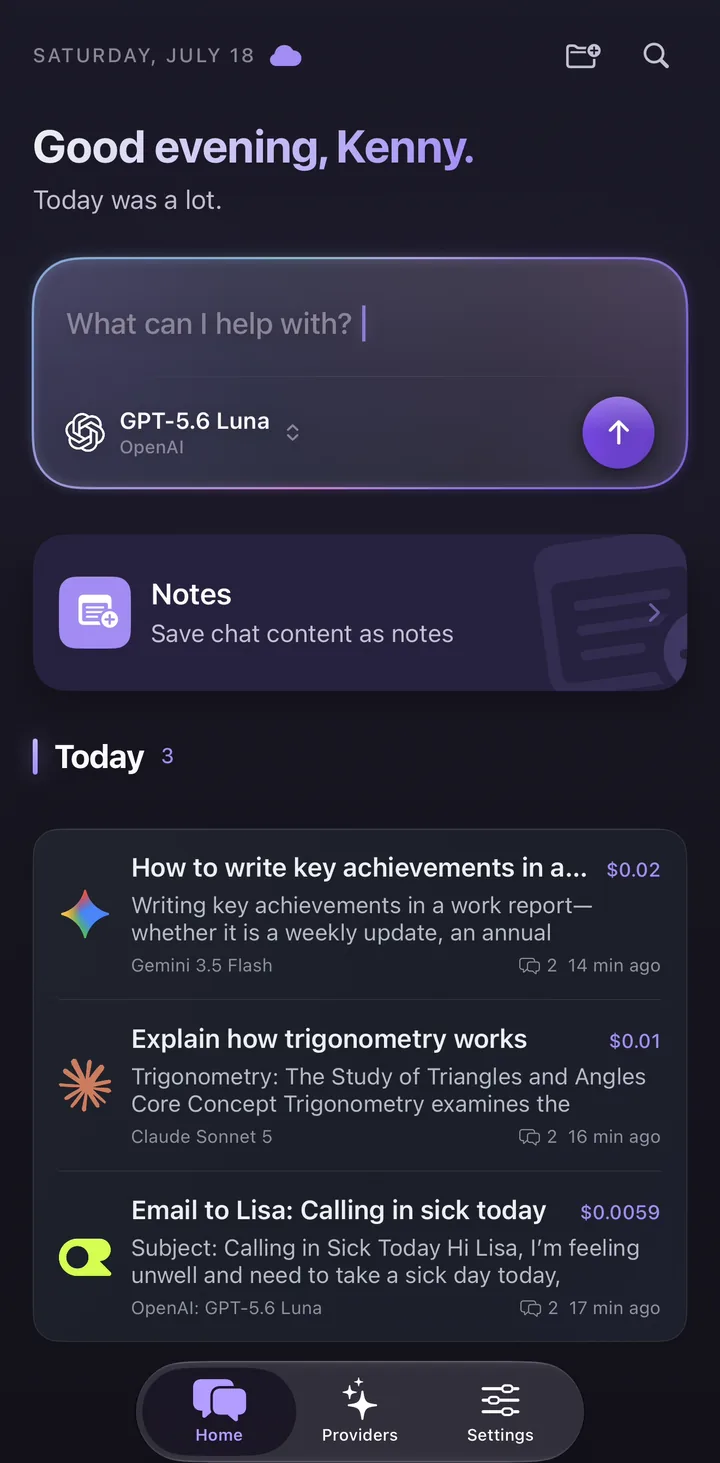
Chaque message dans Oriveo porte un coût estimé, calculé à partir du prix des tokens publié par le fournisseur et des tokens réellement rapportés, au moment où la réponse se termine. Cette estimation est là sur toutes les offres, y compris sans inscription : un coût que vous ne voyez que sur un plan payant ne vous aide pas à décider si vous devez payer quoi que ce soit. Le même flux de métadonnées que les tableaux ci-dessus fournit ces prix. L’app n’a donc pas besoin que vous teniez une grille vous-même.
C’est une estimation, et elle est étiquetée comme telle. Les fournisseurs appliquent leurs propres arrondis, leurs unités minimales facturables, des tarifs par compte et, de temps en temps, des prix promotionnels. Les comptes de tokens sont rapportés par le fournisseur après coup. L’estimation sert à orienter les décisions pendant le mois. La facture de votre fournisseur a le dernier mot, et quand les deux divergent, c’est la facture qui a raison.
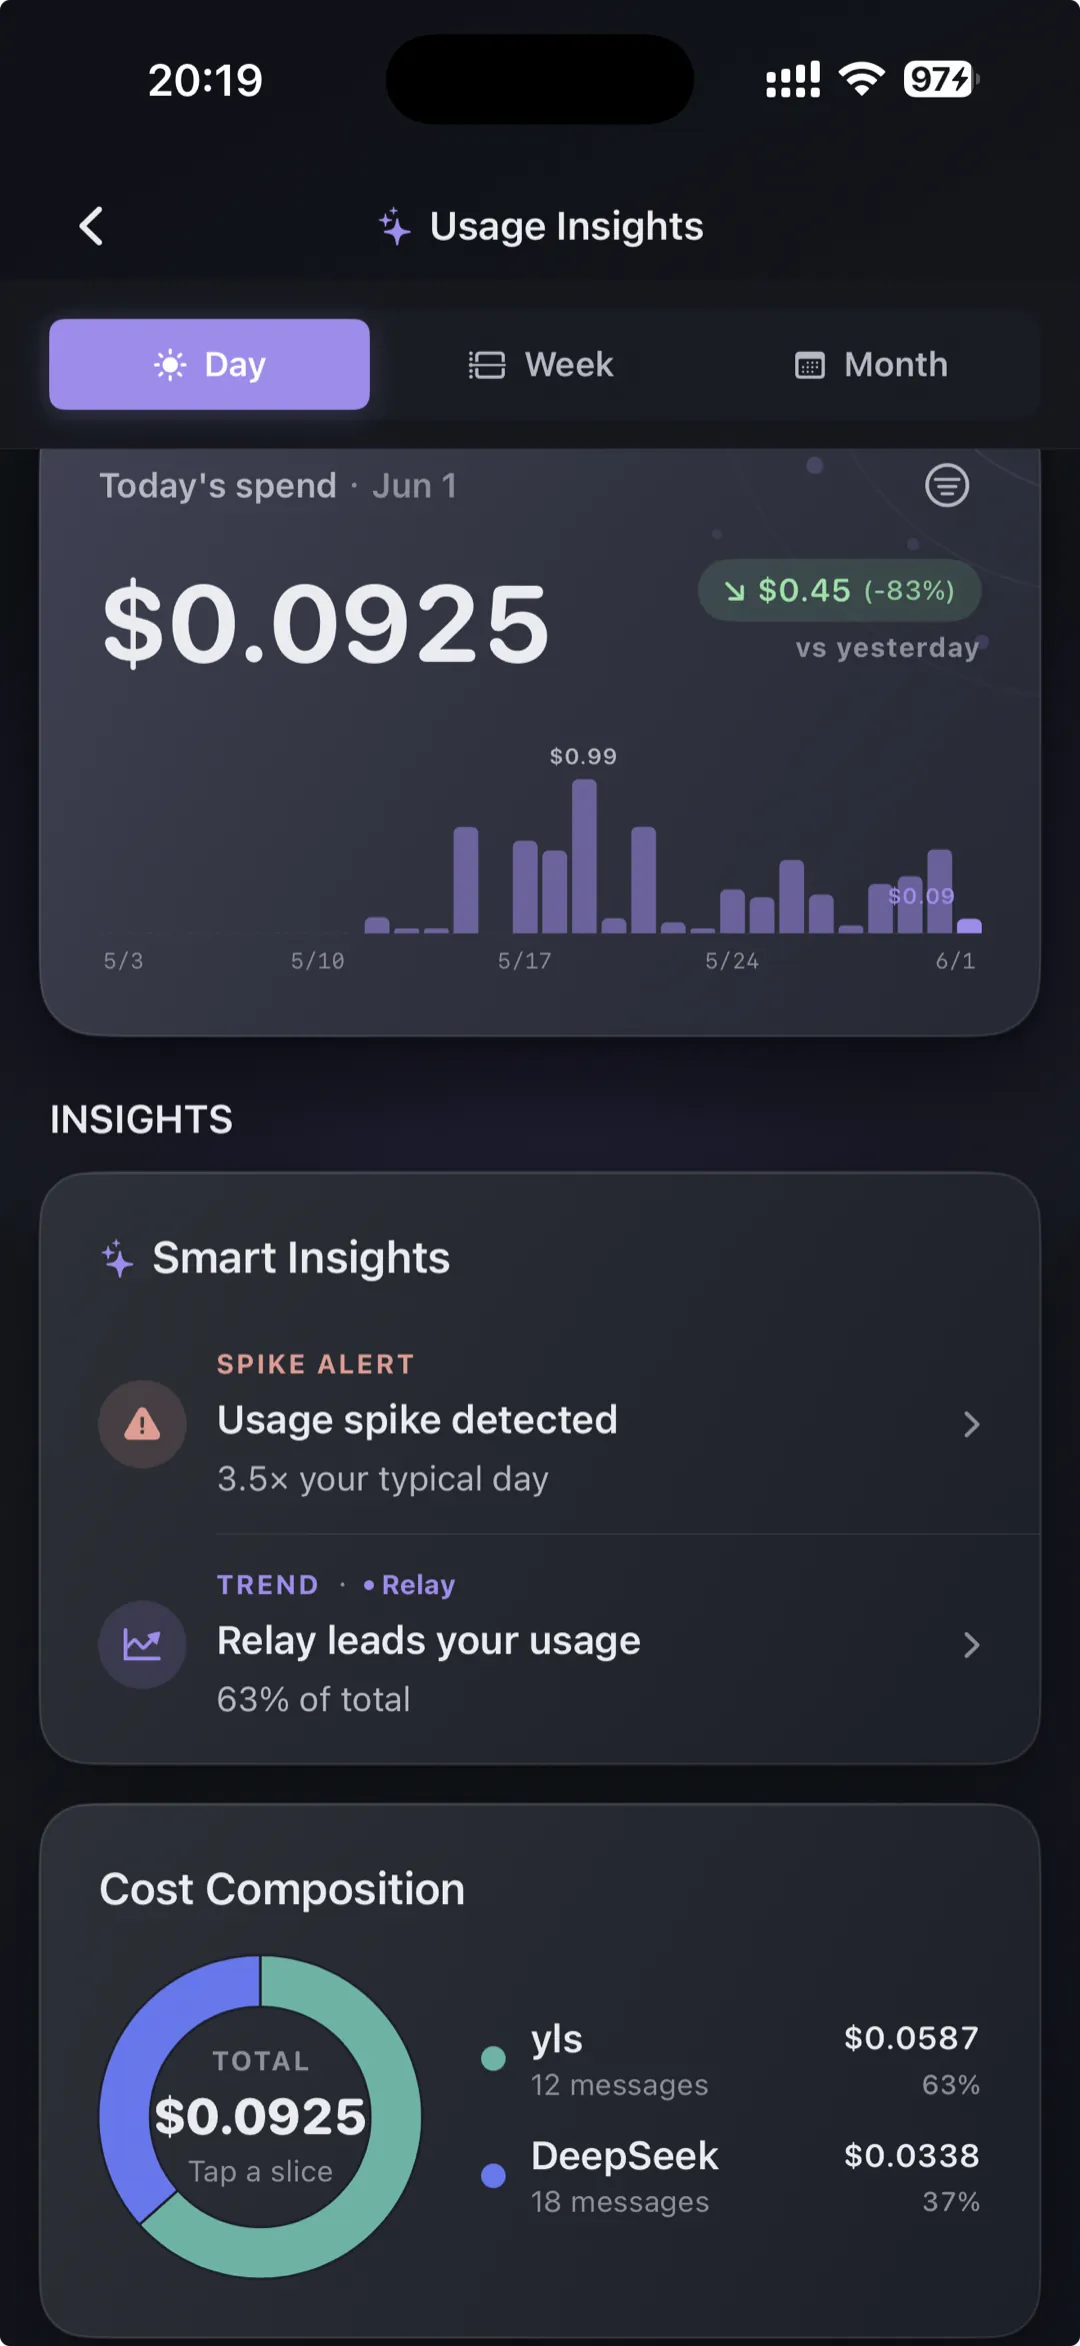
L’analyse plus poussée est derrière les plans payants. Usage Insights — les dépenses ventilées par fournisseur et par modèle, les tendances mensuelles et les alertes de budget — fait partie de Pro et Lifetime, à 9,99 $ par mois, 59,99 $ par an ou 149,99 $ une fois, au 24 juillet 2026. Ces plans n’achètent que des fonctions logicielles. Ils n’incluent aucun usage d’IA, aucun crédit de modèle et aucun abonnement de fournisseur. Le prix de l’app et le prix de vos tokens ne sont donc jamais fondus dans un seul nombre que vous ne pouvez pas défaire.
Ce que ces nombres ne peuvent pas vous dire
Un tableau de prix est un point de départ, pas une décision. Trois choses qu’il laisse de côté valent d’être dites, parce qu’elles inversent souvent une comparaison qui semblait réglée sur le seul prix.
La première, ce sont les tokens par tâche. Deux modèles au même tarif peuvent différer nettement dans le nombre de tokens qu’ils dépensent pour arriver à la même réponse, et un modèle bon marché mais verbeux peut coûter plus, par travail fini, qu’un modèle cher et bref. La deuxième, c’est le taux de nouvelles tentatives : une réponse que vous devez régénérer est facturée deux fois. La troisième, c’est tout ce qui est hors du compteur de tokens — limites de débit, latence, fenêtre de contexte, disponibilité dans votre région, et si le modèle sait lire les formats de fichiers avec lesquels vous travaillez.
La façon honnête d’utiliser un comparatif comme celui-ci, c’est comme un filtre de sélection. Écartez les lignes clairement hors de votre budget, essayez deux ou trois candidats sur votre vrai travail, et regardez ce que coûte une tâche finie plutôt que ce que coûte un million de tokens. L’estimation par message existe pour que cette expérience prenne une journée, pas un cycle de facturation.
Questions fréquentes
Combien coûte vraiment un message vers une API de LLM ?
Pourquoi la sortie est-elle plus chère que l’entrée ?
Le cache de prompt réduit-il vraiment la facture ?
Une API au paiement à l’usage est-elle moins chère qu’un abonnement d’IA mensuel ?
Pourquoi le même modèle coûte-t-il des montants différents selon la plateforme ?
Les prix de cet article sont-ils à jour ?
Oriveo ajoute-t-il une majoration à ce que facturent les fournisseurs ?
À lire aussi
Voyez ce que coûte chaque message au moment où vous l’envoyez
Oriveo montre un coût estimé sur chaque message, au tarif officiel du fournisseur, chez 15 fournisseurs officiels et plus de 700 modèles, sur iPhone, Android et le web — sans majoration sur l’usage du fournisseur.