Comparativa de costos de API de IA: cómo se cobra de verdad
De qué está hecho el precio de una API de LLM, qué mueve la factura y el rango real de entrada y salida en 15 proveedores, medido el 24 de julio de 2026.
- Las API de LLM cobran hasta en cuatro contadores distintos, y la mayoría de las comparativas de precio solo mira uno.
- Los tokens de salida cuestan, en la mediana, cuatro veces lo que cuestan los de entrada, y hasta doce veces.
- Los precios de entrada publicados en 15 proveedores van de $0.01 a $150 por millón de tokens a 24 de julio de 2026.
Cómo funciona de verdad el precio de una API de LLM
Casi todas las comparativas de costos de API de IA citan un número por modelo, y ese número es casi siempre el precio de entrada. Es el menos útil de los cuatro números que publica un proveedor. Un modelo cobra en contadores separados: los tokens que envías, los tokens que escribe de vuelta, los tokens leídos de una caché y, con algunos proveedores, los tokens escritos en esa caché. Cada contador tiene su propia tarifa, y las tarifas no se parecen entre sí.
Un token es más o menos tres cuartos de una palabra en inglés, así que un millón de tokens anda cerca de 750,000 palabras. Los precios se cotizan por millón de tokens porque los mensajes sueltos son tan baratos que un precio por mensaje sería todo ceros. Ese encuadre esconde lo rápido que se suman los contadores en una conversación real, donde cada turno reenvía todo lo dicho antes.
La tabla de abajo muestra los cuatro contadores para un puñado de modelos, tomados del mismo feed de metadatos que alimenta el selector de modelos y la calculadora de costos de este sitio. Fíjate en lo poco que te dice la columna de entrada: aquí los precios de entrada van de 0.30 a 2.50 dólares, pero los de salida van de 1.20 a 15.00, y la salida es el contador que más se mueve.
- Entrada: todo lo que envías. Tu mensaje, la conversación hasta ahí, cualquier prompt de sistema, cualquier texto adjunto.
- Salida: todo lo que el modelo escribe de vuelta, incluidos los tokens de razonamiento en los modelos que los producen.
- Lectura de entrada en caché: contexto repetido que el proveedor ya ha visto, cobrado a una tarifa mucho más baja que la entrada nueva.
- Escritura en caché: lo que algunos proveedores cobran por colocar ese contexto en la caché la primera vez.
| Modelo | Entrada (USD / 1M de tokens) | Salida (USD / 1M de tokens) | Lectura de entrada en caché | Escritura en caché |
|---|---|---|---|---|
| Claude Haiku 4.5 | 1.00 | 5.00 | 0.10 | 1.25 |
| Claude Sonnet 5 | 2.00 | 10.00 | 0.20 | 2.50 |
| GPT-5.6 Luna | 1.00 | 6.00 | 0.10 | 1.25 |
| GPT-5.6 Terra | 2.50 | 15.00 | 0.25 | 3.125 |
| Kimi k2.5 | 0.60 | 3.00 | 0.10 | 0.60 |
| Qwen3.7 Plus | 0.50 | 3.00 | 0.05 | 0.625 |
| MiniMax-M2.5 | 0.30 | 1.20 | 0.03 | 0.375 |
Los tokens de salida son la mitad cara
El patrón más fiable del precio de los LLM es que escribir cuesta más que leer. Para ponerle un número y no una impresión, tomamos todos los modelos de texto del feed de metadatos de Oriveo que publican un precio por token —en los 15 proveedores— y comparamos la tarifa de salida de cada modelo con su propia tarifa de entrada, a 24 de julio de 2026.
El modelo mediano cobra exactamente cuatro veces más por la salida que por la entrada. Alrededor de un modelo de cada diez cobra lo mismo por ambas, o menos por la salida, lo habitual en los modelos de pesos abiertos servidos por hosts de inferencia. En el otro extremo, más o menos uno de cada siete cobra más de seis veces, y la brecha más ancha del feed está en doce veces.
Esto tiene una consecuencia directa en cómo gastas. Recortar el prompt es la optimización a la que todo el mundo llega primero, y suele ser la palanca más pequeña. Pedir una respuesta más corta, limitar la longitud de salida o elegir un modelo que no piense en voz alta y largo mueve una factura más que quitarle un párrafo a la pregunta. Los modelos de razonamiento merecen una segunda mirada aquí, porque los tokens de pensamiento que generan se cobran como salida aunque nunca los veas.
| Precio de salida comparado con el de entrada | Parte de los modelos de texto con precio |
|---|---|
| Igual o más barato (1× o menos) | 10% |
| De 1× a 2× | 11% |
| De 2× a 4× | 39% |
| De 4× a 6× | 25% |
| Más de 6× | 15% |
Qué es lo que de verdad mueve tu factura
La gente suele sorprenderse con su primera factura de API por una de cuatro razones, y ninguna es el precio de portada del modelo. La mecánica de abajo es cierta en todos los proveedores, porque sale de cómo funcionan las API de chat y no de la política de ningún vendedor.
La más grande es el reenvío del contexto. Una llamada a la API no tiene estado: el modelo no recuerda tu turno anterior, así que el cliente tiene que reenviar toda la conversación con cada mensaje. Un hilo que lleva cuarenta turnos envía cuarenta turnos de historial como entrada en el turno cuarenta y uno. El costo de una conversación crece por tanto más o menos con el cuadrado de su longitud, y por eso un hilo largo puede costar más que veinte cortos que cubran el mismo terreno.
La caché de prompts es el contrapeso, y conviene entenderla antes de descartarla. Los proveedores que la admiten dejan que el contexto repetido se cobre como una lectura en caché en vez de como entrada nueva. En el feed que medimos, alrededor de un modelo de cada cinco publica un precio de lectura en caché, y donde existe la tarifa en caché se sitúa en una mediana del 10% del propio precio de entrada de ese modelo: lo más bajo que encontramos está por debajo del 1%, y lo más alto ronda el 58%. Algunos proveedores también cobran por escribir la caché, normalmente con un sobreprecio respecto a la entrada normal, así que la caché compensa cuando el mismo contexto se reutiliza varias veces y no cuando se usa una sola.
- Historial de la conversación: se reenvía entero en cada turno, así que los hilos largos cuestan desproporcionadamente más.
- Prompts de sistema y ajustes: las instrucciones reutilizables se anteponen a cada mensaje, y multiplican en silencio su conteo de tokens.
- Adjuntos: un documento o una imagen soltados en un chat se convierten en tokens de entrada, y se quedan en el contexto de cada turno posterior de ese hilo.
- Tokens de razonamiento: se cobran como salida en los modelos que los generan, se muestre o no el razonamiento.
- Reintentos y regeneraciones: una respuesta regenerada es una segunda solicitud cobrada entera, no una corrección gratis.
El mapa de precios en 15 proveedores
La tabla de abajo es una foto del rango de precio de entrada publicado en cada uno de los 15 proveedores a los que se conecta Oriveo. Cuenta solo modelos de texto que publican un precio por token, y muestra el más barato y el más caro de ellos en ese proveedor. Es un mapa de dónde se sienta cada proveedor, no una recomendación: el modelo más barato de un proveedor y el más caro rara vez se sustituyen entre sí.
Fuente y método, para que puedas comprobarlo: cada número sale del feed de metadatos de producción de Oriveo en api.oriveoai.com/api/metadata, versión de contrato 47, generado el 2026-07-24T01:00:09Z. Es el mismo feed que usa la app para ponerle precio a los mensajes y el mismo que hay detrás de la calculadora de costos de este sitio. Los precios están en dólares estadounidenses por millón de tokens, a 24 de julio de 2026. Quedan fuera los modelos de generación de imágenes y los modelos que el proveedor cobra por solicitud y no por token, porque una cifra por token no significaría nada para ellos.
Destacan dos cosas. La primera es la dispersión: el precio de entrada más barato de todo el feed es $0.01 por millón de tokens y el más caro es $150, un factor de quince mil entre dos filas del mismo selector a 24 de julio de 2026. La segunda es que la amplitud del catálogo y la baratura son ejes distintos: los agregadores llevan el rango más ancho porque revenden a muchos vendedores, mientras que los proveedores de un solo vendedor se agrupan muy juntos alrededor de su propia escala de niveles.
Trata cada número de aquí como algo que caduca. Los proveedores cambian los precios, lanzan niveles más baratos y retiran modelos sin parar; varias de las filas de abajo cambiaron en el último trimestre. Cualquier artículo que cite precios de modelos es una foto, y por eso existen el feed en vivo y la calculadora, y por eso esta página declara la fecha de la captura en vez de dar a entender que los números son permanentes.
| Proveedor | Modelos de texto con precio por token publicado | Entrada más baja (USD / 1M) | Entrada más alta (USD / 1M) |
|---|---|---|---|
| OpenAI | 49 | 0.05 | 150 |
| Anthropic (Claude) | 10 | 1.00 | 15 |
| Google Gemini | 21 | 0.075 | 2.00 |
| xAI Grok | 6 | 1.00 | 2.00 |
| DeepSeek | 4 | 0.14 | 0.435 |
| Mistral | 32 | 0.04 | 2.00 |
| Qwen | 49 | 0.035 | 2.80 |
| Kimi | 9 | 0.20 | 2.00 |
| MiniMax | 7 | 0.30 | 0.60 |
| Z.ai | 12 | 0.07 | 1.40 |
| Groq | 7 | 0.03 | 0.59 |
| Together AI | 69 | 0.02 | 3.50 |
| Fireworks AI | 15 | 0.07 | 2.80 |
| OpenRouter | 305 | 0.01 | 150 |
| SiliconFlow | 49 | 0.04 | 1.74 |
Por qué el mismo modelo tiene más de un precio
Abre dos directorios de modelos y encontrarás el mismo modelo listado a tarifas distintas. Normalmente no es un error. Los modelos de pesos abiertos los sirven varios hosts de inferencia, cada uno con su hardware, su rendimiento y su margen, así que un modelo puede costar legítimamente una cosa en un host y otra en otro. En el feed de arriba, la misma familia de pesos abiertos aparece en varios proveedores a tarifas de verdad distintas.
La segunda razón es la capa a través de la que compras. Los agregadores se interponen entre tú y el proveedor de debajo, y tienen que financiar esa posición de algún modo: con un diferencial sobre el precio de los tokens, una comisión de recarga, un porcentaje sobre las solicitudes, o un sistema de créditos cuya conversión a tokens la define la plataforma y no la lista de precios del proveedor. Nada de eso es malo de por sí; lo que importa es si el mecanismo está publicado. OpenRouter, por ejemplo, documenta sus condiciones abiertamente: a 24 de julio de 2026 su política publicada es una comisión del 5.5% en las recargas con tarjeta, con un mínimo de $0.80, y, para las claves que traes tú, el primer millón de solicitudes de cada mes sin cargo, y a partir de ahí un 5% del precio normal del modelo descontado en créditos.
Cuando comparas plataformas, la pregunta que vale la pena no es «cuánto vale un crédito», sino «cuál es la ruta publicada desde el precio de lista de un proveedor hasta lo que me cobran». Si una plataforma pone precios en créditos y no publica esa conversión, la comparación que estás haciendo no es con el precio del modelo: es con la política de precios de la plataforma, y esa política puede cambiar sin que el precio del modelo cambie en absoluto.
Suscripción o pago por uso: qué te sale más barato
Esta es la pregunta con la que llega de verdad la mayoría, y no tiene una respuesta general. Una suscripción mensual plana y el acceso a la API por consumo se cruzan en algún volumen de uso, y ese punto de cruce depende de tus propios mensajes: qué tan largos son tus mensajes, qué tan largas son las respuestas, qué modelo eliges y cuánto duran tus hilos. Quien cite un porcentaje de ahorro sin tus números está adivinando.
Puedes calcularlo en unos cinco minutos, y la aritmética no es difícil. Toma una semana de verdad típica, no la más ocupada. Cuenta los mensajes. Estima la longitud media de las respuestas que recibes, en palabras, y multiplica por aproximadamente 1.35 para obtener tokens. Suma el lado de entrada, recordando que cada turno reenvía el hilo hasta ahí. Multiplica por las tarifas publicadas de entrada y de salida del modelo, y compáralo con la cuota mensual que estás considerando. La calculadora de costos de este sitio hace esto contra precios en vivo, para que no tengas que guardar tú las tarifas.
Unos pocos patrones estructurales son lo bastante estables como para decirlos sin inventar números. El acceso por consumo suele ganar cuando el uso es ligero o a rachas, cuando usas varios modelos de vez en cuando en vez de uno con intensidad, y cuando gran parte del trabajo son preguntas cortas con respuestas cortas. Las suscripciones suelen ganar con un volumen diario alto y constante, y tienen una ventaja real que no es de dinero: una factura predecible. El acceso por consumo sin visibilidad del costo por mensaje es lo peor de las dos, y ese es exactamente el fallo que una estimación de costo en cada mensaje pretende evitar.
Cómo reducir de verdad lo que gastas
Cuando ya ves los contadores, la mayor parte del ahorro sale de un puñado de hábitos y no de cazar al proveedor más barato. En el orden aproximado de cuánto mueven el número, para una carga típica de chat:
Lo que no suele funcionar es pasarlo todo al modelo más barato del catálogo. Un modelo que necesita tres intentos para acertar una respuesta a un quinto del precio no es un ahorro, y además te cuesta el tiempo. La versión útil de este consejo es emparejar modelo y tarea: modelos baratos para extraer, dar formato, resumir y traducir, y los caros para el trabajo por el que le habrías pagado a una persona.
- Empieza una conversación nueva para un tema nuevo. Es la palanca más grande, porque deja de hacerte pagar por reenviar un historial que no viene a cuento.
- Pide respuestas más cortas cuando quieres una respuesta más corta. La salida es el contador más caro en unos nueve modelos de cada diez.
- Empareja el modelo con la tarea, en vez de dejar por defecto el más fuerte para todo.
- Mantén cortos los prompts de sistema y los ajustes reutilizables: se cobran en cada mensaje que los usa.
- Usa la caché de prompts donde el proveedor la admita y reutilices el mismo contexto largo una y otra vez.
- Quita los adjuntos de un hilo cuando ya hayas terminado con ellos, en vez de arrastrarlos en cada turno posterior.
- Mira la estimación de un mensaje antes de repetir ese patrón cien veces.
Cómo te enseña Oriveo el costo
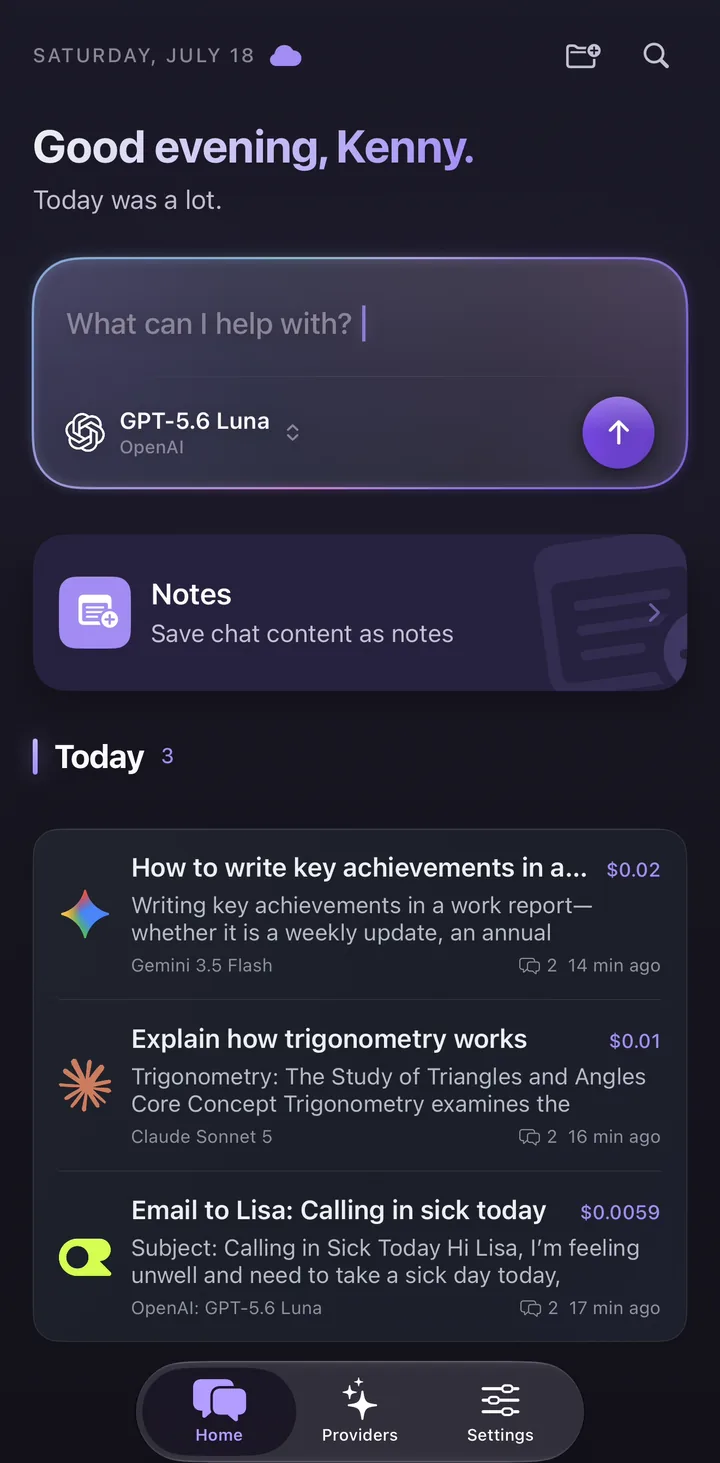
Cada mensaje en Oriveo lleva un costo estimado, calculado a partir del precio por token publicado del proveedor y de los tokens realmente reportados, en el momento en que termina la respuesta. Esa estimación está en todos los niveles, incluido el que no pide iniciar sesión, porque un costo que solo puedes ver en un plan de pago no te ayuda a decidir si pagar por algo. El mismo feed de metadatos usado en las tablas de arriba es el que suministra esos precios, y por eso la app no necesita que tú mantengas una lista de precios.
Es una estimación y está etiquetada como tal. Los proveedores aplican su propio redondeo, unidades mínimas facturables, tarifas por cuenta y precios promocionales de vez en cuando, y los conteos de tokens los reporta el proveedor a posteriori. La estimación está para orientar decisiones durante el mes; la factura de tu proveedor es la última palabra, y cuando las dos no coinciden, manda la factura.
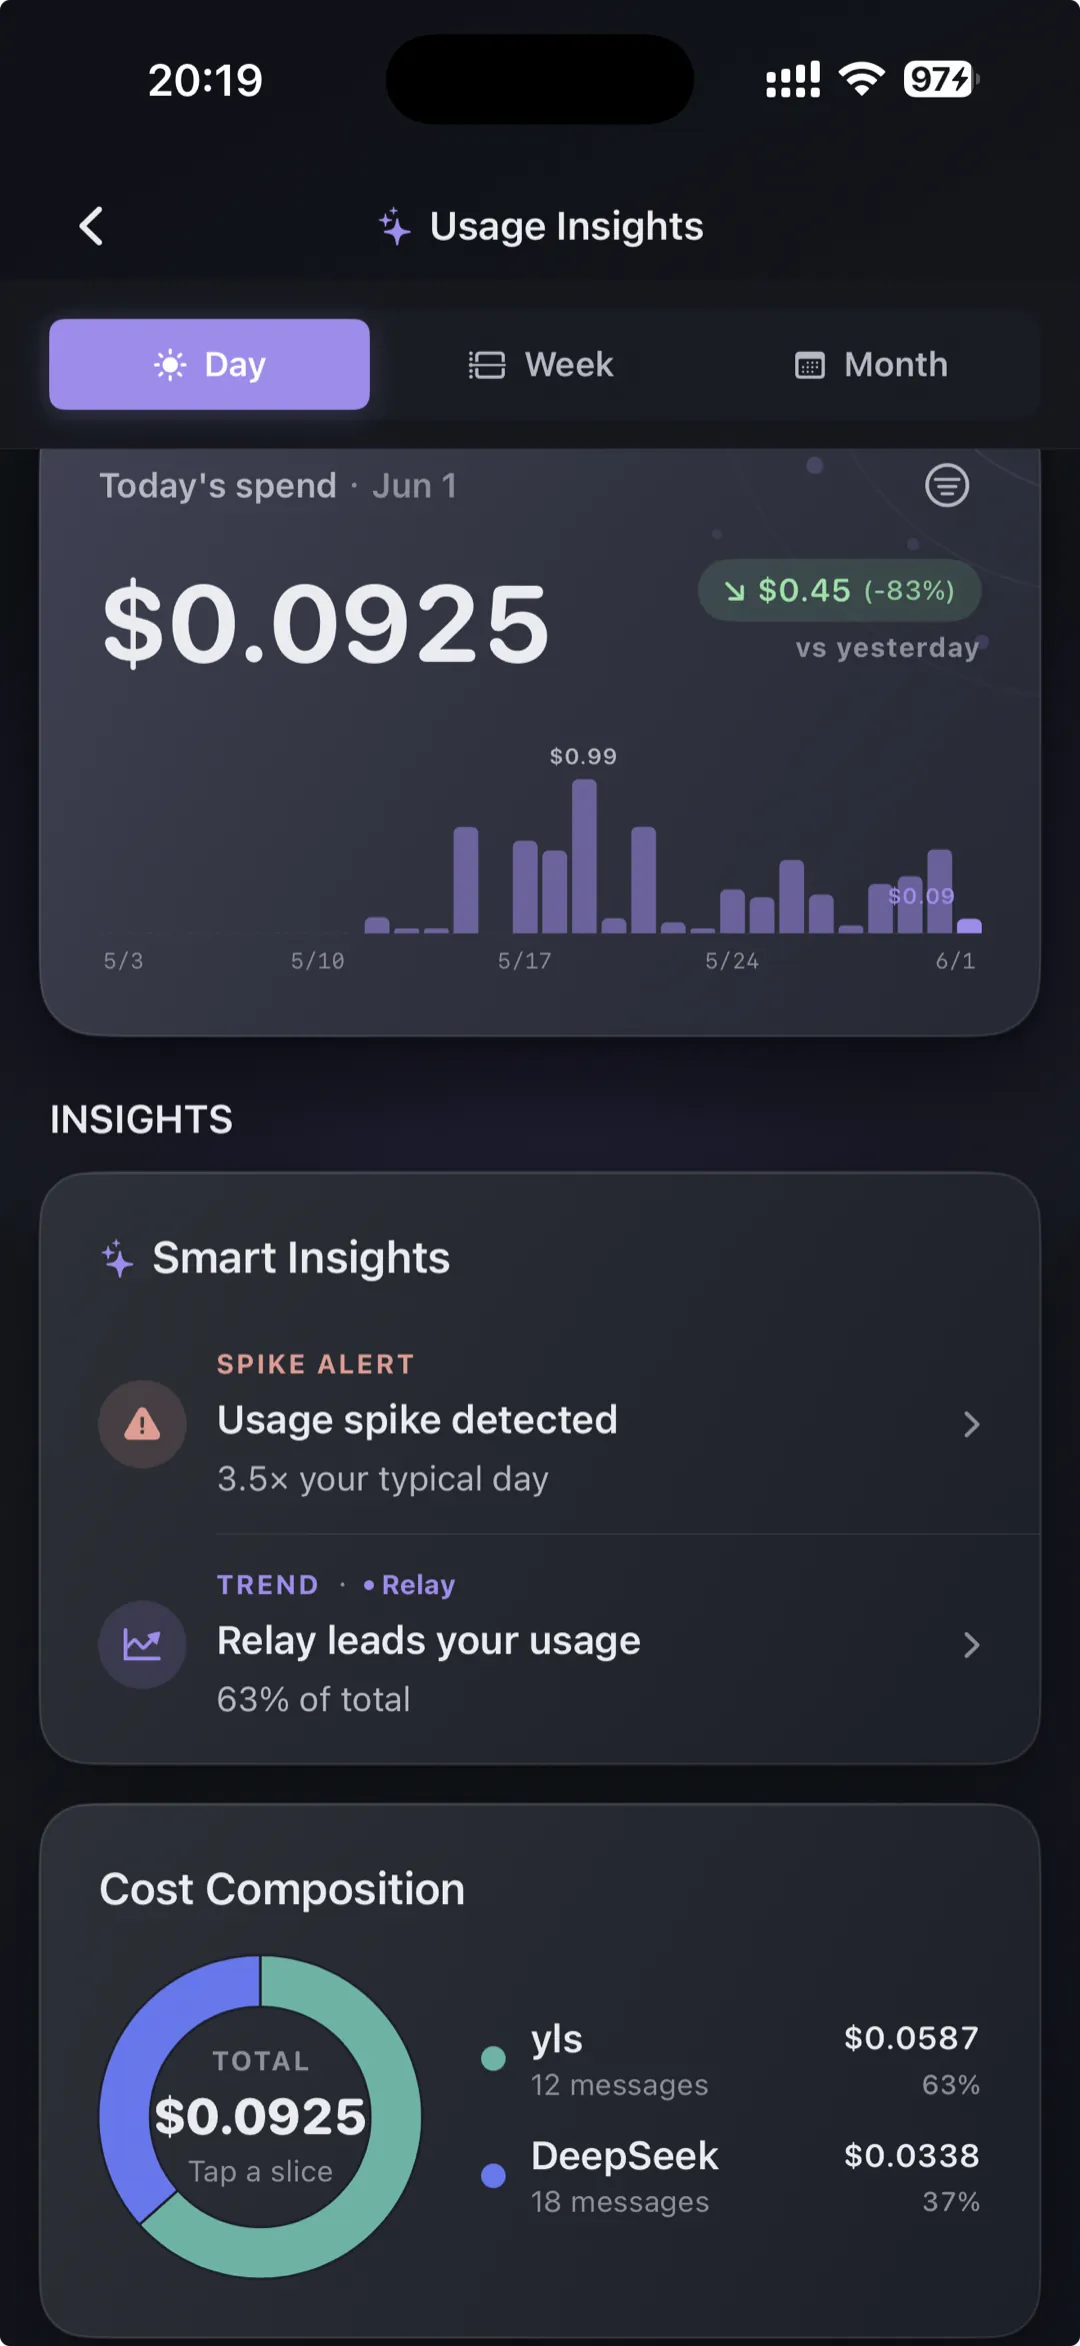
El análisis más a fondo está detrás de los planes de pago. Usage Insights —el gasto desglosado por proveedor y modelo, las tendencias mensuales y las alertas de presupuesto— forma parte de Pro y Lifetime, que cuestan $9.99 al mes, $59.99 al año o $149.99 de una vez a 24 de julio de 2026. Esos planes compran solo funciones de software: no incluyen uso de IA, ni créditos de modelo, ni suscripción de proveedor, así que el precio de la app y el precio de tus tokens nunca se empaquetan en un número que no puedas separar.
Lo que estos números no pueden decirte
Una tabla de precios es un punto de partida, no una decisión. Tres cosas que deja fuera conviene decirlas con claridad, porque a menudo dan la vuelta a una comparación que parecía cerrada solo con el precio.
La primera es los tokens por tarea. Dos modelos a la misma tarifa pueden diferir bastante en cuántos tokens gastan para llegar a la misma respuesta, y un modelo barato y verboso puede costar más por trabajo terminado que uno caro y escueto. La segunda es la tasa de reintento: una respuesta que tienes que regenerar se cobra dos veces. La tercera es todo lo que está fuera del contador de tokens: límites de ritmo, latencia, ventana de contexto, disponibilidad en tu región, y si el modelo puede leer los formatos de archivo con los que trabajas.
La forma honesta de usar una comparación como esta es como filtro para acortar la lista. Descarta las filas que están claramente fuera de tu presupuesto, prueba dos o tres candidatos con tu trabajo real, y mira lo que cuesta una tarea terminada y no lo que cuesta un millón de tokens. La estimación por mensaje existe precisamente para que este experimento lleve un día y no un ciclo de facturación.
Preguntas frecuentes
¿Cuánto cuesta de verdad un mensaje a una API de LLM?
¿Por qué la salida es más cara que la entrada?
¿La caché de prompts reduce de verdad la factura?
¿Una API de pago por uso sale más barata que una suscripción mensual de IA?
¿Por qué el mismo modelo cuesta importes distintos en plataformas distintas?
¿Qué tan actuales son los precios de este artículo?
¿Oriveo agrega un recargo a lo que cobran los proveedores?
Lecturas relacionadas
Mira lo que cuesta cada mensaje al enviarlo
Oriveo muestra un costo estimado en cada mensaje al precio de lista del proveedor, en 15 proveedores oficiales y 700+ modelos, en iPhone, Android y la web, sin recargo sobre el uso del proveedor.