So sánh chi phí API AI: giá LLM thực sự tính thế nào
Giá API của LLM gồm những gì, thứ gì đẩy hóa đơn lên, và khoảng giá đầu vào cùng đầu ra thật trên 15 nhà cung cấp, đo ngày 24 tháng 7 năm 2026.
- API của LLM tính trên tối đa bốn khoản tính phí riêng, còn phần lớn bài so giá chỉ nhìn một khoản tính phí.
- Token đầu ra có giá trung vị gấp bốn lần token đầu vào, và có thể lên tới mười hai lần.
- Trên 15 nhà cung cấp, giá đầu vào đã công bố chạy từ $0.01 tới $150 cho mỗi triệu token, tính đến ngày 24 tháng 7 năm 2026.
Giá API của LLM thực sự tính thế nào
Hầu hết bài so chi phí API AI đều nêu một con số cho mỗi mô hình, và con số đó gần như luôn là giá đầu vào. Trong bốn con số mà một nhà cung cấp công bố, đó là con số ít hữu ích nhất. Một mô hình tính trên các khoản tính phí tách riêng: token bạn gửi vào, token nó viết ra, token đọc từ cache, và với một số nhà cung cấp, token ghi vào cache đó. Mỗi khoản có mức giá riêng, và các mức đó không gần nhau.
Một token tương đương khoảng ba phần tư từ tiếng Anh, nên một triệu token vào khoảng 750.000 từ. Giá được báo theo mỗi triệu token vì từng tin nhắn rẻ tới mức giá theo tin sẽ toàn số 0. Cách nói đó che mất việc các khoản tính phí cộng dồn nhanh thế nào trong một cuộc trò chuyện thật, nơi mỗi lượt gửi lại mọi thứ đã nói trước đó.
Bảng bên dưới hiện cả bốn khoản tính phí cho một vài mô hình, lấy từ cùng nguồn metadata đang chạy bộ chọn mô hình và máy tính chi phí trên trang này. Hãy xem cột đầu vào ít nói được điều gì: giá đầu vào ở đây chỉ từ 0,30 đến 2,50 đô la, còn giá đầu ra trải từ 1,20 đến 15,00 đô la, và đầu ra mới là khoản tính phí nhảy mạnh nhất.
- Đầu vào: mọi thứ bạn gửi, gồm tin nhắn của bạn, cuộc trò chuyện tới lúc đó, mọi prompt hệ thống, mọi văn bản đính kèm.
- Đầu ra: mọi thứ mô hình viết lại, kể cả token suy luận trên các mô hình có sinh ra chúng.
- Đọc đầu vào từ cache: phần ngữ cảnh lặp lại mà nhà cung cấp đã thấy, tính ở mức thấp hơn nhiều so với đầu vào mới.
- Ghi cache: khoản một số nhà cung cấp tính để đưa ngữ cảnh đó vào cache ngay từ đầu.
| Mô hình | Đầu vào (USD / 1 triệu token) | Đầu ra (USD / 1 triệu token) | Đọc đầu vào từ cache | Ghi cache |
|---|---|---|---|---|
| Claude Haiku 4.5 | 1.00 | 5.00 | 0.10 | 1.25 |
| Claude Sonnet 5 | 2.00 | 10.00 | 0.20 | 2.50 |
| GPT-5.6 Luna | 1.00 | 6.00 | 0.10 | 1.25 |
| GPT-5.6 Terra | 2.50 | 15.00 | 0.25 | 3.125 |
| Kimi k2.5 | 0.60 | 3.00 | 0.10 | 0.60 |
| Qwen3.7 Plus | 0.50 | 3.00 | 0.05 | 0.625 |
| MiniMax-M2.5 | 0.30 | 1.20 | 0.03 | 0.375 |
Token đầu ra là nửa đắt
Quy luật đáng tin nhất trong giá LLM là viết đắt hơn đọc. Để có một con số chứ không phải một ấn tượng, chúng tôi lấy mọi mô hình văn bản trong nguồn metadata của Oriveo có công bố giá theo token, trên cả 15 nhà cung cấp, rồi so mức đầu ra của từng mô hình với chính mức đầu vào của nó, tính đến ngày 24 tháng 7 năm 2026.
Mô hình ở mức trung vị tính đầu ra đắt gấp bốn lần đầu vào. Khoảng một mô hình trên mười tính hai đầu bằng nhau, hoặc đầu ra còn rẻ hơn, kiểu thường gặp ở mô hình trọng số mở do các máy chủ suy luận phục vụ. Ở đầu kia, khoảng một trên bảy tính hơn sáu lần, và khoảng cách rộng nhất trong nguồn là mười hai lần.
Điều này đổi thẳng cách bạn tiêu tiền. Cắt prompt là tối ưu đầu tiên ai cũng nghĩ tới, và thường là đòn bẩy nhỏ hơn. Xin một câu trả lời ngắn hơn, giới hạn độ dài đầu ra, hoặc chọn một mô hình không nghĩ thành tiếng dài dòng, sẽ giảm hóa đơn nhiều hơn là gọt bớt một đoạn trong câu hỏi. Các mô hình suy luận đáng để bạn để ý ở đây, vì token suy nghĩ chúng sinh ra được tính là đầu ra ngay cả khi bạn không nhìn thấy.
| Giá đầu ra so với giá đầu vào | Tỷ lệ mô hình văn bản có giá |
|---|---|
| Bằng hoặc rẻ hơn (1 lần trở xuống) | 10% |
| Từ 1 lần tới 2 lần | 11% |
| Từ 2 lần tới 4 lần | 39% |
| Từ 4 lần tới 6 lần | 25% |
| Hơn 6 lần | 15% |
Thứ gì thực sự đẩy hóa đơn của bạn
Người ta thường ngạc nhiên với hóa đơn API đầu tiên vì một trong bốn lý do, và không lý do nào là giá tiêu đề của mô hình. Cơ chế bên dưới đúng với mọi nhà cung cấp, vì chúng xuất phát từ cách API chat hoạt động, không phải từ chính sách của một hãng.
Thứ lớn nhất là việc gửi lại ngữ cảnh. Một lời gọi API không giữ trạng thái: mô hình không nhớ lượt trước của bạn, nên client phải gửi lại cả cuộc trò chuyện với mỗi tin nhắn. Một luồng đã chạy bốn mươi lượt sẽ gửi bốn mươi lượt lịch sử làm đầu vào ở lượt bốn mươi mốt. Chi phí một cuộc trò chuyện vì thế tăng gần như theo bình phương độ dài của nó. Đó là lý do một luồng dài có thể đắt hơn hai mươi luồng ngắn xử lý cùng một việc.
Cache prompt là đối trọng, và đáng hiểu trước khi bạn gạt nó đi. Các nhà cung cấp hỗ trợ nó cho phép ngữ cảnh lặp lại được tính như một lần đọc cache thay vì đầu vào mới. Trong nguồn chúng tôi đo, khoảng một mô hình trên năm công bố giá đọc cache, và chỗ nào có thì mức cache nằm ở mức trung vị 10% giá đầu vào của chính mô hình đó. Mức thấp nhất chúng tôi thấy là dưới 1%, mức cao nhất quanh 58%. Một số nhà cung cấp còn tính phí để ghi cache, thường cao hơn đầu vào thường, nên cache mới có lời khi cùng một ngữ cảnh được dùng lại vài lần, không phải khi chỉ dùng một lần.
- Lịch sử trò chuyện: được gửi lại đầy đủ ở mỗi lượt, nên luồng dài đắt lệch hẳn.
- Prompt hệ thống và mẫu sẵn: những chỉ dẫn dùng lại được gắn vào trước mỗi tin nhắn, lặng lẽ nhân số token của chúng.
- Tệp đính kèm: một tài liệu hoặc ảnh thả vào chat thành token đầu vào, và ở lại trong ngữ cảnh cho mọi lượt sau của luồng đó.
- Token suy luận: được tính là đầu ra trên các mô hình sinh ra chúng, dù phần suy luận có được hiện hay không.
- Thử lại và tạo lại: một câu trả lời tạo lại là một yêu cầu bị tính phí trọn vẹn lần thứ hai, không phải một lần sửa miễn phí.
Bức tranh giá trên 15 nhà cung cấp
Bảng bên dưới là một ảnh chụp khoảng giá đầu vào đã công bố ở từng nhà cung cấp trong 15 nhà cung cấp mà Oriveo nối tới. Nó chỉ đếm mô hình văn bản có công bố giá theo token, và hiện mô hình rẻ nhất và đắt nhất của nhà cung cấp đó. Đây là bản đồ chỗ mỗi nhà cung cấp đứng, không phải lời khuyên: mô hình rẻ nhất và đắt nhất của một nhà cung cấp hiếm khi thay được cho nhau.
Nguồn và cách làm, để bạn tự kiểm: mọi con số đến từ nguồn metadata sản xuất của Oriveo tại api.oriveoai.com/api/metadata, contract version 47, sinh lúc 2026-07-24T01:00:09Z. Đó cũng là nguồn ứng dụng dùng để định giá tin nhắn, và là nguồn đứng sau máy tính chi phí trên trang này. Giá tính bằng đô la Mỹ cho mỗi triệu token, tính đến ngày 24 tháng 7 năm 2026. Các mô hình tạo ảnh và các mô hình tính theo yêu cầu thay vì theo token bị loại ra, vì một con số theo token với chúng sẽ vô nghĩa.
Hai điều nổi lên. Thứ nhất là khoảng giá dàn rất rộng: giá đầu vào rẻ nhất trong cả nguồn là $0.01 mỗi triệu token và đắt nhất là $150, chênh mười lăm nghìn lần giữa hai hàng trong cùng một bộ chọn, tính đến ngày 24 tháng 7 năm 2026. Thứ hai là độ rộng danh mục và độ rẻ là hai trục khác nhau. Các bên tổng hợp mang khoảng rộng nhất vì họ bán lại nhiều hãng, còn nhà cung cấp một hãng thì tụ chặt quanh các bậc giá của chính họ.
Hãy coi mọi con số ở đây là dễ hết hạn. Nhà cung cấp đổi giá, mở bậc rẻ hơn và ngừng mô hình liên tục. Vài hàng bên dưới đã đổi trong quý vừa rồi. Bất kỳ bài nào trích giá mô hình cũng chỉ là một bức ảnh. Vì thế mới cần nguồn sống và máy tính, và vì thế trang này ghi ngày chụp thay vì ngầm hiểu các con số là vĩnh viễn.
| Nhà cung cấp | Mô hình văn bản có giá token đã công bố | Đầu vào thấp nhất (USD / 1 triệu) | Đầu vào cao nhất (USD / 1 triệu) |
|---|---|---|---|
| OpenAI | 49 | 0.05 | 150 |
| Anthropic (Claude) | 10 | 1.00 | 15 |
| Google Gemini | 21 | 0.075 | 2.00 |
| xAI Grok | 6 | 1.00 | 2.00 |
| DeepSeek | 4 | 0.14 | 0.435 |
| Mistral | 32 | 0.04 | 2.00 |
| Qwen | 49 | 0.035 | 2.80 |
| Kimi | 9 | 0.20 | 2.00 |
| MiniMax | 7 | 0.30 | 0.60 |
| Z.ai | 12 | 0.07 | 1.40 |
| Groq | 7 | 0.03 | 0.59 |
| Together AI | 69 | 0.02 | 3.50 |
| Fireworks AI | 15 | 0.07 | 2.80 |
| OpenRouter | 305 | 0.01 | 150 |
| SiliconFlow | 49 | 0.04 | 1.74 |
Vì sao cùng một mô hình có hơn một giá
Mở hai danh mục mô hình và bạn sẽ thấy cùng một mô hình được liệt kê ở các mức khác nhau. Đó thường không phải lỗi. Mô hình trọng số mở được nhiều máy chủ suy luận phục vụ, mỗi máy có phần cứng, thông lượng và biên lợi nhuận riêng, nên một mô hình hoàn toàn hợp lệ khi có giá này trên máy nọ, giá khác trên máy kia. Trong nguồn phía trên, cùng một họ trọng số mở xuất hiện ở vài nhà cung cấp với các mức thực sự khác nhau.
Lý do thứ hai là lớp trung gian bạn mua qua. Các bên tổng hợp ngồi giữa bạn và nhà cung cấp bên dưới, và phải kiếm tiền từ vị trí đó bằng cách nào đó: một khoản chênh trên giá token, một phí nạp, một phần trăm trên yêu cầu, hoặc một hệ credit mà cách đổi sang token do nền tảng định nghĩa chứ không phải do bảng giá của nhà cung cấp. Không cách nào trong số đó xấu sẵn. Điều quan trọng là cơ chế có được công bố hay không. Ví dụ, OpenRouter công bố điều khoản công khai: tính đến ngày 24 tháng 7 năm 2026, chính sách đã công bố của họ là phí 5,5% khi nạp bằng thẻ với mức tối thiểu $0.80, và với key riêng của bạn, một triệu yêu cầu đầu tiên mỗi tháng không tính phí, vượt mức đó thì trừ 5% giá thường của mô hình bằng credit.
Khi bạn so các nền tảng, câu đáng hỏi không phải “một credit giá bao nhiêu” mà là “con đường đã công bố từ giá niêm yết của nhà cung cấp tới số tôi bị tính là gì”. Nếu một nền tảng tính bằng credit mà không công bố cách quy đổi đó, thì thứ bạn đang so không phải giá của mô hình. Bạn đang so chính sách giá của nền tảng, và chính sách đó có thể đổi mà giá của mô hình không đổi chút nào.
Thuê bao hay trả theo mức dùng: cái nào rẻ hơn với bạn
Đây là câu hỏi mà phần lớn người ta thực sự mang theo, và nó không có câu trả lời chung. Một thuê bao tháng cố định và quyền vào API tính theo mức dùng cắt nhau ở một lượng dùng nào đó, và điểm cắt đó tùy tin nhắn của chính bạn: chúng dài bao nhiêu, câu trả lời dài bao nhiêu, bạn chọn mô hình nào, và luồng của bạn chạy bao lâu. Ai nêu một phần trăm tiết kiệm mà không có số của bạn thì đang đoán.
Bạn tự tính được trong khoảng năm phút, và phép tính không khó. Lấy một tuần thực sự điển hình, không phải tuần bận nhất. Đếm tin nhắn. Ước lượng độ dài trung bình của câu trả lời bạn nhận, tính bằng từ, rồi nhân khoảng 1,35 để ra token. Cộng thêm phần đầu vào, nhớ rằng mỗi lượt đều gửi lại cả luồng từ đầu tới lúc đó. Nhân với mức đầu vào và đầu ra đã công bố của mô hình, rồi so với phí tháng bạn đang cân nhắc. Máy tính chi phí trên trang này làm việc đó với giá hiện hành, nên bạn không phải tự cập nhật các mức giá.
Vài quy luật đủ chắc để nêu ra mà không phải bịa số. Trả theo mức dùng thường thắng khi mức dùng nhẹ hoặc nhấp nhô, khi bạn thỉnh thoảng dùng vài mô hình chứ không dùng một mô hình rất nặng, và khi phần lớn việc là câu hỏi ngắn với câu trả lời ngắn. Thuê bao thường thắng khi lượng dùng cao đều mỗi ngày, và nó có một lợi thế không phải tiền: hóa đơn đoán trước được. Trả theo mức dùng mà không thấy chi phí từng tin nhắn là tệ nhất của cả hai bên, và đúng là kiểu hỏng mà một ước tính chi phí trên mỗi tin nhắn sinh ra để chặn.
Làm thế nào để thực sự giảm số tiền bạn tiêu
Một khi bạn nhìn thấy các khoản tính phí, phần lớn khoản tiết kiệm đến từ một số thói quen nhỏ chứ không phải từ việc săn nhà cung cấp rẻ nhất. Theo thứ tự gần đúng về mức chúng đẩy con số, với một tải chat điển hình:
Thứ thường không hiệu quả là chuyển mọi việc sang mô hình rẻ nhất trong danh mục. Một mô hình cần ba lần thử mới ra câu trả lời đúng, dù giá bằng một phần năm, thì chưa chắc là tiết kiệm, và nó còn tốn thời gian của bạn. Phiên bản hữu ích của lời khuyên này là khớp mô hình với việc: mô hình rẻ cho trích xuất, định dạng, tóm tắt và dịch; mô hình đắt cho việc bạn vốn sẽ trả một người để làm.
- Mở một cuộc trò chuyện mới cho một chủ đề mới. Đây là đòn bẩy lớn nhất, vì nó ngăn bạn trả tiền để gửi lại một lịch sử không liên quan.
- Xin câu trả lời ngắn hơn khi bạn muốn câu trả lời ngắn hơn. Với khoảng chín mô hình trong mười, đầu ra là khoản tính phí đắt hơn.
- Khớp mô hình với việc, thay vì mặc định mô hình mạnh nhất cho mọi thứ.
- Giữ prompt hệ thống và mẫu dùng lại cho gọn. Chúng bị tính trên mọi tin nhắn dùng chúng.
- Dùng cache prompt ở chỗ nhà cung cấp hỗ trợ, và khi bạn dùng lại cùng một ngữ cảnh dài nhiều lần.
- Gỡ tệp đính kèm khỏi một luồng khi bạn xong việc với chúng, thay vì mang chúng qua mọi lượt sau.
- Xem ước tính trên một tin nhắn trước khi lặp mẫu đó một trăm lần.
Oriveo cho bạn thấy chi phí thế nào
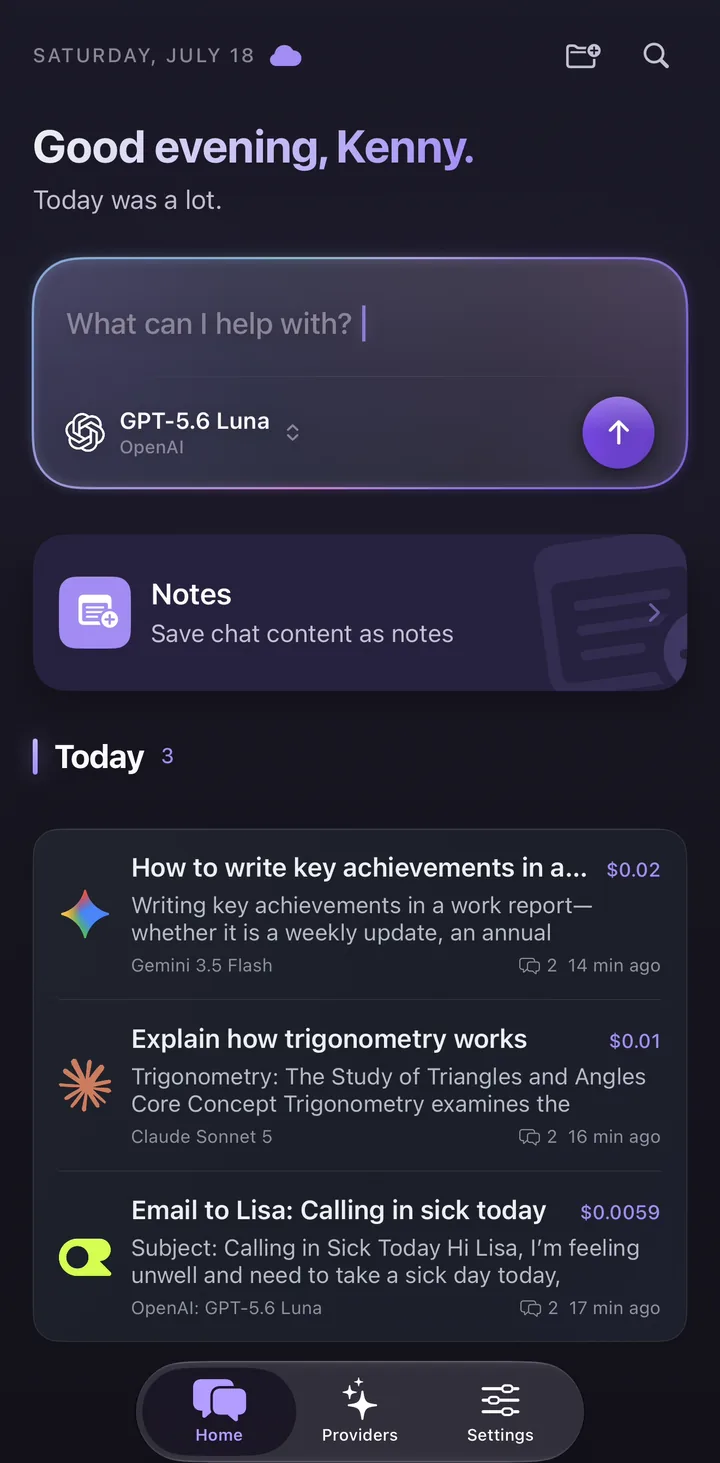
Mỗi tin nhắn trong Oriveo mang một chi phí ước tính, tính từ giá token đã công bố của nhà cung cấp và số token thực sự được báo, ngay khi câu trả lời xong. Ước tính đó có trên mọi tầng, kể cả tầng không cần đăng nhập, vì một chi phí bạn chỉ thấy trên gói trả phí thì không giúp bạn quyết định có nên trả tiền cho thứ gì hay không. Các giá đó lấy từ cùng nguồn metadata dùng trong các bảng phía trên, nên ứng dụng không bắt bạn tự giữ một bảng giá.
Đó là ước tính, và nó được ghi là ước tính. Nhà cung cấp áp dụng cách làm tròn, đơn vị tính phí tối thiểu, giá theo từng tài khoản và thỉnh thoảng là giá khuyến mại của riêng họ, còn số token được nhà cung cấp báo sau khi xong. Ước tính đó để bạn chỉnh quyết định trong tháng. Hóa đơn của nhà cung cấp là lời cuối, và khi hai bên lệch thì hóa đơn đúng.
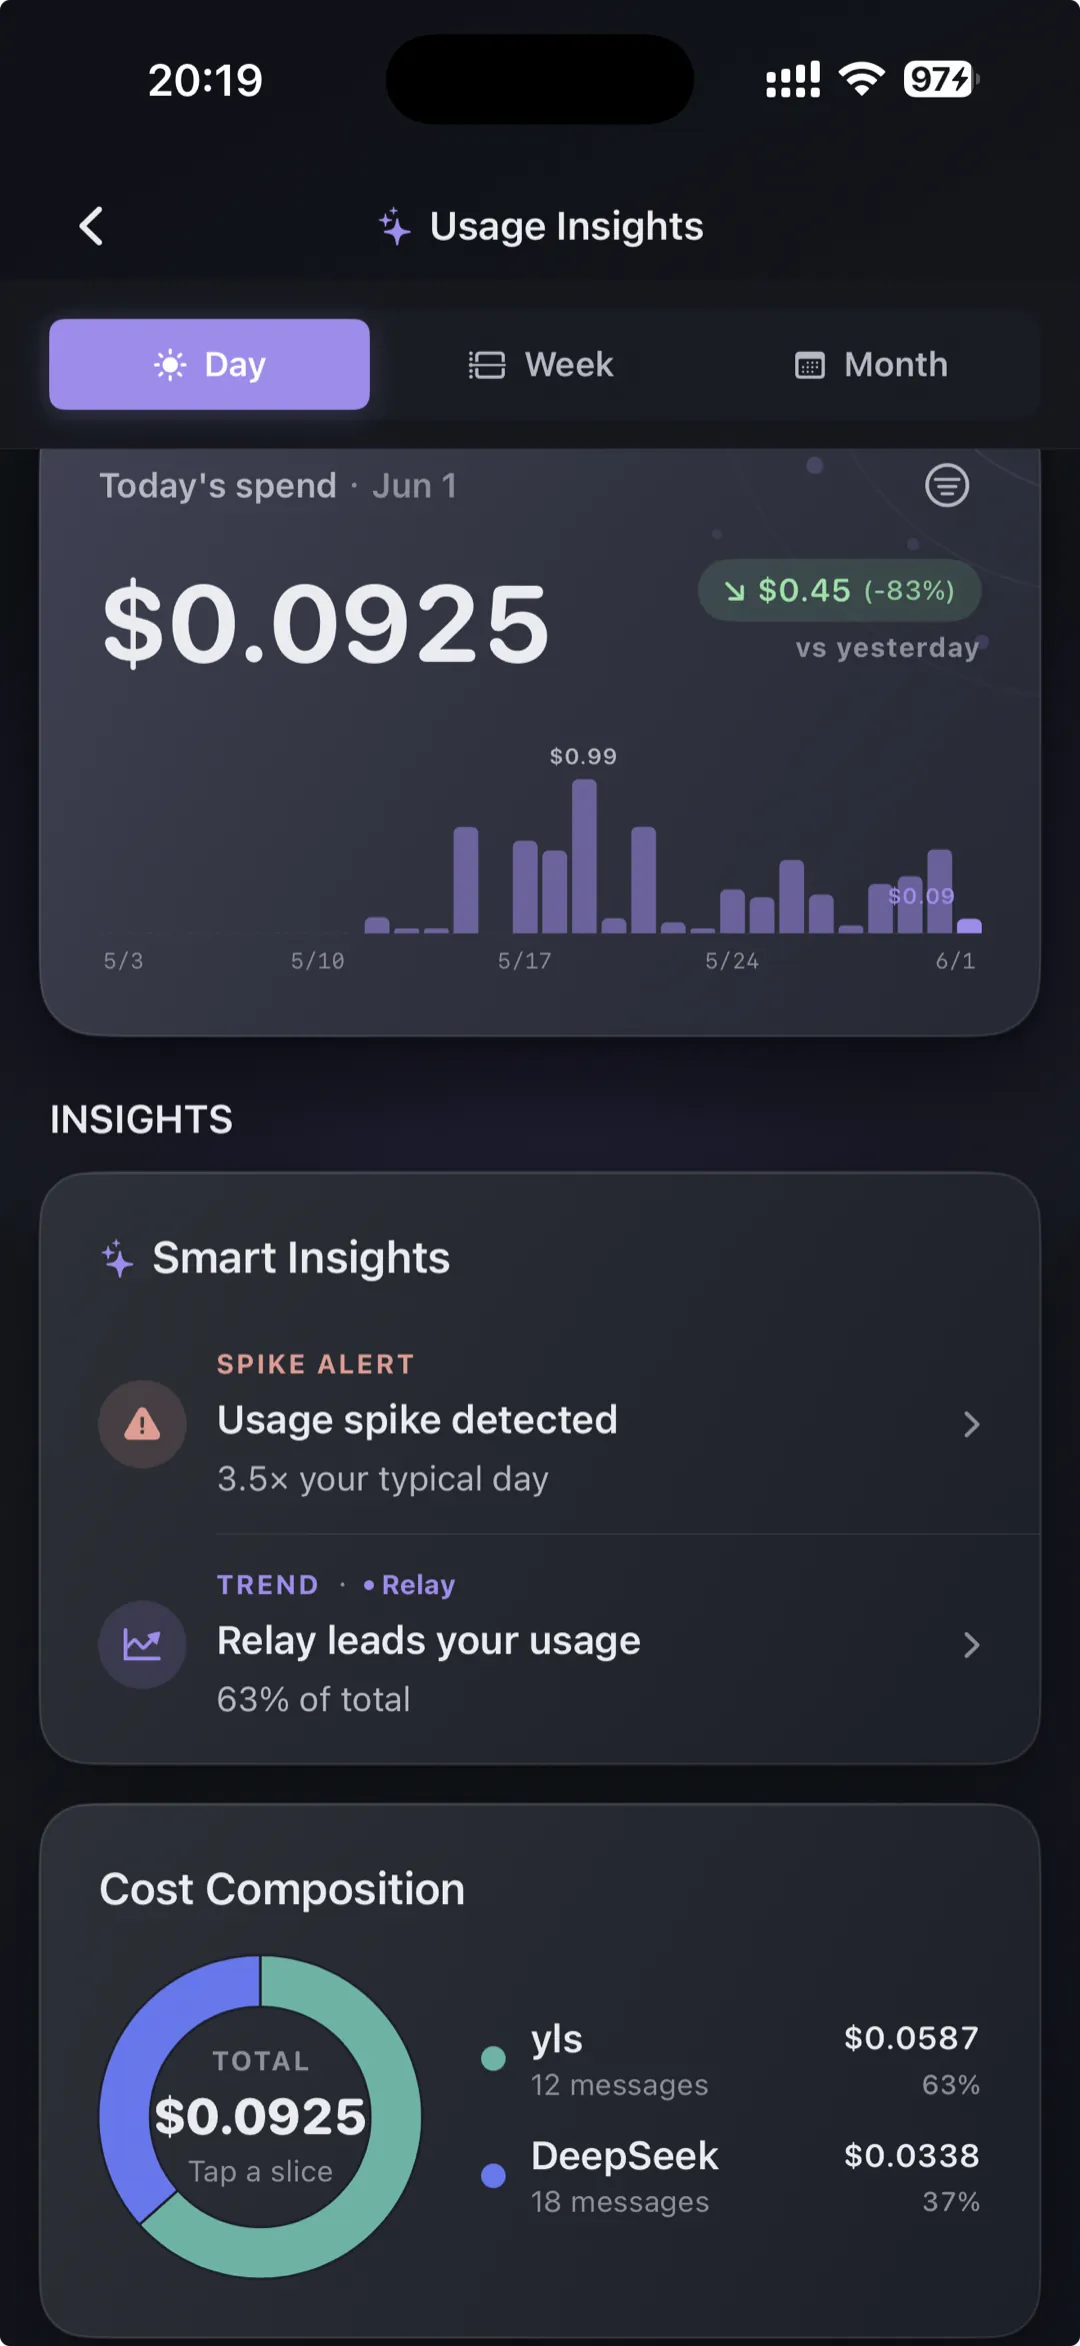
Phân tích sâu hơn nằm sau các gói trả phí. Usage Insights, tức chi tiêu tách theo nhà cung cấp và mô hình, xu hướng tháng và cảnh báo ngân sách, là một phần của Pro và Lifetime. Các gói đó giá $9.99 mỗi tháng, $59.99 mỗi năm hoặc $149.99 một lần, tính đến ngày 24 tháng 7 năm 2026. Chúng chỉ mua tính năng phần mềm: không gồm mức dùng AI, không credit mô hình và không thuê bao nhà cung cấp. Vì thế giá của ứng dụng và giá token của bạn không bao giờ bị gói vào một con số bạn không tách ra được.
Những con số này không nói được gì
Một bảng giá là điểm bắt đầu, không phải một quyết định. Ba thứ nó bỏ ngoài đáng nói thẳng, vì chúng thường lật ngược một so sánh mà nhìn giá thì tưởng đã xong.
Thứ nhất là số token cho mỗi việc. Hai mô hình cùng mức giá có thể khác nhau đáng kể ở chỗ chúng tiêu bao nhiêu token để tới cùng một câu trả lời, và một mô hình rẻ nhưng dài dòng có thể đắt hơn tính trên mỗi việc hoàn thành so với một mô hình đắt nhưng gọn. Thứ hai là tỷ lệ làm lại: một câu trả lời bạn phải tạo lại bị tính hai lần. Thứ ba là mọi thứ ngoài khoản tính phí token: hạn mức tốc độ, độ trễ, cửa sổ ngữ cảnh, khả năng dùng ở khu vực của bạn, và mô hình có đọc được các định dạng tệp bạn đang làm hay không.
Cách dùng trung thực một bài so sánh như bài này là coi nó như một cái lọc danh sách ngắn. Loại các hàng rõ ràng nằm ngoài ngân sách của bạn, thử hai hoặc ba ứng viên trên việc thật của mình, rồi nhìn một việc đã xong tốn bao nhiêu chứ không phải một triệu token tốn bao nhiêu. Ước tính từng tin nhắn khiến thí nghiệm này chỉ tốn một ngày, chứ không phải trọn một chu kỳ hóa đơn.
Câu hỏi thường gặp
Một tin nhắn tới API của LLM thực sự tốn bao nhiêu?
Vì sao đầu ra đắt hơn đầu vào?
Cache prompt có thực sự giảm hóa đơn không?
API trả theo mức dùng có rẻ hơn một gói thuê bao AI hằng tháng không?
Vì sao cùng một mô hình có giá khác nhau trên các nền tảng khác nhau?
Giá trong bài này còn mới tới đâu?
Oriveo có cộng thêm lên số nhà cung cấp tính không?
Bài liên quan
Xem mỗi tin nhắn tốn bao nhiêu ngay khi bạn gửi
Oriveo hiện chi phí ước tính trên mỗi tin nhắn theo giá niêm yết của nhà cung cấp, qua 15 nhà cung cấp chính thức và 700+ mô hình, trên iPhone, Android và web, không cộng thêm lên mức dùng của nhà cung cấp.