AI API लागत की तुलना: LLM का दाम सच में कैसे बनता है
LLM API का दाम असल में किससे बनता है, बिल क्या बढ़ाता है, और 15 प्रोवाइडरों पर इनपुट तथा आउटपुट दाम का असली दायरा — 24 जुलाई 2026 को मापा गया।
- LLM API अधिकतम चार अलग मीटर पर बिल करते हैं, और दाम की अधिकांश तुलनाएँ उनमें से केवल एक को देखती हैं।
- आउटपुट टोकन का दाम, मध्यिका पर, इनपुट टोकन का चार गुना है, और बारह गुना तक जाता है।
- 15 प्रोवाइडरों पर प्रकाशित इनपुट दाम 24 जुलाई 2026 की स्थिति में प्रति 1M टोकन $0.01 से $150 तक फैले हैं।
LLM API का दाम असल में कैसे काम करता है
AI API लागत की लगभग हर तुलना प्रति मॉडल एक संख्या उद्धृत करती है, और वह संख्या लगभग हमेशा इनपुट दाम होती है। प्रोवाइडर जो चार संख्याएँ प्रकाशित करता है, उनमें यह सबसे कम काम की है। एक मॉडल अलग-अलग मीटर पर बिल करता है: टोकन जो आप भेजते हैं, टोकन जो वह वापस लिखता है, कैश से पढ़े गए टोकन, और — कुछ प्रोवाइडरों पर — उस कैश में लिखे गए टोकन। हर मीटर की अपनी दर है, और दरें एक-दूसरे के क़रीब नहीं होतीं।
एक टोकन मोटे तौर पर एक अंग्रेज़ी शब्द का तीन-चौथाई होता है, इसलिए 1M टोकन क़रीब 750,000 शब्दों के आसपास हैं। दाम प्रति 1M टोकन उद्धृत होते हैं, क्योंकि अकेला संदेश इतना सस्ता होता है कि प्रति-संदेश दाम सब शून्य दिखे। यह ढाँचा छिपा देता है कि असली बातचीत में मीटर कितनी तेज़ी से जुड़ते हैं, जहाँ हर बारी अपने से पहले कही हर बात को फिर भेजती है।
नीचे की तालिका चुनिंदा मॉडलों के चारों मीटर दिखाती है, उसी metadata फ़ीड से जो इस साइट की मॉडल-सूची और लागत कैलकुलेटर को चलाती है। देखें कि इनपुट कॉलम कितना कम बताता है: यहाँ इनपुट दाम $0.30 से $2.50 के बीच हैं, जबकि आउटपुट दाम $1.20 से $15.00 तक फैले हैं, और वही मीटर सबसे ज़्यादा हिलता है।
- इनपुट — जो कुछ आप भेजते हैं: आपका संदेश, अब तक की बातचीत, कोई भी सिस्टम prompt, कोई भी जोड़ा गया टेक्स्ट।
- आउटपुट — जो कुछ मॉडल वापस लिखता है, उन मॉडलों पर तर्क वाले टोकन समेत जो उन्हें बनाते हैं।
- कैश किया इनपुट पढ़ना — दोहराया गया संदर्भ जिसे प्रोवाइडर पहले देख चुका है, ताज़े इनपुट से काफ़ी कम दर पर बिल।
- कैश में लिखना — कुछ प्रोवाइडर उस संदर्भ को पहली बार कैश में रखने के लिए जो शुल्क लेते हैं।
| मॉडल | इनपुट (USD / 1M टोकन) | आउटपुट (USD / 1M टोकन) | कैश किया इनपुट पढ़ना | कैश में लिखना |
|---|---|---|---|---|
| Claude Haiku 4.5 | 1.00 | 5.00 | 0.10 | 1.25 |
| Claude Sonnet 5 | 2.00 | 10.00 | 0.20 | 2.50 |
| GPT-5.6 Luna | 1.00 | 6.00 | 0.10 | 1.25 |
| GPT-5.6 Terra | 2.50 | 15.00 | 0.25 | 3.125 |
| Kimi k2.5 | 0.60 | 3.00 | 0.10 | 0.60 |
| Qwen3.7 Plus | 0.50 | 3.00 | 0.05 | 0.625 |
| MiniMax-M2.5 | 0.30 | 1.20 | 0.03 | 0.375 |
महँगा आधा आउटपुट टोकन हैं
LLM के दाम में सबसे भरोसेमंद पैटर्न यह है कि लिखना पढ़ने से महँगा पड़ता है। अंदाज़े के बजाय संख्या रखने के लिए हमने Oriveo की metadata फ़ीड में हर उस टेक्स्ट मॉडल को लिया जो प्रति-टोकन दाम प्रकाशित करता है — सभी 15 प्रोवाइडरों पर — और 24 जुलाई 2026 की स्थिति में हर मॉडल की आउटपुट दर की तुलना उसकी अपनी इनपुट दर से की।
मध्यिका मॉडल आउटपुट के लिए इनपुट से ठीक चार गुना लेता है। क़रीब दस में से एक मॉडल दोनों के लिए समान लेता है, या आउटपुट के लिए कम, जो इन्फ़रेंस होस्ट पर चलने वाले ओपन-वेट मॉडल का आम रूप है। दूसरे सिरे पर, मोटे तौर पर सात में से एक छह गुना से अधिक लेता है, और फ़ीड में सबसे चौड़ा अंतर बारह गुना है।
इसका आपके खर्च पर सीधा असर है। prompt छोटा करना वह सुधार है जिसकी तरफ़ सब पहले बढ़ते हैं, और आमतौर पर असर भी उतना नहीं होता। छोटा जवाब माँगना, आउटपुट की लंबाई पर सीमा रखना, या ऐसा मॉडल चुनना जो लंबाई में ज़ोर से न सोचे — ये सवाल से एक पैराग्राफ़ घटाने से बिल को ज़्यादा हिलाते हैं। तर्क वाले मॉडल यहाँ दूसरी नज़र माँगते हैं, क्योंकि उनके सोचने वाले टोकन आउटपुट की तरह बिल होते हैं, तब भी जब आप उन्हें देखते नहीं।
| आउटपुट दाम, इनपुट दाम की तुलना में | दाम वाले टेक्स्ट मॉडल का हिस्सा |
|---|---|
| समान या सस्ता (1× या कम) | 10% |
| 1× से 2× | 11% |
| 2× से 4× | 39% |
| 4× से 6× | 25% |
| 6× से अधिक | 15% |
आपका बिल असल में क्या बढ़ाता है
लोग आमतौर पर अपने पहले API इनवॉइस से चार कारणों में से किसी एक पर चौंकते हैं, और उनमें से कोई भी मॉडल का शीर्षक दाम नहीं होता। नीचे की व्यवस्था हर प्रोवाइडर पर सच है, क्योंकि वह किसी विक्रेता की नीति से नहीं, चैट API के काम करने के तरीक़े से निकलती है।
सबसे बड़ा कारण संदर्भ का फिर भेजा जाना है। API कॉल में पिछली स्थिति नहीं रहती: मॉडल को आपकी पिछली बारी याद नहीं, इसलिए क्लाइंट को हर संदेश के साथ पूरी बातचीत फिर भेजनी पड़ती है। जो धागा चालीस बारी चल चुका है, वह इकतालीसवीं बारी पर चालीस बारी का इतिहास इनपुट के रूप में भेजता है। इसलिए बातचीत की लागत उसकी लंबाई के वर्ग के क़रीब बढ़ती है, और इसीलिए एक लंबा धागा उसी ज़मीन को कवर करने वाली बीस छोटी बातचीतों से महँगा पड़ सकता है।
prompt caching इसका संतुलन है, और इसे ख़ारिज करने से पहले समझना चाहिए। जो प्रोवाइडर इसका समर्थन करते हैं, वे दोहराए गए संदर्भ को ताज़े इनपुट के बजाय कैश से पढ़े जाने की तरह बिल करने देते हैं। जिस फ़ीड को हमने मापा, उसमें क़रीब पाँच में से एक मॉडल कैश-पढ़ने का दाम प्रकाशित करता है, और जहाँ वह है वहाँ कैश दर उस मॉडल के अपने इनपुट दाम की मध्यिका पर 10% बैठती है — सबसे कम हमें 1% से नीचे मिला, सबसे अधिक क़रीब 58%। कुछ प्रोवाइडर कैश लिखने का शुल्क भी लेते हैं, आमतौर पर सामान्य इनपुट से अधिक, इसलिए caching तब फ़ायदे की है जब वही संदर्भ कई बार दोबारा चले, और तब नहीं जब वह एक ही बार चले।
- बातचीत का इतिहास — हर बारी पर पूरा फिर भेजा जाता है, इसलिए लंबे धागे अनुपात से ज़्यादा खर्च करते हैं।
- सिस्टम prompt और प्रीसेट — दोबारा इस्तेमाल होने वाले निर्देश हर संदेश के आगे जुड़ जाते हैं, और चुपचाप उनकी टोकन गिनती कई गुना कर देते हैं।
- अटैचमेंट — चैट में डाला गया दस्तावेज़ या इमेज इनपुट टोकन बन जाता है, और उस धागे की हर बाद की बारी के संदर्भ में बना रहता है।
- तर्क वाले टोकन — उन्हें बनाने वाले मॉडलों पर आउटपुट की तरह बिल होते हैं, चाहे तर्क दिखाया जाए या नहीं।
- दोबारा कोशिश और पुनर्जनन — दोबारा बनाया गया जवाब दूसरा पूरा बिल किया अनुरोध है, फ्री सुधार नहीं।
15 प्रोवाइडरों पर दाम का नक़्शा
नीचे की तालिका उन 15 प्रोवाइडरों में से हर एक पर प्रकाशित इनपुट-दाम के दायरे की तस्वीर है जिनसे Oriveo जुड़ता है। यह केवल उन टेक्स्ट मॉडलों को गिनती है जो प्रति-टोकन दाम प्रकाशित करते हैं, और उस प्रोवाइडर पर उनमें से सबसे सस्ता तथा सबसे महँगा दिखाती है। यह नक़्शा है कि हर प्रोवाइडर कहाँ बैठता है, सिफ़ारिश नहीं: एक प्रोवाइडर का सबसे सस्ता मॉडल और सबसे महँगा शायद ही एक-दूसरे की जगह ले सकें।
स्रोत और तरीक़ा, ताकि आप जाँच सकें: हर संख्या Oriveo की प्रोडक्शन metadata फ़ीड से आती है, api.oriveoai.com/api/metadata पर, अनुबंध संस्करण 47, जनित 2026-07-24T01:00:09Z — वही फ़ीड जिससे ऐप संदेशों का दाम लगाता है, और वही जो इस साइट के लागत कैलकुलेटर के पीछे है। दाम अमेरिकी डॉलर प्रति 1M टोकन में हैं, 24 जुलाई 2026 की स्थिति में। इमेज बनाने वाले मॉडल, और वे मॉडल जिन्हें प्रोवाइडर प्रति टोकन नहीं बल्कि प्रति अनुरोध दाम देता है, बाहर रखे गए हैं, क्योंकि उनके लिए प्रति-टोकन अंक अर्थ नहीं रखता।
दो बातें अलग दिखती हैं। पहली, फैलाव: पूरी फ़ीड में सबसे सस्ता इनपुट दाम प्रति 1M टोकन $0.01 है और सबसे महँगा $150, यानी 24 जुलाई 2026 की स्थिति में एक ही मॉडल-सूची की दो पंक्तियों के बीच पंद्रह हज़ार गुना। दूसरी, कैटलॉग का चौड़ा होना और सस्ता होना एक ही बात नहीं — एग्रीगेटर सबसे चौड़ा दायरा रखते हैं क्योंकि वे कई कंपनियों के मॉडल फिर बेचते हैं, जबकि एक कंपनी वाले प्रोवाइडर अपनी ही स्तर-व्यवस्था के आसपास सटे रहते हैं।
यहाँ हर संख्या को अस्थायी मानें। प्रोवाइडर दाम बदलते रहते हैं, सस्ते स्तर लाते हैं, और मॉडल लगातार हटाते हैं; नीचे की कई पंक्तियाँ पिछली तिमाही के भीतर बदलीं। मॉडल दाम उद्धृत करने वाला कोई भी लेख एक फ़ोटो है। लाइव फ़ीड और कैलकुलेटर इसीलिए हैं, और यह पन्ना वह तारीख बताता है जब अंक लिए गए, यह नहीं कहता कि संख्याएँ हमेशा की हैं।
| प्रोवाइडर | प्रकाशित टोकन दाम वाले टेक्स्ट मॉडल | सबसे कम इनपुट (USD / 1M) | सबसे अधिक इनपुट (USD / 1M) |
|---|---|---|---|
| OpenAI | 49 | 0.05 | 150 |
| Anthropic (Claude) | 10 | 1.00 | 15 |
| Google Gemini | 21 | 0.075 | 2.00 |
| xAI Grok | 6 | 1.00 | 2.00 |
| DeepSeek | 4 | 0.14 | 0.435 |
| Mistral | 32 | 0.04 | 2.00 |
| Qwen | 49 | 0.035 | 2.80 |
| Kimi | 9 | 0.20 | 2.00 |
| MiniMax | 7 | 0.30 | 0.60 |
| Z.ai | 12 | 0.07 | 1.40 |
| Groq | 7 | 0.03 | 0.59 |
| Together AI | 69 | 0.02 | 3.50 |
| Fireworks AI | 15 | 0.07 | 2.80 |
| OpenRouter | 305 | 0.01 | 150 |
| SiliconFlow | 49 | 0.04 | 1.74 |
एक ही मॉडल के एक से अधिक दाम क्यों होते हैं
दो मॉडल निर्देशिकाएँ खोलें और आपको वही मॉडल अलग दरों पर मिलेगा। यह आमतौर पर ग़लती नहीं होती। ओपन-वेट मॉडल कई इन्फ़रेंस होस्ट पर चलते हैं, हर एक के अपने हार्डवेयर, थ्रूपुट और मार्जिन के साथ, इसलिए एक मॉडल का एक होस्ट पर एक दाम और दूसरे पर कुछ और होना जायज़ है। ऊपर की फ़ीड में एक ही ओपन-वेट परिवार कई प्रोवाइडरों पर सचमुच अलग दरों पर दिखता है।
दूसरा कारण वह परत है जिससे आप ख़रीदते हैं। एग्रीगेटर आपके और नीचे के प्रोवाइडर के बीच बैठते हैं, और उस जगह का खर्च किसी न किसी तरह निकालना पड़ता है — टोकन दाम पर अंतर से, टॉप-अप शुल्क से, अनुरोधों पर प्रतिशत से, या एक क्रेडिट प्रणाली से जिसका टोकन में बदलना प्रोवाइडर की मूल्य-सूची नहीं, प्लेटफ़ॉर्म तय करता है। इनमें से कोई भी अपने आप बुरा नहीं; मायने यह रखता है कि तरीक़ा प्रकाशित है या नहीं। मिसाल के लिए OpenRouter अपनी शर्तें खुले में लिखता है: 24 जुलाई 2026 की स्थिति में उसकी प्रकाशित नीति कार्ड टॉप-अप पर 5.5% शुल्क है, न्यूनतम $0.80, और जो key आप खुद लाते हैं उनके लिए हर महीने के पहले 1M अनुरोध बिना शुल्क, उसके आगे मॉडल के सामान्य दाम का 5% क्रेडिट में कटता है।
जब आप प्लेटफ़ॉर्म की तुलना करें, पूछने लायक़ सवाल यह नहीं कि “एक क्रेडिट कितने का है”, बल्कि यह कि “प्रोवाइडर के लिस्ट प्राइस से मेरे लगने वाले शुल्क तक प्रकाशित रास्ता क्या है”। अगर कोई प्लेटफ़ॉर्म क्रेडिट में दाम लगाता है और वह रूपांतरण प्रकाशित नहीं करता, तो आप मॉडल के दाम से तुलना नहीं कर रहे — प्लेटफ़ॉर्म की मूल्य नीति से कर रहे हैं, और वह नीति मॉडल का दाम जस का तस रहते हुए भी बदल सकती है।
सब्सक्रिप्शन या जितना चले उतना भुगतान: आपके लिए कौन सस्ता है
अधिकांश लोग असल में इसी सवाल के साथ आते हैं, और इसका कोई सामान्य जवाब नहीं। एक सपाट मासिक सब्सक्रिप्शन और मीटर वाली API पहुँच इस्तेमाल की किसी मात्रा पर एक-दूसरे को काटती हैं, और वह बिंदु आपके अपने संदेशों पर निर्भर है: वे कितने लंबे हैं, जवाब कितने लंबे हैं, आप कौन-सा मॉडल चुनते हैं, और आपके धागे कितनी दूर तक चलते हैं। जो कोई आपके अंकों के बिना प्रतिशत बचत बताए, वह अनुमान लगा रहा है।
आप इसे क़रीब पाँच मिनट में निकाल सकते हैं, और हिसाब कठिन नहीं। अपने सबसे व्यस्त सप्ताह के बजाय सच में आम सप्ताह लें। संदेश गिनें। जो जवाब मिलते हैं उनकी औसत लंबाई शब्दों में अंदाज़ा लगाएँ और टोकन पाने के लिए मोटे तौर पर 1.35 से गुणा करें। इनपुट तरफ़ जोड़ें, यह याद रखते हुए कि हर बारी अब तक का धागा फिर भेजती है। मॉडल की प्रकाशित इनपुट और आउटपुट दरों से गुणा करें, और जिस मासिक शुल्क पर आप विचार कर रहे हैं उससे तुलना करें। इस साइट का लागत कैलकुलेटर यह लाइव दामों पर करता है, ताकि आपको दरें खुद सँभालनी न पड़ें।
कुछ ढाँचे इतने स्थिर हैं कि संख्या गढ़े बिना कहे जा सकते हैं। मीटर वाली पहुँच तब सस्ती पड़ती है जब इस्तेमाल हल्का या उछाल वाला हो, जब आप एक मॉडल को भारी नहीं बल्कि कई मॉडल कभी-कभी चलाते हों, और जब आपका काफ़ी काम छोटे सवाल और छोटे जवाब का हो। सब्सक्रिप्शन लगातार ऊँचे दैनिक इस्तेमाल पर सस्ते पड़ते हैं, और उनका एक असली ग़ैर-पैसों वाला फ़ायदा है: बिल का अनुमान लगाया जा सकता है। बिना हर संदेश की लागत देखे मीटर वाली पहुँच दोनों में से ख़राब है, और हर संदेश पर लागत का अनुमान ठीक इसी चूक को रोकने के लिए है।
खर्च सच में कैसे घटाएँ
जब मीटर दिखने लगें, अधिकांश बचत सबसे सस्ते प्रोवाइडर की तलाश से नहीं आती, थोड़ी-सी आदतों से आती है। एक आम चैट के काम के लिए, वे संख्या को कितना हिलाते हैं उसके मोटे क्रम में:
जो आमतौर पर काम नहीं करता वह है सब कुछ कैटलॉग के सबसे सस्ते मॉडल पर ले जाना। जो मॉडल सही जवाब के लिए तीन कोशिशें माँगे और दाम का पाँचवाँ हिस्सा ले, वह बचत नहीं, और आपका समय भी लेता है। इस सलाह का काम का रूप यह है कि मॉडल को काम से मिलाएँ — सस्ते मॉडल निकालने, फ़ॉर्मैट करने, सार लिखने और अनुवाद के लिए, महँगे उन कामों के लिए जिनके लिए आप किसी व्यक्ति को भुगतान करते।
- नए विषय के लिए नई बातचीत शुरू करें। खर्च यहीं सबसे ज़्यादा घटता है, क्योंकि आप उस इतिहास को फिर भेजने का भुगतान रोक देते हैं जो अब काम का नहीं।
- जब छोटा जवाब चाहिए, छोटा जवाब माँगें। क़रीब दस में से नौ मॉडलों पर आउटपुट ज़्यादा महँगा मीटर है।
- हर काम के लिए सबसे मज़बूत मॉडल को डिफ़ॉल्ट बनाने के बजाय मॉडल को काम से मिलाएँ।
- सिस्टम prompt और दोबारा इस्तेमाल होने वाले प्रीसेट छोटे रखें — उनका बिल हर उस संदेश पर लगता है जो उन्हें इस्तेमाल करता है।
- जहाँ प्रोवाइडर समर्थन करे और आप वही लंबा संदर्भ बार-बार चलाएँ, वहाँ prompt caching इस्तेमाल करें।
- अटैचमेंट से काम निकल जाए तो उन्हें धागे से हटा दें, बाद की हर बारी में साथ घसीटने के बजाय।
- किसी पैटर्न को सौ बार दोहराने से पहले संदेश पर अनुमान देख लें।
Oriveo आपको लागत कैसे दिखाता है
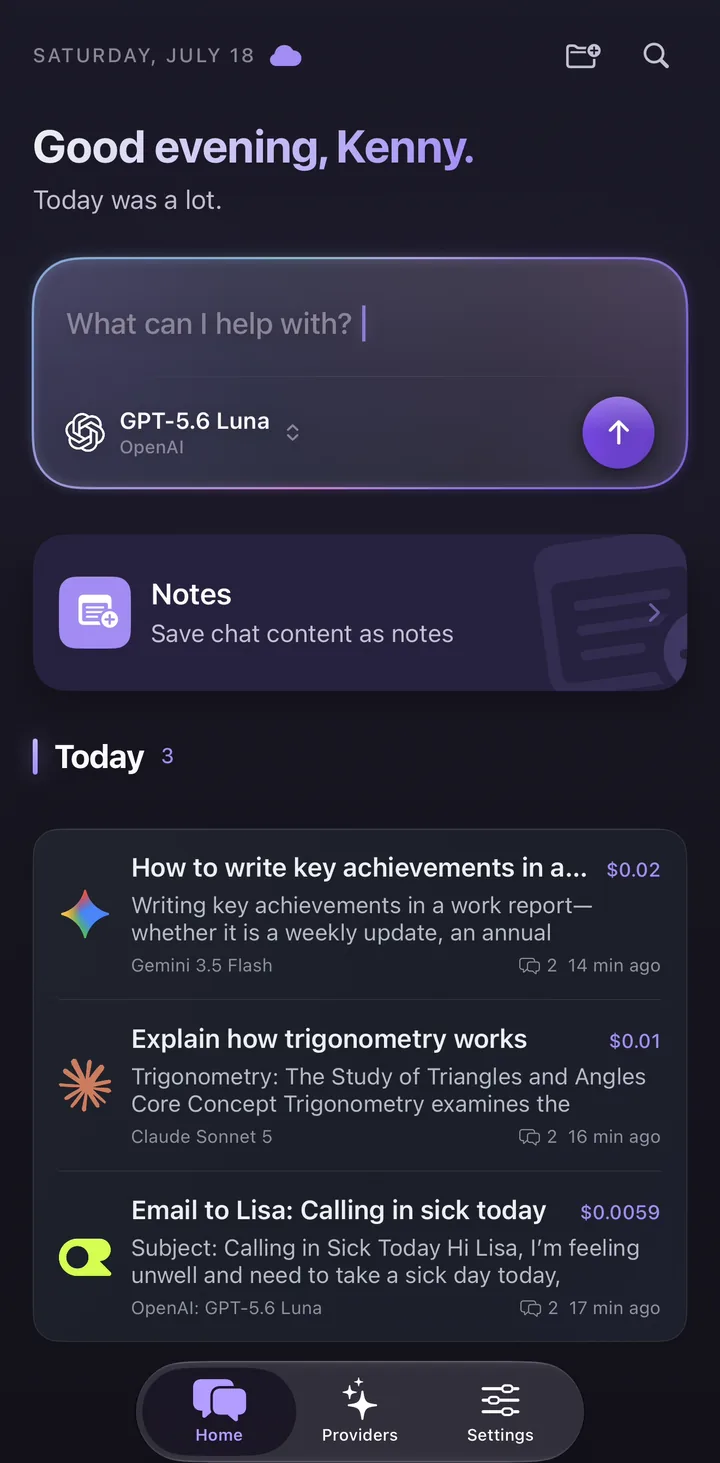
Oriveo में हर संदेश के साथ उसका अनुमानित खर्च दिखता है, जो प्रोवाइडर के प्रकाशित टोकन मूल्य और सच में रिपोर्ट किए गए टोकन से, जवाब पूरा होते ही निकाली जाती है। वह अनुमान हर स्तर पर उपलब्ध है, बिना साइन-इन वाले समेत, क्योंकि जो लागत केवल पेड प्लान पर दिखे वह यह तय करने में मदद नहीं करती कि कुछ भुगतान करना भी है या नहीं। ऊपर की तालिकाओं में इस्तेमाल वही metadata फ़ीड ये दाम देती है, इसीलिए ऐप को आपसे एक मूल्य-सूची बनाए रखने की ज़रूरत नहीं।
यह अनुमान है, और इसे अनुमान ही लिखा जाता है। प्रोवाइडर अपनी राउंडिंग, न्यूनतम बिल योग्य इकाई, हर अकाउंट की दर और कभी-कभार प्रचार दाम लगाते हैं, और टोकन गिनती प्रोवाइडर बाद में बताता है। अनुमान महीने के दौरान फ़ैसले की दिशा देने के लिए है; आपके प्रोवाइडर का इनवॉइस अंतिम शब्द है, और जब दोनों अलग हों तो इनवॉइस सही है।
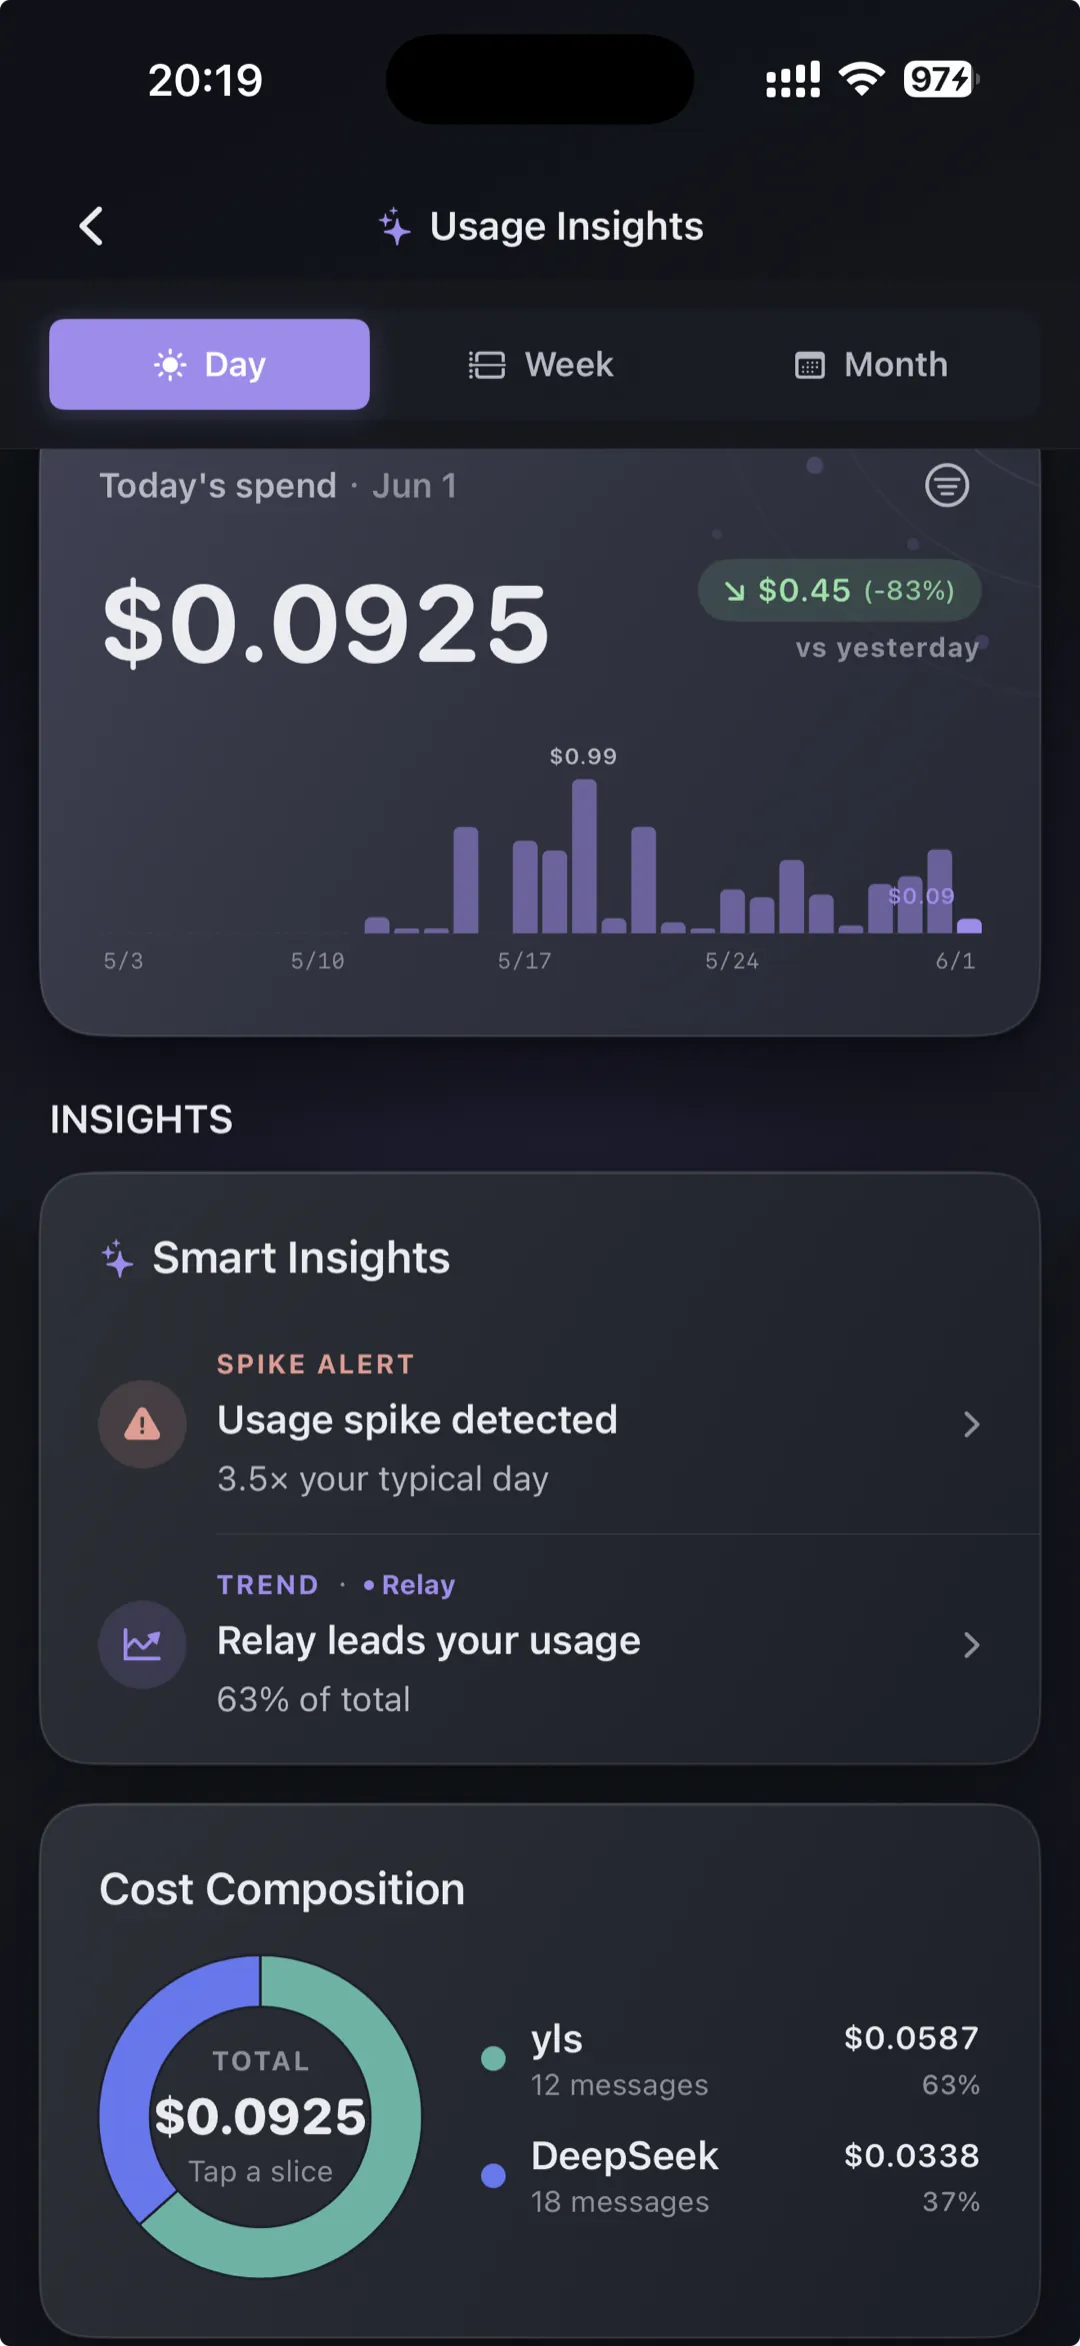
गहरा विश्लेषण पेड प्लान के पीछे है। Usage Insights — प्रोवाइडर और मॉडल के हिसाब से खर्च, मासिक रुझान और बजट अलर्ट — Pro और Lifetime का हिस्सा है, जिनका दाम 24 जुलाई 2026 की स्थिति में $9.99 प्रति माह, $59.99 प्रति वर्ष, या एक बार $149.99 है। ये प्लान केवल सॉफ़्टवेयर की सुविधाएँ खरीदते हैं: इनमें कोई AI इस्तेमाल नहीं, कोई मॉडल क्रेडिट नहीं, और कोई प्रोवाइडर सब्सक्रिप्शन नहीं, इसलिए ऐप का दाम और आपके टोकन का दाम कभी एक ऐसी संख्या में नहीं बँधते जिसे आप अलग न कर सकें।
ये संख्याएँ आपको क्या नहीं बता सकतीं
दाम की तालिका शुरुआत है, फ़ैसला नहीं। तीन बातें जो यह छोड़ देती है उन्हें साफ़ कहना चाहिए, क्योंकि वे अक्सर ऐसी तुलना को पलट देती हैं जो अकेले दाम पर तय लग रही थी।
पहली, हर काम पर टोकन। एक ही दर वाले दो मॉडल एक ही जवाब तक पहुँचने में काफ़ी अलग संख्या में टोकन खर्च कर सकते हैं, और एक लंबा-चौड़ा सस्ता मॉडल एक संक्षिप्त महँगे मॉडल से पूरे काम पर ज़्यादा खर्च कर सकता है। दूसरी, दोबारा कोशिश की दर: जो जवाब आपको फिर बनाना पड़े, उसका बिल दो बार लगता है। तीसरी, टोकन मीटर के बाहर की हर चीज़ — दर की सीमाएँ, विलंब, संदर्भ विंडो, आपके क्षेत्र में उपलब्धता, और यह कि मॉडल उन फ़ाइल प्रारूपों को पढ़ सकता है या नहीं जिनके साथ आप काम करते हैं।
ऐसी तुलना को इस्तेमाल करने का सीधा तरीक़ा इसे शॉर्टलिस्ट का छन्ना मानना है। जो पंक्तियाँ साफ़ आपके बजट से बाहर हों उन्हें हटा दें, अपने असली काम पर दो या तीन उम्मीदवार आज़माएँ, और देखें कि पूरे काम पर कितना खर्च होता है, न कि 1M टोकन पर। हर संदेश का अनुमान ठीक इसलिए है कि यह प्रयोग एक बिलिंग चक्र नहीं, एक दिन ले।
अक्सर पूछे जाने वाले सवाल
LLM API को एक संदेश की असल लागत क्या होती है?
आउटपुट इनपुट से महँगा क्यों है?
क्या prompt caching सच में बिल घटाती है?
क्या जितना-चले-उतना-भुगतान वाली API मासिक AI सब्सक्रिप्शन से सस्ती है?
एक ही मॉडल अलग प्लेटफ़ॉर्म पर अलग दाम क्यों लेता है?
इस लेख के दाम कितने नए हैं?
क्या Oriveo प्रोवाइडरों के शुल्क पर markup जोड़ता है?
इनसे जुड़े आर्टिकल
भेजते समय देखें, हर संदेश पर कितना खर्च हो रहा है
Oriveo हर संदेश पर प्रोवाइडर के लिस्ट प्राइस के हिसाब से अनुमानित खर्च दिखाता है, 15 आधिकारिक प्रोवाइडरों और 700+ मॉडलों पर, iPhone, Android और वेब पर — प्रोवाइडर के इस्तेमाल पर कोई markup नहीं।