เทียบต้นทุน AI API: ราคา LLM คิดจริงอย่างไร
ราคา LLM API ประกอบด้วยอะไร อะไรทำให้บิลสูง และช่วงราคาอินพุตกับเอาต์พุตจริงของ 15 ผู้ให้บริการ วัดเมื่อ 24 กรกฎาคม 2026
- API ของ LLM คิดเงินได้ถึงสี่มาตรวัดแยกกัน และการเทียบราคาส่วนใหญ่ดูแค่มาตรวัดเดียว
- โทเค็นเอาต์พุตมีราคาที่ค่ามัธยฐานเป็นสี่เท่าของโทเค็นอินพุต และสูงได้ถึงสิบสองเท่า
- ราคาอินพุตที่เผยแพร่ของ 15 ผู้ให้บริการกินช่วงตั้งแต่ $0.01 ถึง $150 ต่อหนึ่งล้านโทเค็น ณ 24 กรกฎาคม 2026
ราคา LLM API ทำงานจริงอย่างไร
การเทียบต้นทุน AI API เกือบทุกชิ้นอ้างตัวเลขเดียวต่อโมเดล และตัวเลขนั้นแทบเสมอคือราคาอินพุต มันเป็นตัวที่ใช้น้อยสุดในสี่ตัวเลขที่ผู้ให้บริการเผยแพร่ โมเดลคิดเงินบนมาตรวัดแยกกัน: โทเค็นที่คุณส่งเข้าไป, โทเค็นที่มันเขียนกลับ, โทเค็นที่อ่านจากแคช และ — กับผู้ให้บริการบางราย — โทเค็นที่เขียนเข้าแคชนั้น แต่ละมาตรวัดมีอัตราของตัวเอง และอัตราเหล่านั้นไม่ได้อยู่ใกล้กัน
โทเค็นหนึ่งตัวยาวประมาณสามในสี่ของคำภาษาอังกฤษ ดังนั้นหนึ่งล้านโทเค็นอยู่แถว ๆ 750,000 คำ ราคาถูกอ้างต่อหนึ่งล้านโทเค็น เพราะข้อความเดี่ยวถูกมากจนราคาต่อข้อความจะเป็นศูนย์ทั้งแถว กรอบแบบนั้นซ่อนว่ามาตรวัดบวกกันเร็วแค่ไหนในบทสนทนาจริง ซึ่งทุกเทิร์นส่งซ้ำทุกอย่างที่พูดมาก่อนหน้า
ตารางด้านล่างแสดงทั้งสี่มาตรวัดของโมเดลหยิบมือหนึ่ง นำจากฟีด metadata ชุดเดียวกับที่ขับตัวเลือกโมเดลและเครื่องคำนวณต้นทุนบนเว็บนี้ สังเกตว่าคอลัมน์อินพุตบอกคุณได้น้อยแค่ไหน: ราคาอินพุตในตารางนี้อยู่ที่ 0.30 ถึง 2.50 ดอลลาร์ แต่ราคาเอาต์พุตกว้างตั้งแต่ 1.20 ถึง 15.00 ดอลลาร์ และเอาต์พุตคือมาตรวัดที่ขยับมากสุด
- อินพุต — ทุกอย่างที่คุณส่ง: ข้อความของคุณ บทสนทนาจนถึงตอนนั้น system prompt ใด ๆ และข้อความที่แนบมา
- เอาต์พุต — ทุกอย่างที่โมเดลเขียนกลับ รวมโทเค็นการคิดบนโมเดลที่สร้างมัน
- อ่านอินพุตจากแคช — บริบทซ้ำที่ผู้ให้บริการเคยเห็นแล้ว คิดในอัตราที่ต่ำกว่าราคาอินพุตใหม่มาก
- เขียนแคช — สิ่งที่ผู้ให้บริการบางรายคิด เพื่อวางบริบทนั้นเข้าแคชในครั้งแรก
| โมเดล | อินพุต (USD / 1 ล้านโทเค็น) | เอาต์พุต (USD / 1 ล้านโทเค็น) | อ่านอินพุตจากแคช | เขียนแคช |
|---|---|---|---|---|
| Claude Haiku 4.5 | 1.00 | 5.00 | 0.10 | 1.25 |
| Claude Sonnet 5 | 2.00 | 10.00 | 0.20 | 2.50 |
| GPT-5.6 Luna | 1.00 | 6.00 | 0.10 | 1.25 |
| GPT-5.6 Terra | 2.50 | 15.00 | 0.25 | 3.125 |
| Kimi k2.5 | 0.60 | 3.00 | 0.10 | 0.60 |
| Qwen3.7 Plus | 0.50 | 3.00 | 0.05 | 0.625 |
| MiniMax-M2.5 | 0.30 | 1.20 | 0.03 | 0.375 |
โทเค็นเอาต์พุตคือครึ่งที่แพง
รูปแบบที่เชื่อได้สุดในราคา LLM คือการเขียนแพงกว่าการอ่าน เพื่อใส่ตัวเลขแทนความรู้สึก เราเอาโมเดลข้อความทุกตัวในฟีด metadata ของ Oriveo ที่เผยแพร่ราคาต่อโทเค็น — ครบทั้ง 15 ผู้ให้บริการ — แล้วเทียบอัตราเอาต์พุตของแต่ละโมเดลกับอัตราอินพุตของมันเอง ณ 24 กรกฎาคม 2026
โมเดลที่อยู่ค่ามัธยฐานคิดเอาต์พุตแพงกว่าอินพุตพอดีสี่เท่า ประมาณหนึ่งในสิบโมเดลคิดทั้งสองอย่างเท่ากัน หรือคิดเอาต์พุตถูกกว่า ซึ่งเป็นแบบฉบับของโมเดล open-weight ที่โฮสต์ inference ให้บริการ อีกปลายหนึ่ง ประมาณหนึ่งในเจ็ดคิดมากกว่าหกเท่า โดยช่องว่างกว้างสุดในฟีดอยู่ที่สิบสองเท่า
เรื่องนี้มีผลตรงต่อการใช้จ่าย การตัด prompt ให้สั้นคือการปรับที่ทุกคนคว้าก่อน และมันมักเป็นทางที่ขยับบิลได้น้อยกว่า การขอคำตอบที่สั้นลง การจำกัดความยาวเอาต์พุต หรือการเลือกโมเดลที่ไม่เขียนขั้นตอนการคิดยาว ๆ จะขยับบิลได้มากกว่าการตัดย่อหน้าออกจากคำถาม โมเดลที่คิดเป็นขั้นตอนควรดูซ้ำตรงนี้ เพราะโทเค็นที่มันใช้คิดถูกคิดเป็นเอาต์พุต แม้คุณจะไม่เห็นมันเลย
| ราคาเอาต์พุตเทียบกับราคาอินพุต | สัดส่วนของโมเดลข้อความที่มีราคา |
|---|---|
| เท่ากันหรือถูกกว่า (1× หรือน้อยกว่า) | 10% |
| 1× ถึง 2× | 11% |
| 2× ถึง 4× | 39% |
| 4× ถึง 6× | 25% |
| มากกว่า 6× | 15% |
อะไรทำให้บิลของคุณสูงจริง
คนมักแปลกใจกับใบแจ้งหนี้ API ใบแรกด้วยเหตุผลหนึ่งในสี่ และไม่มีเหตุผลใดเป็นราคาพาดหัวของโมเดล กลไกด้านล่างเป็นจริงกับทุกผู้ให้บริการ เพราะมันตามมาจากวิธีที่ API แชตทำงาน ไม่ใช่จากนโยบายของผู้ขายรายใด
ก้อนใหญ่สุดคือการส่งบริบทซ้ำ การเรียก API ไม่มีสถานะ: โมเดลไม่จำเทิร์นก่อนหน้า ดังนั้นแอปต้องส่งบทสนทนาทั้งก้อนซ้ำทุกข้อความ เธรดที่รันมาสี่สิบเทิร์นจะส่งประวัติสี่สิบเทิร์นเป็นอินพุตในเทิร์นที่สี่สิบเอ็ด ต้นทุนของบทสนทนาจึงโตประมาณตามกำลังสองของความยาว นั่นคือเหตุผลที่เธรดยาวหนึ่งเธรดอาจแพงกว่ายี่สิบบทสั้นที่ครอบเนื้อเดียวกัน
prompt caching คือตัวถ่วง และควรเข้าใจก่อนปัดมันทิ้ง ผู้ให้บริการที่รองรับให้บริบทซ้ำถูกคิดเป็นการอ่านจากแคช แทนอินพุตใหม่ ในฟีดที่เราวัด ประมาณหนึ่งในห้าโมเดลเผยแพร่ราคาอ่านจากแคช และเมื่อมี อัตราแคชอยู่ที่ค่ามัธยฐาน 10% ของราคาอินพุตของโมเดลนั้นเอง — ต่ำสุดที่เราพบต่ำกว่า 1% สูงสุดประมาณ 58% ผู้ให้บริการบางรายยังคิดเงินเพื่อเขียนแคช โดยทั่วไปแพงกว่าอินพุตปกติ ดังนั้นแคชคุ้มเมื่อบริบทเดียวกันถูกใช้ซ้ำหลายครั้ง และไม่คุ้มเมื่อใช้ครั้งเดียว
- ประวัติบทสนทนา — ถูกส่งซ้ำทั้งก้อนทุกเทิร์น ดังนั้นเธรดยาวมีต้นทุนสูงเกินสัดส่วน
- system prompt และ preset — คำสั่งที่ใช้ซ้ำถูกแปะหน้าทุกข้อความ และคูณจำนวนโทเค็นอย่างเงียบ ๆ
- ไฟล์แนบ — เอกสารหรือรูปที่วางลงแชตกลายเป็นโทเค็นอินพุต และค้างอยู่ในบริบทของทุกเทิร์นถัดไปในเธรดนั้น
- โทเค็นการคิด — ถูกคิดเป็นเอาต์พุตบนโมเดลที่สร้างมัน ไม่ว่าการคิดจะถูกแสดงหรือไม่
- การลองใหม่และการสร้างคำตอบซ้ำ — คำตอบที่สร้างใหม่คือคำขอที่คิดเงินเต็มครั้งที่สอง ไม่ใช่การแก้ฟรี
ภูมิทัศน์ราคาของ 15 ผู้ให้บริการ
ตารางด้านล่างเป็นภาพช่วงราคาอินพุตที่เผยแพร่ของแต่ละรายใน 15 ผู้ให้บริการที่ Oriveo เชื่อมถึง มันนับเฉพาะโมเดลข้อความที่เผยแพร่ราคาต่อโทเค็นและแสดงตัวที่ถูกสุดกับแพงสุดของผู้ให้บริการนั้น มันเป็นแผนที่ว่าแต่ละรายอยู่ตรงไหน ไม่ใช่คำแนะนำ: โมเดลถูกสุดกับแพงสุดของผู้ให้บริการเดียวกันแทบใช้แทนกันไม่ได้
แหล่งที่มาและวิธี เพื่อให้คุณตรวจได้: ทุกตัวเลขมาจากฟีด metadata จากระบบจริงของ Oriveo ที่ api.oriveoai.com/api/metadata, contract version 47, สร้างเมื่อ 2026-07-24T01:00:09Z — ฟีดชุดเดียวกับที่แอปใช้คิดราคาข้อความ และชุดเดียวกับที่อยู่หลังเครื่องคำนวณต้นทุนบนเว็บนี้ ราคาเป็นดอลลาร์สหรัฐต่อหนึ่งล้านโทเค็น ณ 24 กรกฎาคม 2026 โมเดลสร้างภาพ และโมเดลที่ผู้ให้บริการคิดต่อคำขอแทนที่จะคิดต่อโทเค็นถูกตัดออก เพราะตัวเลขต่อโทเค็นจะไม่มีความหมายสำหรับมัน
มีสองเรื่องที่เด่น เรื่องแรกคือช่วงห่าง: ราคาอินพุตถูกสุดในทั้งฟีดคือ $0.01 ต่อหนึ่งล้านโทเค็นและแพงสุดคือ $150 ต่างกันหนึ่งหมื่นห้าพันเท่าระหว่างสองแถวในตัวเลือกเดียวกัน ณ 24 กรกฎาคม 2026 เรื่องที่สองคือความกว้างของแคตตาล็อกกับความถูกเป็นคนละแกน — aggregator กว้างสุดเพราะขายต่อหลายผู้ขาย ขณะที่ผู้ให้บริการเจ้าเดียวกระจุกแน่นรอบชั้นราคาของตัวเอง
ถือทุกตัวเลขที่นี่ว่าเปลี่ยนได้ ผู้ให้บริการปรับราคา เปิดชั้นที่ถูกกว่า และปลดโมเดลตลอดเวลา หลายแถวด้านล่างเปลี่ยนภายในไตรมาสที่ผ่านมา บทความใดที่อ้างราคาโมเดลคือภาพถ่าย นั่นคือเหตุผลที่ฟีดสดและเครื่องคำนวณมีอยู่ และเหตุผลที่หน้านี้ระบุวันที่จับภาพ แทนที่จะทำให้เข้าใจว่าตัวเลขถาวร
| ผู้ให้บริการ | โมเดลข้อความที่มีราคาโทเค็นเผยแพร่ | อินพุตต่ำสุด (USD / 1 ล้าน) | อินพุตสูงสุด (USD / 1 ล้าน) |
|---|---|---|---|
| OpenAI | 49 | 0.05 | 150 |
| Anthropic (Claude) | 10 | 1.00 | 15 |
| Google Gemini | 21 | 0.075 | 2.00 |
| xAI Grok | 6 | 1.00 | 2.00 |
| DeepSeek | 4 | 0.14 | 0.435 |
| Mistral | 32 | 0.04 | 2.00 |
| Qwen | 49 | 0.035 | 2.80 |
| Kimi | 9 | 0.20 | 2.00 |
| MiniMax | 7 | 0.30 | 0.60 |
| Z.ai | 12 | 0.07 | 1.40 |
| Groq | 7 | 0.03 | 0.59 |
| Together AI | 69 | 0.02 | 3.50 |
| Fireworks AI | 15 | 0.07 | 2.80 |
| OpenRouter | 305 | 0.01 | 150 |
| SiliconFlow | 49 | 0.04 | 1.74 |
ทำไมโมเดลเดียวกันมีมากกว่าหนึ่งราคา
เปิดไดเรกทอรีโมเดลสองที่ แล้วคุณจะเจอโมเดลเดียวกันอยู่ในอัตราต่างกัน นั่นมักไม่ใช่ความผิดพลาด โมเดล open-weight ถูกให้บริการโดยโฮสต์ inference หลายราย แต่ละรายมีฮาร์ดแวร์ ปริมาณงาน และส่วนต่างของตัวเอง ดังนั้นโมเดลหนึ่งมีราคาหนึ่งอย่างบนโฮสต์หนึ่ง และอีกอย่างบนอีกโฮสต์ได้อย่างชอบธรรม ในฟีดด้านบน ตระกูล open-weight เดียวกันโผล่ที่ผู้ให้บริการหลายรายในอัตราที่ต่างกันจริง
เหตุผลที่สองคือชั้นที่คุณซื้อผ่าน aggregator นั่งอยู่ระหว่างคุณกับผู้ให้บริการข้างใต้ และต้องมีรายได้จากจุดนั้น — ผ่านส่วนต่างบนราคาโทเค็น, ค่าธรรมเนียมเติมยอด, เปอร์เซ็นต์บนคำขอ หรือระบบ credit ที่การแปลงเป็นโทเค็นถูกกำหนดโดยแพลตฟอร์ม ไม่ใช่โดยตารางราคาของผู้ให้บริการ ไม่มีแบบใดแย่ในตัวเอง สิ่งที่สำคัญคือกลไกถูกเผยแพร่หรือไม่ ตัวอย่างเช่น OpenRouter เปิดเงื่อนไขไว้ตรง ๆ: ณ 24 กรกฎาคม 2026 นโยบายที่เผยแพร่คือค่าธรรมเนียม 5.5% บนการเติมด้วยบัตร โดยมีขั้นต่ำ $0.80 และสำหรับ key ที่คุณนำมาเอง หนึ่งล้านคำขอแรกของแต่ละเดือนไม่คิดเงิน และเกินจากนั้นหัก 5% ของราคาปกติของโมเดลเป็น credits
เมื่อคุณเทียบแพลตฟอร์ม คำถามที่ควรถามไม่ใช่ “credit หนึ่งหน่วยเท่าไร” แต่คือ “มีเส้นทางที่เผยแพร่ไว้จาก list price ของผู้ให้บริการไปถึงสิ่งที่คุณถูกเรียกเก็บหรือไม่” ถ้าแพลตฟอร์มคิดเป็น credits และไม่เผยแพร่การแปลงนั้น สิ่งที่คุณเทียบไม่ใช่ราคาของโมเดล — มันคือนโยบายราคาของแพลตฟอร์ม และนโยบายนั้นเปลี่ยนได้โดยที่ราคาของโมเดลไม่เปลี่ยนเลย
สมัครสมาชิกหรือจ่ายตามใช้: อันไหนถูกกว่าสำหรับคุณ
นี่คือคำถามที่คนส่วนใหญ่ตั้งใจมาถาม และมันไม่มีคำตอบทั่วไป การสมัครสมาชิกแบบเหมาจ่ายรายเดือนกับการเข้าถึง API ที่คิดตามใช้จะคุ้มเท่ากันเมื่อถึงปริมาณการใช้ระดับหนึ่ง และจุดนั้นขึ้นกับข้อความของคุณเอง: ยาวแค่ไหน คำตอบยาวแค่ไหน คุณเลือกโมเดลใด และเธรดรันยาวแค่ไหน ใครที่บอกว่าประหยัดได้กี่เปอร์เซ็นต์ทั้งที่ไม่มีตัวเลขของคุณ กำลังเดา
คุณคำนวณได้ในประมาณห้านาที และเลขไม่ยาก เอาสัปดาห์ที่เป็นแบบฉบับจริง ไม่ใช่สัปดาห์ที่ยุ่งสุด นับข้อความ ประมาณความยาวเฉลี่ยของคำตอบที่คุณได้เป็นคำ แล้วคูณด้วยประมาณ 1.35 เพื่อได้โทเค็นบวกฝั่งอินพุต โดยจำว่าแต่ละเทิร์นส่งเธรดจนถึงตอนนั้นซ้ำ คูณด้วยอัตราอินพุตและเอาต์พุตที่เผยแพร่ของโมเดล แล้วเทียบกับค่าธรรมเนียมรายเดือนที่คุณกำลังดู เครื่องคำนวณต้นทุนบนเว็บนี้ทำเรื่องนี้กับราคาสด เพื่อที่คุณจะได้ไม่ต้องเก็บอัตราเอง
มีรูปแบบโครงสร้างไม่กี่แบบที่นิ่งพอจะพูดได้โดยไม่ต้องแต่งตัวเลข การคิดตามใช้มักชนะเมื่อใช้เบาหรือเป็นช่วง ๆ เมื่อคุณใช้หลายโมเดลเป็นครั้งคราวแทนที่จะใช้ตัวเดียวหนัก ๆ และเมื่องานส่วนใหญ่เป็นคำถามสั้นกับคำตอบสั้น การสมัครสมาชิกมักชนะเมื่อปริมาณสูงสม่ำเสมอทุกวัน และมันมีข้อดีที่ไม่ใช่เงินจริง ๆ: บิลที่คาดได้ การคิดตามใช้โดยไม่เห็นต้นทุนต่อข้อความคือข้อเสียของทั้งสองแบบรวมกัน ซึ่งเป็นความล้มเหลวที่ค่าประมาณต้นทุนบนแต่ละข้อความมีไว้ป้องกันพอดี
วิธีลดสิ่งที่คุณจ่ายได้จริง
เมื่อคุณเห็นมาตรวัดแล้ว ส่วนใหญ่ของเงินที่ประหยัดได้มาจากนิสัยจำนวนน้อย ไม่ใช่จากการไล่หาผู้ให้บริการที่ถูกสุด โดยเรียงคร่าว ๆ ตามที่มันขยับตัวเลข สำหรับงานแชตทั่วไป:
สิ่งที่มักไม่ได้ผลคือย้ายทุกอย่างไปโมเดลถูกสุดในแคตตาล็อก โมเดลที่ต้องลองสามครั้งกว่าคำตอบจะถูก ในราคาแค่หนึ่งในห้า ไม่ใช่การประหยัด และมันยังกินเวลาคุณด้วย คำแนะนำที่ใช้ได้จริงคือจับคู่โมเดลกับงาน — โมเดลถูกสำหรับดึงข้อมูล จัดรูปแบบ สรุป และแปล ส่วนโมเดลแพงสำหรับงานที่คุณยอมจ่ายให้คนทำ
- เริ่มบทสนทนาใหม่เมื่อเป็นหัวข้อใหม่ นี่คือตัวที่ลดบิลได้มากสุด เพราะมันหยุดการจ่ายเพื่อส่งประวัติที่ไม่เกี่ยวกับเรื่องซ้ำ
- ขอคำตอบที่สั้นลงเมื่อคุณอยากได้คำตอบสั้น เอาต์พุตเป็นมาตรวัดที่แพงกว่าบนประมาณเก้าในสิบโมเดล
- จับคู่โมเดลกับงาน แทนที่จะใช้ตัวที่เก่งสุดเป็นค่าเริ่มต้นกับทุกอย่าง
- รักษา system prompt และ preset ที่ใช้ซ้ำให้กระชับ — มันถูกคิดเงินบนทุกข้อความที่ใช้มัน
- ใช้ prompt caching เมื่อผู้ให้บริการรองรับ และคุณใช้บริบทยาวชุดเดิมซ้ำ ๆ
- เอาไฟล์แนบออกจากเธรดเมื่อใช้เสร็จ แทนที่จะแบกมันไปทุกเทิร์นถัดไป
- ดูค่าประมาณบนข้อความหนึ่งก่อนทำรูปแบบนั้นซ้ำเป็นร้อยครั้ง
Oriveo แสดงต้นทุนให้คุณเห็นอย่างไร
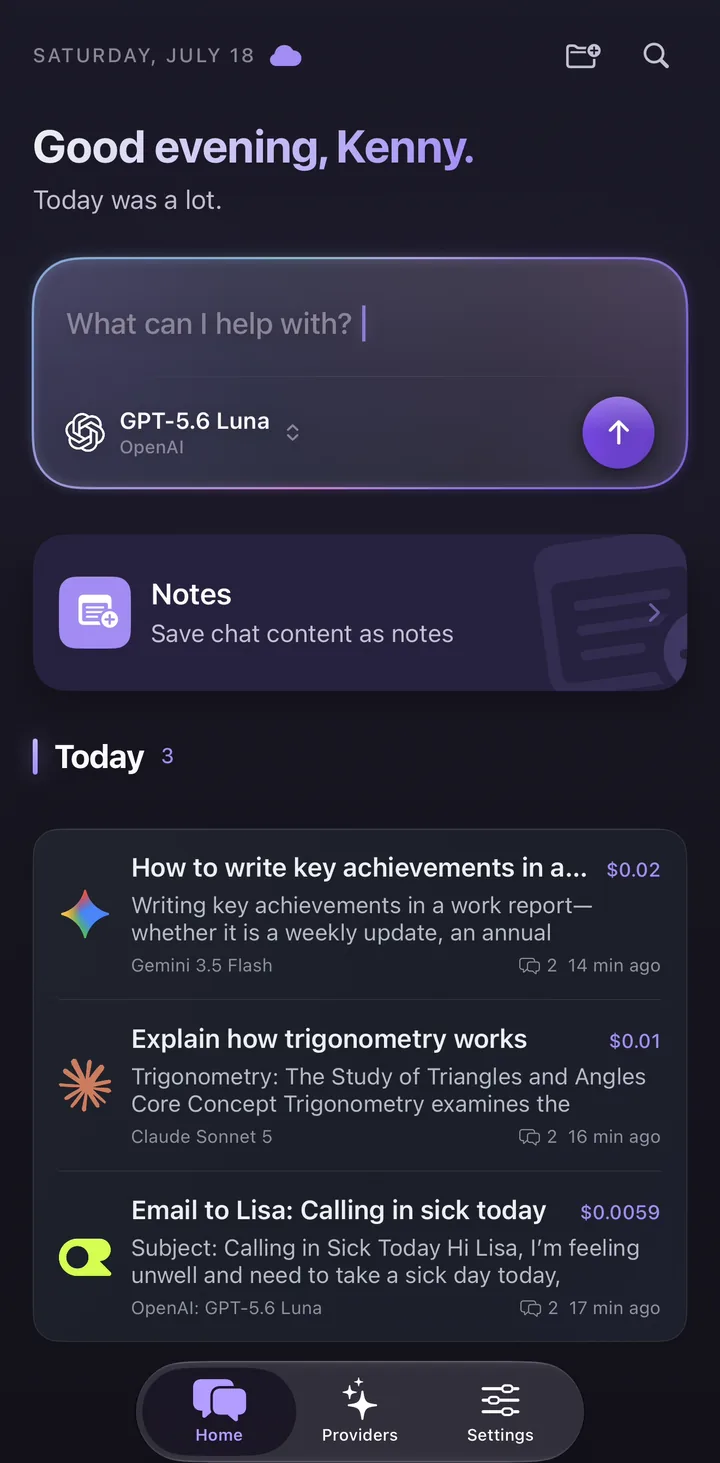
ทุกข้อความใน Oriveo มีต้นทุนโดยประมาณ คำนวณจากราคาโทเค็นที่ผู้ให้บริการประกาศ และจากโทเค็นที่ถูกรายงานจริง ในจังหวะที่คำตอบจบ ค่าประมาณนั้นมีบนทุกระดับ รวมระดับที่ไม่ต้องล็อกอิน เพราะต้นทุนที่เห็นได้เฉพาะบนแพ็กเกจเสียเงินไม่ช่วยให้คุณตัดสินว่าจะจ่ายอะไรหรือไม่ ฟีด metadata ชุดเดียวกับที่ใช้ในตารางด้านบนคือสิ่งที่ส่งราคาเหล่านั้น นั่นคือเหตุผลที่แอปไม่ต้องให้คุณดูแลตารางราคาเอง
มันเป็นค่าประมาณ และมันถูกติดป้ายว่าเป็นเช่นนั้น ผู้ให้บริการใช้การปัดเศษ หน่วยคิดเงินขั้นต่ำ อัตราเฉพาะบัญชี และราคาโปรโมชันเป็นครั้งคราวของตนเอง และจำนวนโทเค็นถูกรายงานโดยผู้ให้บริการในภายหลัง ค่าประมาณมีไว้คุมการตัดสินระหว่างเดือน ใบแจ้งหนี้ของผู้ให้บริการคือคำตัดสินสุดท้าย และเมื่อสองฝ่ายไม่ตรงกัน ใบแจ้งหนี้ถูก
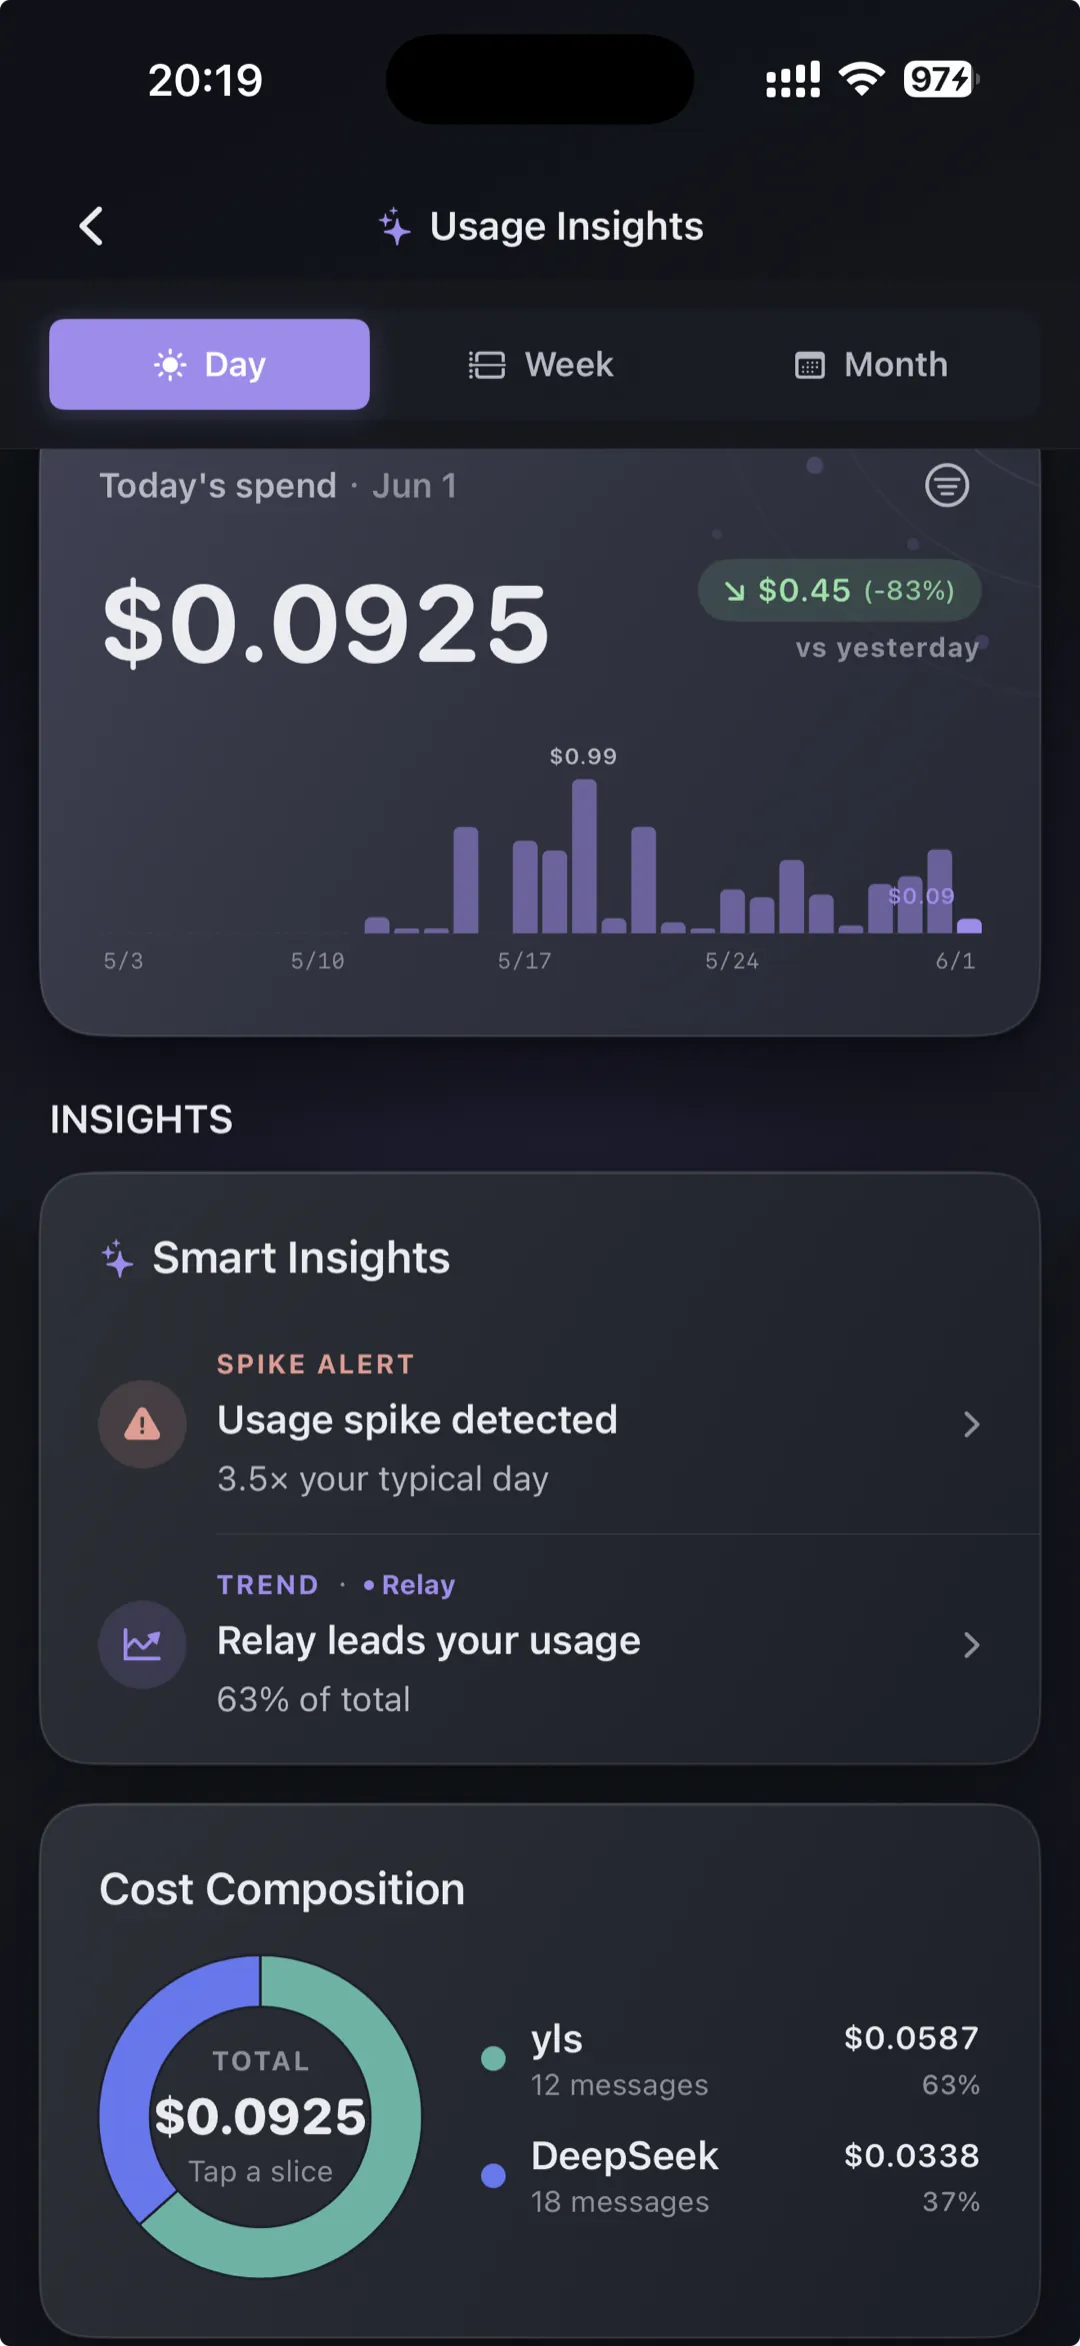
การวิเคราะห์ที่ลึกกว่าอยู่หลังแพ็กเกจเสียเงิน Usage Insights — ค่าใช้ที่แยกตามผู้ให้บริการและโมเดล แนวโน้มรายเดือน และการแจ้งเตือนงบประมาณ — เป็นส่วนของ Pro และ Lifetime ซึ่งมีราคา $9.99 ต่อเดือน, $59.99 ต่อปี หรือ $149.99 จ่ายครั้งเดียว ณ 24 กรกฎาคม 2026 แพ็กเกจเหล่านั้นซื้อฟีเจอร์ซอฟต์แวร์เท่านั้น: ไม่รวมการใช้งาน AI ไม่มี credit ของโมเดล และไม่มีการสมัครสมาชิกผู้ให้บริการ ดังนั้นราคาของแอปกับราคาโทเค็นของคุณไม่เคยถูกรวมเป็นตัวเลขเดียวที่แยกไม่ออก
ตัวเลขเหล่านี้บอกคุณไม่ได้เรื่องอะไร
ตารางราคาคือจุดเริ่ม ไม่ใช่การตัดสิน มีสามเรื่องที่มันทิ้งไว้นอกตาราง และควรพูดให้ชัด เพราะมันพลิกการเทียบที่ดูเหมือนจบแค่เรื่องราคาได้เป็นประจำ
เรื่องแรกคือโทเค็นต่องาน สองโมเดลในอัตราเดียวกันอาจต่างกันมากว่าใช้กี่โทเค็นกว่าจะถึงคำตอบเดียวกัน และโมเดลถูกที่พูดเยิ่นเย้ออาจแพงต่องานที่เสร็จกว่าโมเดลแพงที่ตอบสั้น เรื่องที่สองคืออัตราการลองใหม่: คำตอบที่คุณต้องสร้างซ้ำถูกคิดเงินสองครั้ง เรื่องที่สามคือทุกอย่างนอกมาตรวัดโทเค็น — ขีดจำกัดอัตรา ความหน่วง หน้าต่างบริบท ความพร้อมใช้ในภูมิภาคของคุณ และโมเดลอ่านรูปแบบไฟล์ที่คุณใช้ได้หรือไม่
วิธีใช้การเทียบแบบนี้อย่างตรงไปตรงมาคือใช้เป็นตัวกรองรายการสั้น ตัดแถวที่อยู่นอกงบชัด ๆ ลองสองหรือสามตัวกับงานจริงของคุณ แล้วดูว่างานที่เสร็จมีต้นทุนเท่าไร ไม่ใช่หนึ่งล้านโทเค็นมีต้นทุนเท่าไร ค่าประมาณต่อข้อความมีอยู่เพื่อให้การทดลองนี้ใช้เวลาหนึ่งวัน ไม่ใช่หนึ่งรอบบิล
คำถามที่พบบ่อย
ข้อความหนึ่งไปยัง LLM API มีต้นทุนจริงเท่าไร?
ทำไมเอาต์พุตถึงแพงกว่าอินพุต?
prompt caching ลดบิลได้จริงไหม?
API แบบจ่ายตามใช้ถูกกว่าการสมัคร AI รายเดือนไหม?
ทำไมโมเดลเดียวกันถึงมีราคาต่างกันบนแพลตฟอร์มต่างกัน?
ราคาในบทความนี้ปัจจุบันแค่ไหน?
Oriveo บวก markup บนสิ่งที่ผู้ให้บริการคิดไหม?
อ่านต่อ
เห็นต้นทุนของแต่ละข้อความตอนที่ส่ง
Oriveo แสดงต้นทุนโดยประมาณบนทุกข้อความตาม list price ของผู้ให้บริการ ครอบคลุมผู้ให้บริการทางการ 15 รายและ 700+ โมเดล บน iPhone, Android และเว็บ — ไม่บวก markup บนการใช้งานผู้ให้บริการ