AI APIの料金比較:LLMの価格はどう決まるか
LLM APIの料金は何で決まり、何が請求額を押し上げるのか。15社の入力・出力の価格帯を、2026年7月24日時点の実データで見ていきます。
- LLMのAPIは最大4つのメーターで別々に課金しますが、料金比較の多くは、そのうち1つしか見ていません。
- 出力トークンの費用は、中央値で入力トークンの4倍、最大で12倍です。
- 15社が公表している入力価格は、2026年7月24日時点で、100万トークンあたり$0.01から$150までと幅があります。
LLM APIの料金は、実際どう動くか
「ai api cost」や「llm api pricing comparison」で出てくる比較の多くは、モデルごとに数字を1つだけ載せていて、それはほとんどの場合、入力価格です。ところが、プロバイダーが公表している4つの数字のうち、いちばん参考にならないのが入力価格です。モデルの料金は、別々のメーターで計算されるからです。送り込むトークン、書き戻すトークン、キャッシュから読み込むトークン、そして一部のプロバイダーでは、そのキャッシュに書き込むトークン。メーターごとに料金があり、それぞれ大きく違います。
トークンは英単語のおよそ4分の3の長さなので、100万トークンは75万語ほどです。価格が100万トークン単位で示されるのは、1通ごとのメッセージがあまりに安く、1通あたりの価格にするとゼロばかりが並んでしまうからです。ただし、この見せ方は、実際の会話でメーターがどれだけ速く積み上がるかを見えにくくします。1回ごとに、それまでのやり取りがすべて送り直されるからです。
下の表は、いくつかのモデルについて4つのメーターをすべて示したものです。このサイトのモデル選択画面と費用計算ツールを動かしているのと同じメタデータから取っています。入力の列だけでは、情報がどれだけ足りないかに注目してください。この表では、入力価格が0.30〜2.50ドルなのに対して、出力価格は1.20〜15.00ドルまで開いていて、いちばん大きく動くのは出力です。
- 入力:送るものすべて。自分のメッセージ、それまでの会話、システムプロンプト、添付したテキスト。
- 出力:モデルが書き戻すものすべて。推論の過程を出力するモデルでは、推論トークンも含みます。
- キャッシュ入力の読み取り:プロバイダーがすでに見た、繰り返しの文脈。新しい入力よりずっと低い料金で請求されます。
- キャッシュ書き込み:その文脈を最初にキャッシュに置くために、一部のプロバイダーが課金するもの。
| モデル | 入力(USD / 100万トークン) | 出力(USD / 100万トークン) | キャッシュ入力の読み取り | キャッシュ書き込み |
|---|---|---|---|---|
| Claude Haiku 4.5 | 1.00 | 5.00 | 0.10 | 1.25 |
| Claude Sonnet 5 | 2.00 | 10.00 | 0.20 | 2.50 |
| GPT-5.6 Luna | 1.00 | 6.00 | 0.10 | 1.25 |
| GPT-5.6 Terra | 2.50 | 15.00 | 0.25 | 3.125 |
| Kimi k2.5 | 0.60 | 3.00 | 0.10 | 0.60 |
| Qwen3.7 Plus | 0.50 | 3.00 | 0.05 | 0.625 |
| MiniMax-M2.5 | 0.30 | 1.20 | 0.03 | 0.375 |
高いのは出力トークン
LLMの料金で、最も安定しているパターンは、書くほうが読むより高い、ということです。感覚ではなく数字で示すために、Oriveoのメタデータに載っていて、トークン単価が公表されているすべてのテキストモデル(15社すべてが対象)を取り、各モデルの出力の料金を、そのモデル自身の入力の料金と比べました。時点は2026年7月24日です。
中央値のモデルは、出力を入力のちょうど4倍で課金します。およそ10モデルに1つは、入力と出力が同じか、出力のほうが安く、これは推論サービス各社が提供するオープンウェイトのモデルによく見られます。反対側では、およそ7モデルに1つが6倍を超え、メタデータ内で最も差が大きいものは12倍です。
これは、支出の仕方に直結します。プロンプトを削るのは、誰もが最初に手をつける節約ですが、たいていは効果の小さいほうです。もっと短い回答を求める、出力の長さに上限を付ける、長々と考え込まないモデルを選ぶ、といったことのほうが、質問から1段落を削るより、請求額を大きく動かします。推論モデルは、ここで見直す価値があります。生成される思考のトークンは、目に見えなくても出力として課金されるからです。
| 出力価格と入力価格の比較 | 単価のあるテキストモデルに占める割合 |
|---|---|
| 同じかより安い(1倍以下) | 10% |
| 1倍〜2倍 | 11% |
| 2倍〜4倍 | 39% |
| 4倍〜6倍 | 25% |
| 6倍を超える | 15% |
請求額を実際に動かすもの
最初のAPI請求書に驚く原因は、たいてい次の4つのどれかで、モデルの表向きの価格ではありません。以下の仕組みは、どのプロバイダーにも当てはまります。特定の会社の方針ではなく、チャットAPIの動き方から来るからです。
最大の要因は、文脈の送り直しです。API呼び出しには状態がありません。モデルは前のやり取りを覚えていないので、クライアントは、メッセージのたびに会話全体を送り直さなければなりません。40往復続いたスレッドは、41回目の入力として、40往復分の履歴を送ります。したがって、会話の費用は、長さのおよそ2乗で増えていきます。同じ内容を扱うのでも、1本の長いスレッドが、20本の短いスレッドより高くなることがあるのは、そのためです。
プロンプトキャッシュは、それに対抗する仕組みで、切り捨てる前に理解しておく価値があります。対応するプロバイダーでは、繰り返される文脈を、新しい入力ではなくキャッシュの読み取りとして請求できます。調べた範囲では、およそ5モデルに1つがキャッシュ読み取りの料金を公表していて、その料金は、そのモデル自身の入力価格に対して、中央値で10%です。見つかった最低は1%未満、最高はおよそ58%でした。一部のプロバイダーは、キャッシュへの書き込みにも課金し、たいていは通常の入力より割高です。ですから、キャッシュが元を取れるのは、同じ文脈を何度も使い回すときで、1回しか使わないときではありません。
- 会話の履歴:毎回全文が送り直されるので、長いスレッドは、割に合わないほど高くなります。
- システムプロンプトとプリセット:繰り返し使う指示は、すべてのメッセージの先頭に付くので、トークン数がこっそり増えます。
- 添付:チャットに置いた文書や画像は入力トークンになり、そのスレッドのあとのすべてのやり取りで文脈に残ります。
- 推論トークン:それを生成するモデルでは、出力として課金されます。推論が画面に表示されるかどうかは関係ありません。
- 再試行と再生成:再生成した回答は、無料の修正ではなく、全額課金される2回目のリクエストです。
15社の価格の全体像
下の表は、Oriveoがつなぐ15のプロバイダーそれぞれについて、公表されている入力価格の範囲をスナップショットにしたものです。数えるのは、トークン単価が公表されているテキストモデルだけで、そのプロバイダーで最も安いモデルと最も高いモデルを示します。各プロバイダーがどの価格帯にいるかを示す地図で、おすすめではありません。同じプロバイダーの中でも、最も安いモデルと最も高いモデルは、たいてい互いの代わりにはなりません。
出典と方法も書いておきます。確認できるようにするためです。数字はすべて、Oriveoの本番のメタデータ(api.oriveoai.com/api/metadata、contract version 47、生成時刻 2026-07-24T01:00:09Z)から取りました。アプリがメッセージの価格を出すのと同じもので、このサイトの費用計算ツールの背後にあるものと同じです。価格は100万トークンあたりの米ドルで、2026年7月24日時点です。画像生成モデルと、トークンではなくリクエスト単位で価格を付けているモデルは除いています。それらにトークン単価は意味をなさないからです。
目立つ点が2つあります。1つ目は、幅の広さです。全体で最も安い入力価格は100万トークンあたり$0.01、最も高いのは$150で、2026年7月24日時点で、同じ選択画面の2つのモデルの間に15,000倍の差があります。2つ目は、カタログの広さと安さは別の軸だということです。中継サービスが最も幅広いモデルを載せているのは、多くの開発元のモデルを再販しているからで、1社だけのプロバイダーは、自社の価格帯の周りに狭くまとまります。
ここに載せた数字はすべて、すぐに古くなるものとして扱ってください。プロバイダーは価格を見直し、もっと安いプランを出し、モデルを次々と終了します。下の表のいくつかの行も、ここ数か月で変わりました。モデルの価格を載せた記事は、どれも写真のようなものです。ライブのデータと計算ツールがあるのはそのためで、このページが数字を永遠のもののように書かず、取得した日を明記しているのもそのためです。
| プロバイダー | トークン単価が公表されているテキストモデル数 | 最低入力(USD / 100万) | 最高入力(USD / 100万) |
|---|---|---|---|
| OpenAI | 49 | 0.05 | 150 |
| Anthropic (Claude) | 10 | 1.00 | 15 |
| Google Gemini | 21 | 0.075 | 2.00 |
| xAI Grok | 6 | 1.00 | 2.00 |
| DeepSeek | 4 | 0.14 | 0.435 |
| Mistral | 32 | 0.04 | 2.00 |
| Qwen | 49 | 0.035 | 2.80 |
| Kimi | 9 | 0.20 | 2.00 |
| MiniMax | 7 | 0.30 | 0.60 |
| Z.ai | 12 | 0.07 | 1.40 |
| Groq | 7 | 0.03 | 0.59 |
| Together AI | 69 | 0.02 | 3.50 |
| Fireworks AI | 15 | 0.07 | 2.80 |
| OpenRouter | 305 | 0.01 | 150 |
| SiliconFlow | 49 | 0.04 | 1.74 |
同じモデルなのに価格が複数ある理由
2つのモデル一覧を開くと、同じモデルが違う料金で並んでいることがあります。それは、たいてい間違いではありません。オープンウェイトのモデルは、複数の推論サービスが提供していて、それぞれにハードウェア、処理能力、利益の取り方が違うので、あるモデルがあるサービスではある金額、別のサービスでは別の金額、ということが正当に起こります。上のデータでも、同じオープンウェイトのモデルの系列が、複数のプロバイダーで本当に違う料金で並んでいます。
2つ目の理由は、購入するときに間に入る層です。中継サービスは、あなたと下のプロバイダーの間に入り、その立場を何らかの形で運営費に充てなければなりません。トークン価格の上乗せ、チャージの手数料、リクエストへの割合、あるいはトークンへの換算が、プロバイダーの料金表ではなくサービス側で決められるクレジットの仕組みです。どれも、それ自体が悪いわけではありません。大事なのは、仕組みが公開されているかどうかです。たとえばOpenRouterは、条件をオープンに文書化しています。2026年7月24日時点で公表されている方針は、カードでのチャージに5.5%の手数料(最低$0.80)、自分で持ち込むキーについては毎月最初の100万リクエストが無料で、それを超えるとモデルの通常価格の5%がクレジットから差し引かれる、というものです。
サービスを比べるとき、問う価値があるのは「1クレジットはいくらか」ではなく、「プロバイダーの公式の料金から、自分が請求される金額まで、どんな道筋が公開されているか」です。サービス側がクレジットで価格を付け、その換算を公開していないなら、比べているのはモデルの価格ではありません。サービス側の料金方針との比較で、その方針は、モデルの価格がまったく変わらなくても変わりえます。
サブスクと従量課金:自分にはどちらが安いか
多くの人が本当に知りたいのがこの問いで、万人に当てはまる答えはありません。月額固定のサブスクと、従量制のAPI利用は、ある利用量のところで逆転し、その分かれ目は、自分のメッセージで決まります。どれだけ長く書くか、回答がどれだけ長いか、どのモデルを選ぶか、スレッドをどれだけ長く続けるか。自分の数字なしに「何割安くなる」と言う人は、推測で話しています。
計算は5分ほどでできて、難しくありません。いちばん忙しい週ではなく、ごく普通の週を選んでください。メッセージ数を数えます。返ってくる回答の平均の長さを語数で見積もり、およそ1.35を掛けてトークンにします。入力側も足してください。1回ごとに、それまでのスレッドが送り直されることを忘れずに。そのモデルが公表している入力と出力の料金を掛け、検討している月額料金と比べます。このサイトの費用計算ツールなら、最新の価格でこれを計算してくれるので、料金を自分で追いかける必要はありません。
数字をでっち上げなくても言える、比較的安定した傾向がいくつかあります。従量制が有利になりやすいのは、使う量が少ない、または波があるとき、1つのモデルをたっぷり使うのではなく複数のモデルをときどき使うとき、作業の多くが短い質問と短い回答のときです。サブスクが有利になりやすいのは、毎日安定して多く使うときで、お金以外にも本当のメリットがあります。請求額が読めることです。メッセージごとの費用が見えない従量制は、両方の悪いところを合わせたようなもので、メッセージごとの費用の目安は、まさにその状態を防ぐためのものです。
支出を実際に減らす方法
メーターが見えるようになれば、節約のほとんどは、いちばん安いプロバイダーを探すことではなく、いくつかの習慣から生まれます。ふつうのチャットの使い方で、数字をどれだけ動かすか、効果の大きい順に並べました。
たいてい効果がないのは、すべてをカタログで最も安いモデルに切り替えることです。5分の1の価格でも、正しい答えが出るまでに3回かかるモデルは、節約になるどころか、時間まで取られます。この助言の実用的な形は、作業に合わせてモデルを選ぶことです。抽出、整形、要約、翻訳には安いモデルを、以前なら人に頼んでいたような仕事には高いモデルを。
- 新しい話題は、新しい会話で始める。これが1つで最大の節約になります。関係のない履歴を送り直すために払うのをやめられるからです。
- 短い回答がほしいときは、短い回答を求める。およそ10モデル中9つで、出力のほうが高いメーターです。
- すべてに最強のモデルを使うのではなく、作業に合わせてモデルを選ぶ。
- システムプロンプトと、繰り返し使うプリセットは、短く保つ。それを使うすべてのメッセージで課金されるからです。
- プロバイダーが対応していて、同じ長い文脈を繰り返し使うなら、プロンプトキャッシュを使う。
- 添付は、用が済んだらスレッドから外す。あとのすべてのやり取りに、抱え続けない。
- そのパターンを100回繰り返す前に、メッセージごとの概算を確認する。
Oriveoは費用をどう見せるか
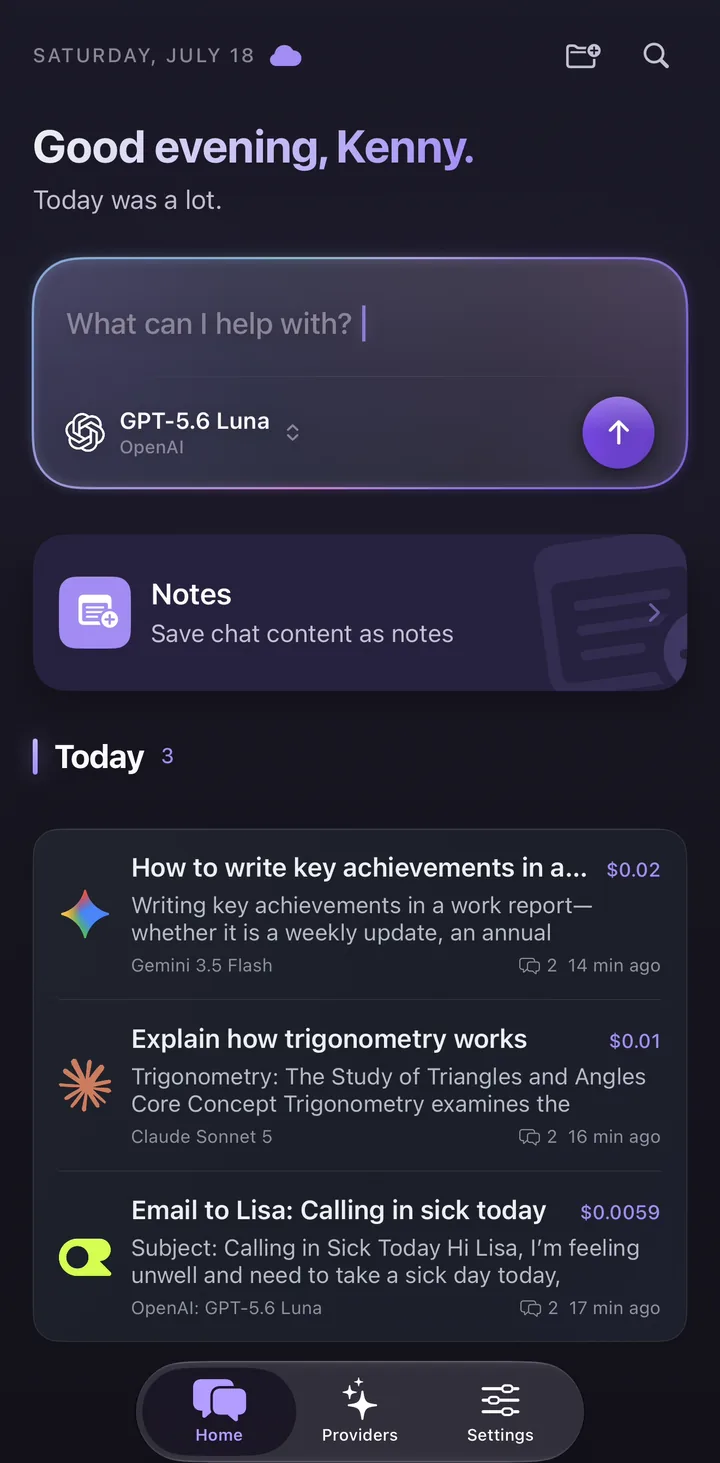
Oriveoのすべてのメッセージには概算コストが付き、回答が終わった瞬間に、プロバイダーが公表しているトークン単価と、実際に報告されたトークン数から計算されます。この概算は、サインインしない使い方も含め、すべての型で使えます。有料プランでしか見えない費用は、何かにお金を払うかどうかを決める助けにならないからです。上の表に使ったのと同じメタデータがそれらの価格を供給するので、アプリの側で価格表を自分で管理する必要はありません。
それは概算で、概算だと明記しています。プロバイダーは、独自の端数処理、最小の請求単位、アカウントごとの料金、ときどきのキャンペーン価格を適用し、トークン数は事後にプロバイダーが報告します。概算は、月の途中で、お金の使い方の方向を判断するためのものです。最終的な金額はプロバイダーの請求書が基準で、両者が食い違うときは請求書が正しいです。
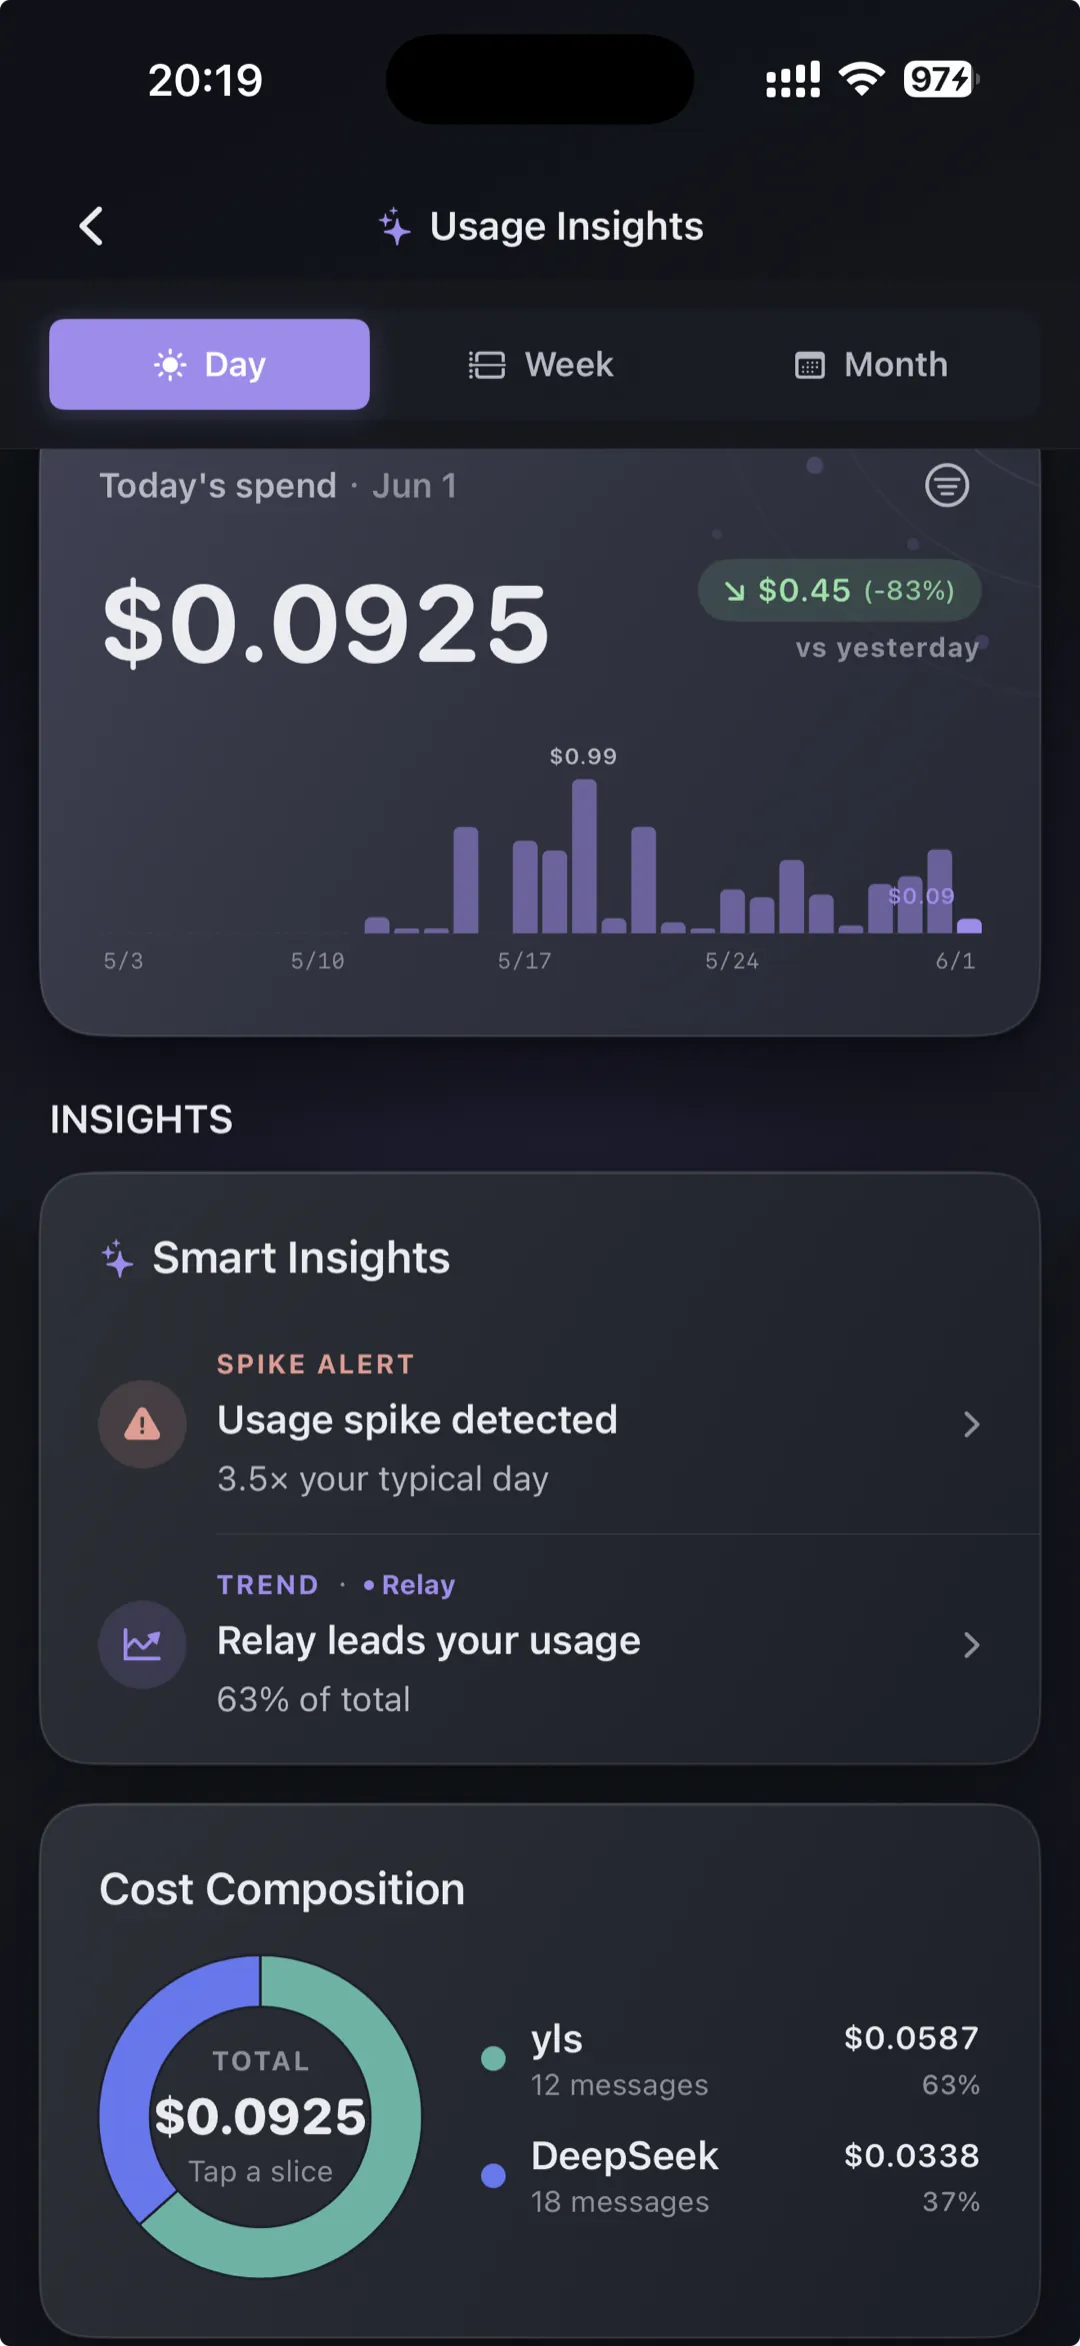
より詳しい分析は、有料プランの機能です。Usage Insights(プロバイダー別・モデル別の支出、月ごとの推移、予算アラート)はProとLifetimeの一部で、2026年7月24日時点で月額$9.99、年額$59.99、または買い切り$149.99です。これらのプランで買えるのは、ソフトウェアの機能だけです。AIの利用料も、モデルのクレジットも、プロバイダーのサブスクも含まれないので、アプリの価格とトークンの価格が、切り分けられない1つの数字にまとめられることはありません。
これらの数字では分からないこと
価格の表は、出発点であって、結論ではありません。表が省いている3つのことは、はっきり書いておく価値があります。価格だけで決まったように見えた比較が、これでひっくり返ることがよくあるからです。
1つ目は、作業あたりのトークン数です。同じ料金の2つのモデルでも、同じ答えにたどり着くまでに使うトークン数は大きく違うことがあり、回りくどい安いモデルは、簡潔な高いモデルより、1つの仕事あたりで高くつくことがあります。2つ目は、やり直しの割合です。再生成しなければならない回答は、2回課金されます。3つ目は、トークンのメーターの外にあるすべてです。利用回数の制限、応答の速さ、コンテキストウィンドウ、自分の地域で使えるかどうか、仕事で使うファイル形式をモデルが読めるか。
こうした比較の正しい使い方は、候補を絞るフィルターとして使うことです。予算を明らかに超える行を外し、自分の実際の仕事で2つか3つの候補を試し、100万トークンがいくらかではなく、終わった作業がいくらかを見てください。メッセージごとの概算があるのは、まさにこの試しを、請求期間の終わりではなく、1日で済ませるためです。