AI API 費用比較:LLM 定價實際怎麼算
LLM API 的價錢實際由什麼組成、什麼在推高帳單,以及 15 家供應商真實的輸入與輸出價區間。數字取自 2026 年 7 月 24 日。
- LLM API 最多分成四個計費項目收費,多數價格比較只看了其中一個。
- 輸出 token 的價格中位數是輸入的四倍,最大可以到十二倍。
- 截至 2026 年 7 月 24 日,15 家供應商公示的輸入價,從每百萬 token $0.01 到 $150。
LLM API 的價錢實際怎麼算
幾乎每篇 AI API 費用比較,每個模型都只列一個數字,而且幾乎總是輸入價。它是供應商公布的四個數字裡,參考價值最低的一個。模型是分項計費的:你送進去的 token、它寫回來的 token、從快取讀到的 token,以及部分供應商要另外收費的、寫進快取的 token。每一項都有自己的費率,彼此差很多。
一個 token 大約是四分之三個英文單字,所以一百萬 token 大約是 750,000 個字。價格是按每百萬 token 報,因為單則訊息便宜到如果按則報價,數字會小到幾乎全是零。這種標示方式看不出真實對話裡費用累積得有多快:每一輪都會把前面說過的內容全部再送一次。
下面這張表列出幾個模型的四項計費價格,資料取自本站模型選單和費用計算機所用的同一份 metadata feed。要注意,輸入那一欄能告訴你的其實很少:這裡的輸入價落在 0.30 到 2.50 美元之間,輸出價卻從 1.20 拉到 15.00 美元,而輸出正是變動最大的一項。
- 輸入:你送出的一切。你的訊息、到目前的對話、任何 system prompt、任何附上的文字。
- 輸出:模型寫回來的一切,包含會產生 reasoning token 的模型上那些 token。
- 快取輸入讀取:供應商已經看過的重複上下文,費率比全新輸入低很多。
- 快取寫入:有些供應商為了把那段上下文放進快取,一開始就收的費用。
| 模型 | 輸入(USD / 1M tokens) | 輸出(USD / 1M tokens) | 快取輸入讀取 | 快取寫入 |
|---|---|---|---|---|
| Claude Haiku 4.5 | 1.00 | 5.00 | 0.10 | 1.25 |
| Claude Sonnet 5 | 2.00 | 10.00 | 0.20 | 2.50 |
| GPT-5.6 Luna | 1.00 | 6.00 | 0.10 | 1.25 |
| GPT-5.6 Terra | 2.50 | 15.00 | 0.25 | 3.125 |
| Kimi k2.5 | 0.60 | 3.00 | 0.10 | 0.60 |
| Qwen3.7 Plus | 0.50 | 3.00 | 0.05 | 0.625 |
| MiniMax-M2.5 | 0.30 | 1.20 | 0.03 | 0.375 |
貴的那一半是輸出 token
LLM 定價裡最穩定的規律是「寫比讀貴」。為了給出具體的數字而不是印象,我們取 Oriveo metadata feed 裡每一個有公布逐 token 價格的文字模型,涵蓋全部 15 家供應商,拿每個模型的輸出費率和它自己的輸入費率相比。資料時間是 2026 年 7 月 24 日。
中位數的模型,輸出價正好是輸入價的四倍。大約十個裡有一個,輸出和輸入同價,或輸出更便宜,這在推論主機上的 open-weight 模型很常見。另一端則是大約七個裡有一個超過六倍,這份 feed 裡最大的差距是十二倍。
這會直接影響你怎麼省錢。先縮短提示詞是大家最先想到的做法,但通常效果比較小。要求更短的答案、限制輸出長度,或選一個不會把思考過程寫很長的模型,對帳單的影響通常大於把問題刪掉一段。reasoning 模型要特別留意:它們產生的思考 token 按輸出計費,就算你根本看不到。
| 輸出價相對輸入價 | 有標價的文字模型佔比 |
|---|---|
| 一樣或更便宜(1 倍或更低) | 10% |
| 1 倍到 2 倍 | 11% |
| 2 倍到 4 倍 | 39% |
| 4 倍到 6 倍 | 25% |
| 超過 6 倍 | 15% |
帳單真正被什麼推高
人們第一次收到 API 帳單會訝異,通常是四個原因之一,沒有一個是模型那個標題價格。下面這些機制對每一家供應商都成立,因為它們來自聊天 API 怎麼運作,不是哪一家的政策。
最大的是上下文重送。API 呼叫是無狀態的:模型不記得你上一輪,所以用戶端每一則都得把整段對話再送一次。一條跑了四十輪的線索,在第四十一輪會把四十輪歷史當成輸入送出去。一段對話的費用因此大致隨長度的平方成長。這就是為什麼一條長線索可能比二十條涵蓋同樣內容的短線索更貴。
Prompt caching 是對沖的那一側,值得在你把它略過之前先懂。支援的供應商會把重複上下文按快取讀取計費,而不是按全新輸入。在我們量過的這份 feed 裡,大約五個模型有一個公布了快取讀取價;在有這個價格的模型上,快取費率的中位數是該模型自己輸入價的 10%。我們看到的最低不到 1%,最高大約 58%。有些供應商寫入快取也收費,通常比正常輸入貴一截。所以同一段上下文被重複用好幾次才划算,只用一次就不划算。
- 對話內容:每一輪都整段重送,所以長對話會貴得不成比例。
- System prompt 和預設:可重複使用的指示會加在每一則訊息前面,悄悄讓 token 數倍增。
- 附件:丟進聊天的文件或圖片會變成輸入 token,而且在這段對話後續的每一輪,都會留在上下文裡。
- Reasoning token:會產生這類 token 的模型按輸出計費,不管推理過程有沒有顯示都一樣。
- 重試和重新生成:重新生成的答案是第二次完整計費的請求,不是免費的。
15 家供應商的價格地圖
下面這張表是 Oriveo 接到的 15 家供應商,各自公示輸入價的範圍快照。只計算有公布逐 token 價格的文字模型,並列出該家最便宜和最貴的。它是一張每家坐在哪裡的地圖,不是推薦:同一家最便宜和最貴的模型,很少能互相替代。
來源和方法寫在這裡,方便你查:每個數字都來自 Oriveo 生產環境的 metadata feed,網址是 api.oriveoai.com/api/metadata,contract version 47,產生時間 2026-07-24T01:00:09Z。App 用來給訊息標價的是同一份,本站費用計算機背後也是它。價格是美元、每百萬 token,截至 2026 年 7 月 24 日。影像生成模型,以及供應商按次而不是按 token 計價的模型,都排除了,因為對它們報一個逐 token 數字沒有意義。
有兩件事很突出。第一是跨度:整份 feed 最便宜的輸入價是每百萬 token $0.01,最貴是 $150,截至 2026 年 7 月 24 日,同一個選擇器裡兩列相差一萬五千倍。第二是目錄有多寬和便不便宜是兩條軸:聚合器區間最寬,因為它們轉售很多家;單一供應商則緊緊聚在自己的分級附近。
這裡每個數字都當成會過期的。供應商會改價、推出更便宜的檔、不斷下架模型;下面有幾列在過去這一季裡變過。任何引用模型價格的文章都是一張照片。所以才有即時的 feed 和計算機,這頁也寫下擷取日期,而不是暗示數字永久有效。
| 供應商 | 有公示 token 價的文字模型數 | 最低輸入(USD / 1M) | 最高輸入(USD / 1M) |
|---|---|---|---|
| OpenAI | 49 | 0.05 | 150 |
| Anthropic (Claude) | 10 | 1.00 | 15 |
| Google Gemini | 21 | 0.075 | 2.00 |
| xAI Grok | 6 | 1.00 | 2.00 |
| DeepSeek | 4 | 0.14 | 0.435 |
| Mistral | 32 | 0.04 | 2.00 |
| Qwen | 49 | 0.035 | 2.80 |
| Kimi | 9 | 0.20 | 2.00 |
| MiniMax | 7 | 0.30 | 0.60 |
| Z.ai | 12 | 0.07 | 1.40 |
| Groq | 7 | 0.03 | 0.59 |
| Together AI | 69 | 0.02 | 3.50 |
| Fireworks AI | 15 | 0.07 | 2.80 |
| OpenRouter | 305 | 0.01 | 150 |
| SiliconFlow | 49 | 0.04 | 1.74 |
同一個模型為什麼不止一個價
打開兩份模型目錄,你會看到同一個模型掛著不同費率。那通常不是寫錯。open-weight 模型由好幾家推論主機提供,硬體、吞吐和利潤都不同,所以同一個模型在一家是這個價、在另一家是另一個價,可以是真的。上面那份 feed 裡,同一個 open-weight 家族在好幾家供應商上的費率確實不一樣。
第二個原因是你透過哪一層買。聚合器站在你和底下供應商之間,得用某種方式養這個位置:token 價格上的價差、儲值手續費、按請求抽成,或一套 credit 制度,credits 怎麼換成 token 由平台定義,不是由供應商價目表定義。這些沒有哪一個天生是壞的;要緊的是機制有沒有公開。以 OpenRouter 為例,條款是公開寫的:截至 2026 年 7 月 24 日,公示政策是銀行卡儲值收 5.5%、最低 $0.80;你自己帶的金鑰,每個月前一百萬次請求不收費,超過之後按該模型正常價格的 5% 以 credits 扣除。
比較平台時,值得問的不是一個 credit 多少錢,而是從供應商的定價到你被收的錢,公開的路徑是什麼。若平台用 credits 計價卻不公布這個換算,你在比的不是模型的價格,而是平台的定價政策。那個政策可以變,模型的價格完全沒變。
訂閱還是用多少付多少,哪個對你比較省
這才是多數人真正想問的問題,而它沒有通用的答案。固定月費的訂閱和按量計費的 API,會在某個用量上打平。打平的點取決於你的訊息有多長、答案有多長、你選哪個模型、對話進行多久。任何人在沒有你的數字時,就說能省下多少百分比,都只是猜測。
大約五分鐘就能算完,算法並不難。拿真正典型的一週,不要拿最忙的那一週。先數訊息則數,再把你拿到的答案平均長度用字數估出來,乘上大約 1.35 換算成 token。再加上輸入那一側,記得每一輪都會把到目前為止的對話重送。乘上模型公布的輸入和輸出費率,再和你考慮的月費比較。本站的費用計算機會用即時價格幫你算,所以你不用自己記費率。
有幾個規律夠穩定,不用編數字也能說。用量少或忽多忽少、偶爾才用好幾個模型而不是固定用同一個、而且多半是短問短答的人,按量計費通常比較有利。每天穩定地大量使用的人,訂閱通常比較有利,而且還有一個和錢無關的好處:帳單金額固定。最糟的是按量計費又看不到每一則花多少,等於兩邊的缺點加在一起。每一則訊息上的預估費用,就是為了避免這種情況。
真的想少花,要改的是習慣
一旦看懂這些計費項目,多數省下來的錢,都來自少數幾個習慣,而不是去追清單裡最便宜的那一家。以一般的聊天用量來看,大致依效果由大到小排列如下:
通常沒用的做法,是全部換成清單裡最便宜的模型。一個只要五分之一價錢、卻要試三次才答對的模型,並沒有比較省,時間也花掉了。有用的做法是讓模型配合任務:擷取資料、排版、摘要、翻譯用便宜的;貴的留給你原本會花錢請人做的工作。
- 新題目就新開一段對話。這是效果最大的一招,因為你不用再為重送一段無關的對話內容付錢。
- 想要短答案就直接要求簡短。大約十個模型裡有九個,輸出價比輸入價貴。
- 讓模型配合任務,不要每件事都預設用最強的那個。
- 把 system prompt 和可重複使用的預設寫精簡。每一則用到它們的訊息都會計費。
- 供應商有支援、而且你會反覆使用同一段很長的上下文時,再用 prompt caching。
- 附件用完就從這段對話移除,不要讓它跟著後面每一輪重送。
- 同一種做法要重複一百次之前,先看這一則的預估費用。
Oriveo 怎麼讓費用一目了然
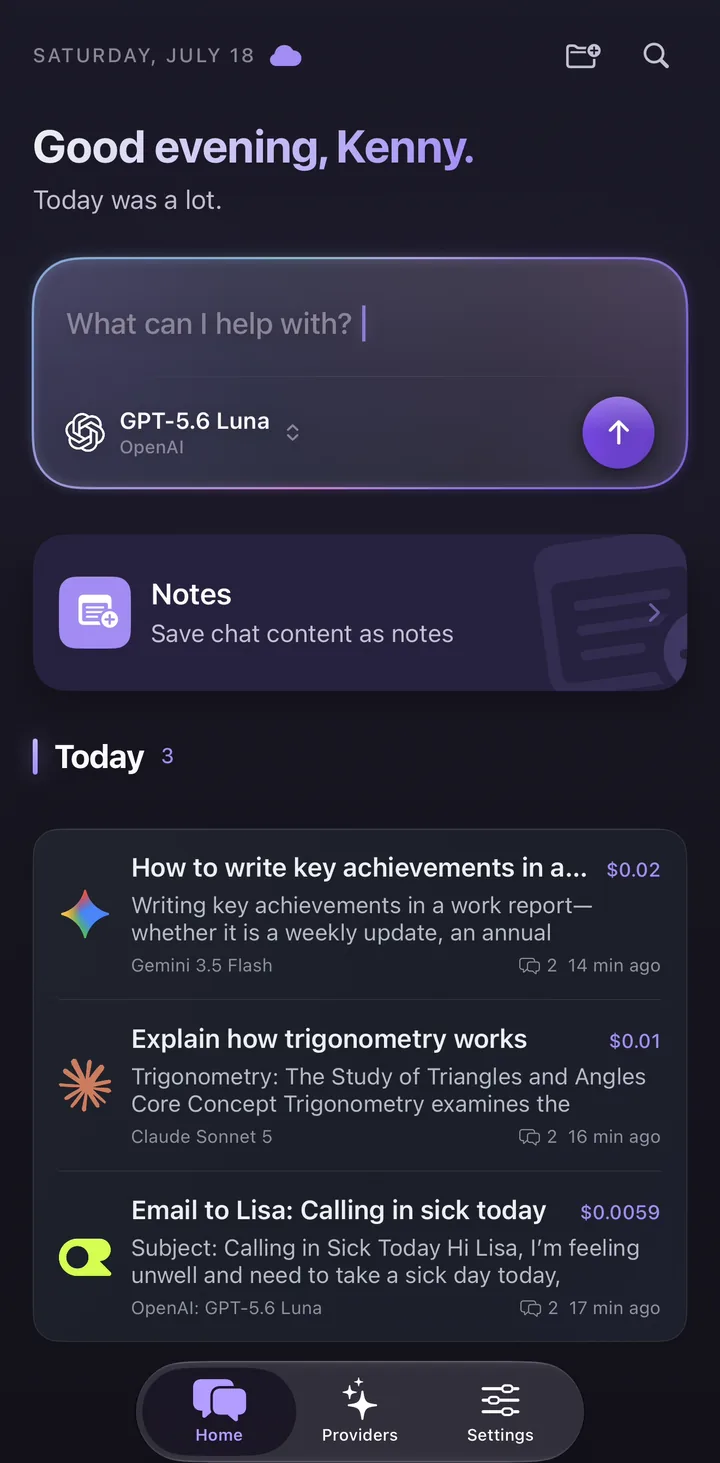
Oriveo 的每一則訊息都帶預估費用,在答案結束的那一刻,用供應商公示的 token 價格和實際上報的 token 算出來。這個估算每一層都有,包括不用登入的那層,因為只有付費方案才看得到的費用,幫不了你決定要不要為任何東西付錢。上面那些表用的同一份 metadata feed 就是這些價格的來源,所以 App 不需要你自己維護一份價目表。
它是估算,也標成估算。供應商會套自己的進位、最低計費單位、依帳戶而異的費率,以及偶爾的促銷價;token 數是供應商事後回報的。估算是用來在這個月裡調決定的;供應商的帳單才是最終依據。兩邊不合時,以帳單為準。
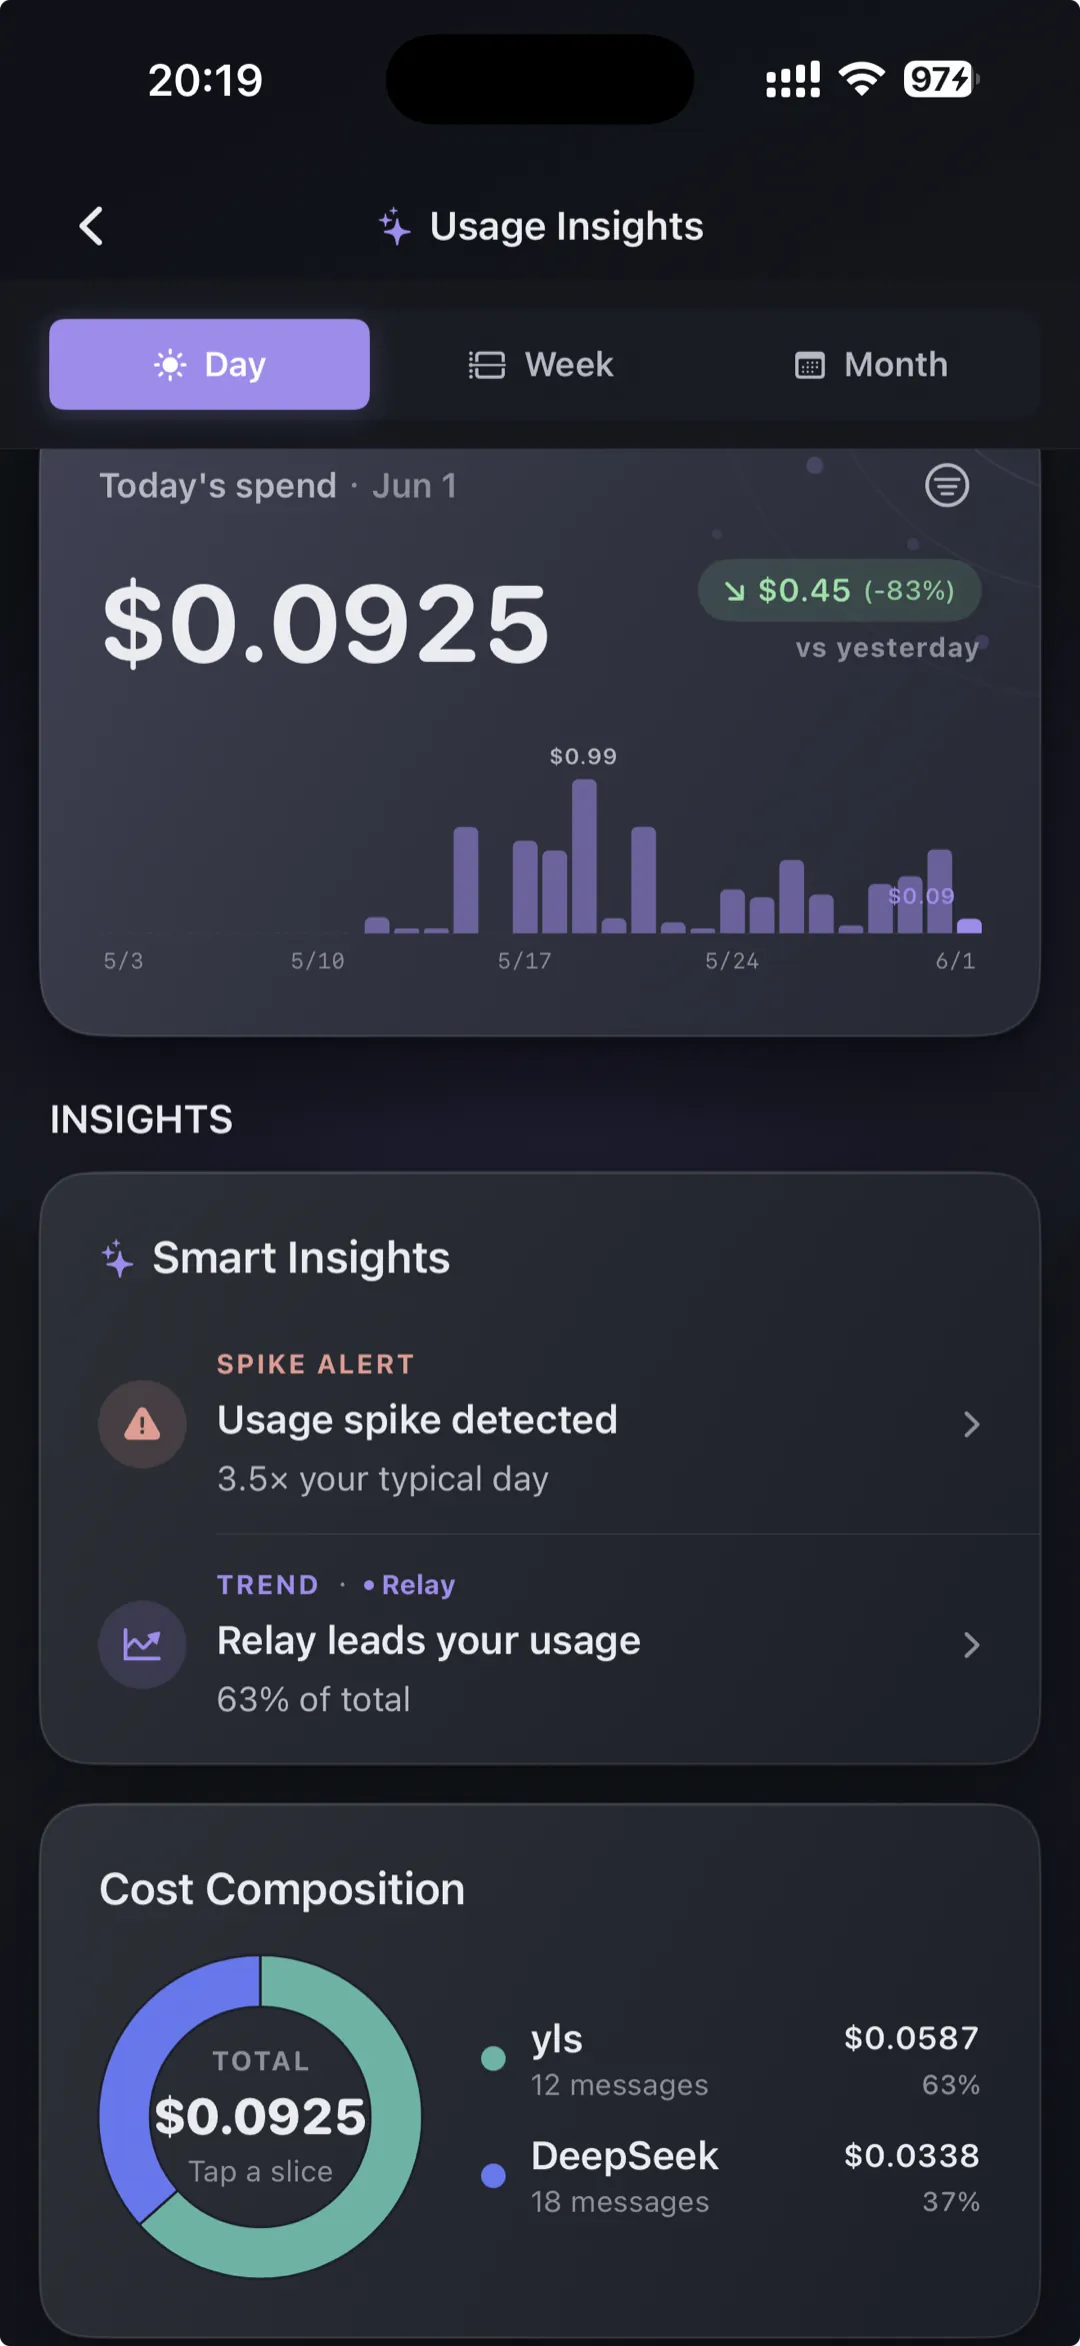
更深的分析在付費方案後面。Usage Insights,也就是按供應商和模型拆開的花費、月趨勢和預算提醒,屬於 Pro 和終身版。截至 2026 年 7 月 24 日,價格是月付 $9.99、年付 $59.99,或一次付清 $149.99。這些方案買的只是軟體功能:不含 AI 用量、不含模型 credits、不含供應商訂閱。所以 App 的價格和你的 token 價格,不會被捆成一個拆不開的數字。
這些數字決定不了的事
價格表只是起點,不是結論。有三件事它沒說,值得講清楚,因為它們常常會讓一個看起來已經由價格決定的比較整個翻盤。
第一是每個任務要花多少 token。兩個費率相同的模型,為了得到同一個答案,花掉的 token 可能差很多;一個話很多的便宜模型,做完一件事可能比一個話少的貴模型還貴。第二是重試率:要重新生成的答案會計費兩次。第三是 token 計費以外的一切:速率限制、延遲、context window、你所在的地區能不能用,以及模型讀不讀得了你工作上用的檔案格式。
這種比較比較適合用來初步篩選。先劃掉明顯超出預算的,再用你自己的實際工作試兩三個,看的是做完一件事要花多少,而不是一百萬 token 要花多少。逐則預估費用的存在,就是為了讓這個實驗一天就能完成,而不必等一整個帳單週期。