Custo de API de IA: como o preço de LLM funciona
Do que o preço de uma API de LLM é feito, o que empurra a fatura, e a faixa real de entrada e saída em 15 provedores, medida em 24 de julho de 2026.
- APIs de LLM cobram em até quatro medidores separados, e a maior parte das comparações de preço olha só um deles.
- Tokens de saída custam, na mediana, quatro vezes o que custam os tokens de entrada, e até doze vezes.
- Os preços de entrada publicados em 15 provedores vão de $0.01 a $150 por milhão de tokens, em 24 de julho de 2026.
Como o preço de uma API de LLM realmente funciona
Quase toda comparação de custo de API de IA cita um número por modelo, e esse número quase sempre é o preço de entrada. É o menos útil dos quatro números que um provedor publica. Um modelo cobra em medidores separados: os tokens que você envia, os tokens que ele escreve de volta, os tokens lidos de um cache e, em alguns provedores, os tokens gravados nesse cache. Cada medidor tem a própria tarifa, e as tarifas não ficam perto umas das outras.
Um token é mais ou menos três quartos de uma palavra em inglês, então um milhão de tokens fica em algum lugar perto de 750.000 palavras. Os preços são cotados por milhão de tokens porque mensagens individuais são tão baratas que um preço por mensagem seria só zeros. Esse enquadramento esconde a rapidez com que os medidores se somam numa conversa real, em que cada turno reenvia tudo o que foi dito antes.
A tabela abaixo mostra os quatro medidores para um punhado de modelos, tirados do mesmo feed de metadados que alimenta o seletor de modelos e a calculadora de custo deste site. Repare em como a coluna de entrada diz pouco: aqui os preços de entrada vão de 0,30 a 2,50 dólares, mas os de saída vão de 1,20 a 15,00 dólares, e a saída é o medidor que mais se move.
- Entrada — tudo o que você envia: a sua mensagem, a conversa até ali, qualquer prompt de sistema, qualquer texto anexado.
- Saída — tudo o que o modelo escreve de volta, inclusive tokens de raciocínio nos modelos que os produzem.
- Leitura de entrada em cache — contexto repetido que o provedor já viu, cobrado a uma tarifa bem mais baixa que a entrada nova.
- Gravação no cache — o que alguns provedores cobram para colocar esse contexto no cache pela primeira vez.
| Modelo | Entrada (USD / 1M tokens) | Saída (USD / 1M tokens) | Leitura de entrada em cache | Gravação no cache |
|---|---|---|---|---|
| Claude Haiku 4.5 | 1.00 | 5.00 | 0.10 | 1.25 |
| Claude Sonnet 5 | 2.00 | 10.00 | 0.20 | 2.50 |
| GPT-5.6 Luna | 1.00 | 6.00 | 0.10 | 1.25 |
| GPT-5.6 Terra | 2.50 | 15.00 | 0.25 | 3.125 |
| Kimi k2.5 | 0.60 | 3.00 | 0.10 | 0.60 |
| Qwen3.7 Plus | 0.50 | 3.00 | 0.05 | 0.625 |
| MiniMax-M2.5 | 0.30 | 1.20 | 0.03 | 0.375 |
Os tokens de saída são a metade cara
O padrão mais confiável no preço de LLM é que escrever custa mais do que ler. Para pôr um número nisso, e não uma impressão, pegamos cada modelo de texto no feed de metadados do Oriveo que publica um preço por token — nos 15 provedores — e comparamos a tarifa de saída de cada modelo com a própria tarifa de entrada, em 24 de julho de 2026.
O modelo mediano cobra exatamente quatro vezes mais pela saída do que pela entrada. Cerca de um modelo em cada dez cobra o mesmo pelos dois, ou menos pela saída, o que é típico de modelos de pesos abertos servidos por servidores de inferência. Na outra ponta, cerca de um em cada sete cobra mais de seis vezes, e a maior distância no feed é de doze vezes.
Isso muda direto a forma de gastar. Enxugar o prompt é a otimização que todo mundo tenta primeiro, e em geral é a alavanca menor. Pedir uma resposta mais curta, limitar o tamanho da saída ou escolher um modelo que não pense em voz alta por muito tempo move a fatura mais do que cortar um parágrafo da pergunta. Modelos de raciocínio merecem um segundo olhar aqui, porque os tokens de pensamento que eles geram são cobrados como saída mesmo quando você nunca os vê.
| Preço de saída comparado ao de entrada | Parcela dos modelos de texto com preço |
|---|---|
| Igual ou mais barato (1× ou menos) | 10% |
| 1× a 2× | 11% |
| 2× a 4× | 39% |
| 4× a 6× | 25% |
| Mais de 6× | 15% |
O que de fato empurra a sua fatura
As pessoas em geral se surpreendem com a primeira fatura de API por um de quatro motivos, e nenhum deles é o preço de manchete do modelo. A mecânica abaixo vale para todo provedor, porque decorre de como as APIs de chat funcionam, e não da política de um fornecedor.
O maior é o reenvio de contexto. Uma chamada de API não tem estado: o modelo não lembra o turno anterior, então o cliente precisa reenviar a conversa inteira a cada mensagem. Uma conversa que já passou de quarenta turnos envia quarenta turnos de histórico como entrada no turno quarenta e um. O custo de uma conversa, portanto, cresce mais ou menos com o quadrado do comprimento. Por isso uma conversa longa pode custar mais que vinte conversas curtas sobre o mesmo assunto.
O cache de prompt é o contrapeso, e vale entender antes de descartar. Provedores que o suportam deixam o contexto repetido ser cobrado como leitura em cache, em vez de entrada nova. No feed que medimos, cerca de um modelo em cada cinco publica um preço de leitura em cache, e, onde ele existe, a tarifa em cache fica numa mediana de 10% do próprio preço de entrada daquele modelo. O mais baixo que achamos fica abaixo de 1%, e o mais alto por volta de 58%. Alguns provedores também cobram para gravar o cache, em geral com um acréscimo sobre a entrada normal. O cache compensa quando o mesmo contexto é reutilizado várias vezes, e não quando é usado uma vez só.
- Histórico da conversa — reenviado por inteiro a cada turno, então conversas longas custam bem mais do que a proporção sugere.
- Prompts de sistema e presets — instruções reutilizáveis entram no começo de cada mensagem e multiplicam em silêncio a contagem de tokens.
- Anexos — um documento ou uma imagem colocados num chat viram tokens de entrada e ficam no contexto em cada turno seguinte daquele fio.
- Tokens de raciocínio — cobrados como saída nos modelos que os geram, esteja o raciocínio à mostra ou não.
- Novas tentativas e regenerações — uma resposta regenerada é um segundo pedido cobrado por inteiro, não uma correção de graça.
O panorama de preço em 15 provedores
A tabela abaixo é um retrato da faixa de preço de entrada publicada em cada um dos 15 provedores a que o Oriveo se conecta. Ela conta só modelos de texto que publicam um preço por token, e mostra o mais barato e o mais caro deles naquele provedor. É um mapa de onde cada provedor se senta, não uma recomendação: o modelo mais barato de um provedor e o mais caro raramente se substituem.
Fonte e método, para você conferir: cada número vem do feed de metadados de produção do Oriveo, em api.oriveoai.com/api/metadata, contract version 47, gerado em 2026-07-24T01:00:09Z. É o mesmo feed que o app usa para precificar mensagens e o mesmo por trás da calculadora de custo deste site. Os preços estão em dólares americanos por milhão de tokens, em 24 de julho de 2026. Modelos de geração de imagem, e modelos que o provedor cobra por pedido e não por token, ficam de fora, porque um número por token não significaria nada para eles.
Duas coisas saltam. A primeira é a abertura: o preço de entrada mais barato do feed inteiro é $0.01 por milhão de tokens, e o mais caro é $150, um fator de quinze mil entre duas linhas do mesmo seletor, em 24 de julho de 2026. A segunda é que catálogo largo e preço baixo são eixos diferentes. Os agregadores carregam a faixa mais aberta porque revendem muitos fornecedores, enquanto um provedor de um só fornecedor se agrupa apertado em torno da própria escada de preços.
Trate cada número daqui como perecível. Provedores reajustam, lançam níveis mais baratos e aposentam modelos o tempo todo. Várias das linhas abaixo mudaram no último trimestre. Qualquer artigo que cita preço de modelo é uma fotografia. Por isso existem o feed ao vivo e a calculadora, e por isso esta página declara a data da captura em vez de insinuar que os números são permanentes.
| Provedor | Modelos de texto com preço por token publicado | Menor entrada (USD / 1M) | Maior entrada (USD / 1M) |
|---|---|---|---|
| OpenAI | 49 | 0.05 | 150 |
| Anthropic (Claude) | 10 | 1.00 | 15 |
| Google Gemini | 21 | 0.075 | 2.00 |
| xAI Grok | 6 | 1.00 | 2.00 |
| DeepSeek | 4 | 0.14 | 0.435 |
| Mistral | 32 | 0.04 | 2.00 |
| Qwen | 49 | 0.035 | 2.80 |
| Kimi | 9 | 0.20 | 2.00 |
| MiniMax | 7 | 0.30 | 0.60 |
| Z.ai | 12 | 0.07 | 1.40 |
| Groq | 7 | 0.03 | 0.59 |
| Together AI | 69 | 0.02 | 3.50 |
| Fireworks AI | 15 | 0.07 | 2.80 |
| OpenRouter | 305 | 0.01 | 150 |
| SiliconFlow | 49 | 0.04 | 1.74 |
Por que o mesmo modelo tem mais de um preço
Abra dois diretórios de modelos e você encontra o mesmo modelo com tarifas diferentes. Isso em geral não é um erro. Modelos de pesos abertos são servidos por vários servidores de inferência, cada um com o próprio hardware, a própria vazão e a própria margem, então um modelo pode legitimamente custar uma coisa num lugar e outra noutro. No feed acima, a mesma família de pesos abertos aparece em vários provedores, com tarifas de fato diferentes.
O segundo motivo é a camada pela qual você compra. Agregadores ficam entre você e o provedor de baixo e precisam pagar essa posição de algum jeito: uma margem no preço do token, uma taxa de recarga, um percentual sobre os pedidos, ou um sistema de créditos cuja conversão para tokens é definida pela plataforma, e não pela tabela do provedor. Nenhum desses caminhos é ruim por natureza. O que importa é o mecanismo estar publicado. O OpenRouter, por exemplo, documenta os termos às claras: em 24 de julho de 2026, a política publicada é uma taxa de 5.5% nas recargas de cartão, com mínimo de $0.80, e, para as chaves que você mesmo traz, o primeiro milhão de pedidos de cada mês sem cobrança, com 5% do preço normal do modelo descontado em créditos a partir daí.
Na hora de comparar plataformas, a pergunta que vale não é “quanto custa um crédito”, e sim “qual é o caminho publicado entre o preço de tabela do provedor e o que me cobram”. Se uma plataforma cobra em créditos e não publica essa conversão, a comparação que você faz não é com o preço do modelo. É com a política de preço da plataforma, e essa política pode mudar sem que o preço do modelo mude nada.
Assinatura ou pagamento por uso: o que fica mais barato para você
Esta é a pergunta com que a maioria de fato chega, e ela não tem resposta geral. Uma assinatura mensal fixa e o acesso medido por API se cruzam em algum volume de uso, e esse ponto depende das suas mensagens: o tamanho delas, o tamanho das respostas, qual modelo você escolhe e quanto duram as conversas. Quem cita uma porcentagem de economia sem os seus números está chutando.
Dá para fazer a conta em cerca de cinco minutos, e a aritmética não é difícil. Pegue uma semana típica de verdade, não a mais cheia. Conte as mensagens. Estime o tamanho médio das respostas em palavras e multiplique por cerca de 1.35 para chegar aos tokens. Some o lado da entrada, lembrando que cada turno reenvia a conversa até ali. Multiplique pelas tarifas publicadas de entrada e de saída do modelo e compare com a mensalidade que você está olhando. A calculadora de custo deste site faz isso contra os preços ao vivo, para você não ter de guardar as tarifas.
Alguns padrões de estrutura são estáveis o bastante para afirmar sem inventar números. O acesso medido tende a ganhar quando o uso é leve ou em picos, quando você usa vários modelos de vez em quando em vez de um com força, e quando boa parte do trabalho são perguntas curtas com respostas curtas. Assinaturas tendem a ganhar num volume diário alto e constante, e têm uma vantagem real que não é dinheiro: uma fatura previsível. Acesso medido sem ver o custo de cada mensagem é o pior dos dois mundos, e é exatamente a falha que uma estimativa de custo em cada mensagem existe para evitar.
Como reduzir de verdade o que você gasta
Quando dá para ver os medidores, a maior parte da economia vem de poucos hábitos, não de caçar o provedor mais barato. Na ordem aproximada de quanto mexem no número, para uma carga típica de chat:
O que em geral não funciona é passar tudo para o modelo mais barato do catálogo. Um modelo que precisa de três tentativas para acertar a resposta, a um quinto do preço, não é economia, e ainda leva o seu tempo. A versão útil do conselho é casar o modelo com a tarefa: modelos baratos para extração, formatação, resumo e tradução; os caros para o trabalho pelo qual você teria pagado uma pessoa.
- Comece uma conversa nova para um tema novo. Esta é a maior alavanca, porque você para de pagar o reenvio de um histórico que não serve.
- Peça respostas mais curtas quando quiser uma resposta mais curta. A saída é o medidor mais caro em cerca de nove modelos em cada dez.
- Case o modelo com a tarefa, em vez de deixar o mais forte como padrão para tudo.
- Mantenha prompts de sistema e presets reutilizáveis enxutos. Eles são cobrados em toda mensagem que os usa.
- Use cache de prompt onde o provedor suporta, e quando você reutiliza o mesmo contexto longo várias vezes.
- Tire os anexos da conversa quando terminar com eles, em vez de carregá-los em cada turno seguinte.
- Olhe a estimativa de uma mensagem antes de repetir esse padrão cem vezes.
Como o Oriveo mostra o custo
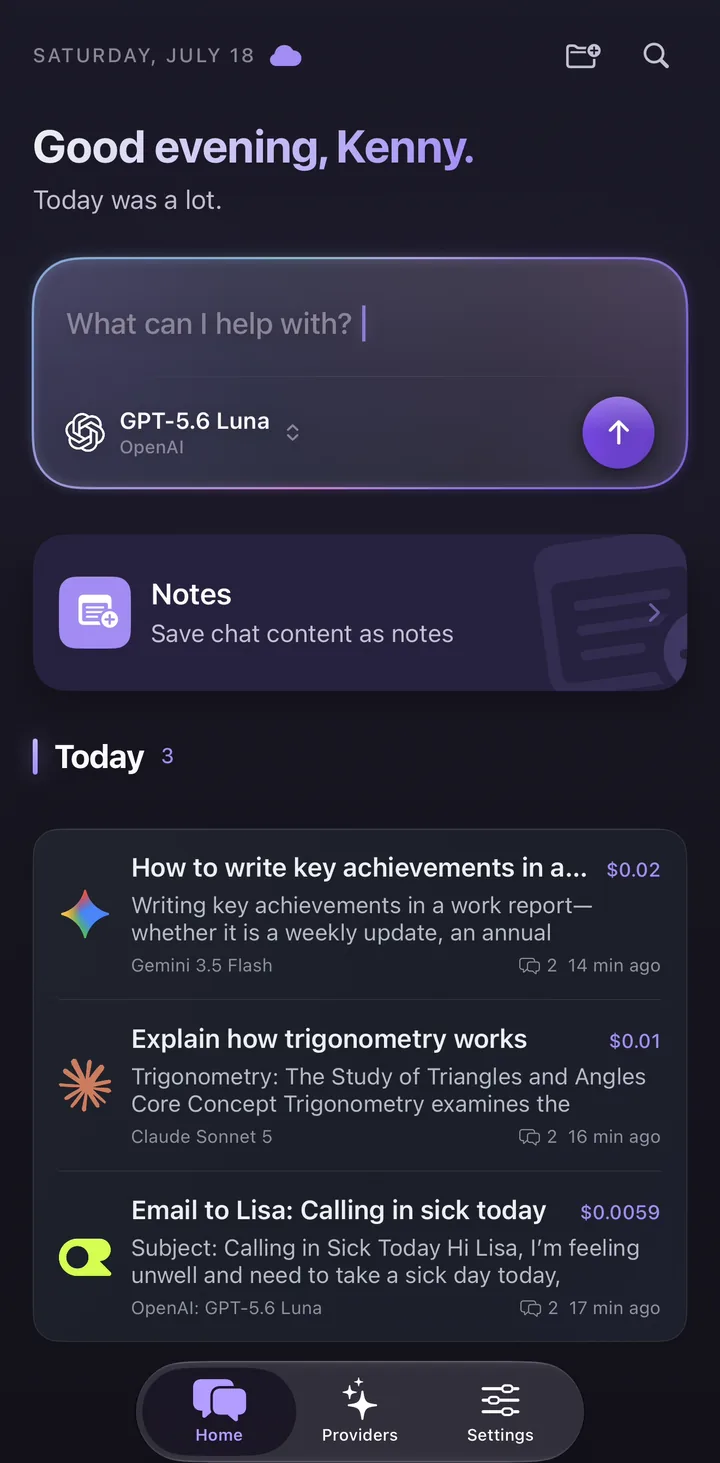
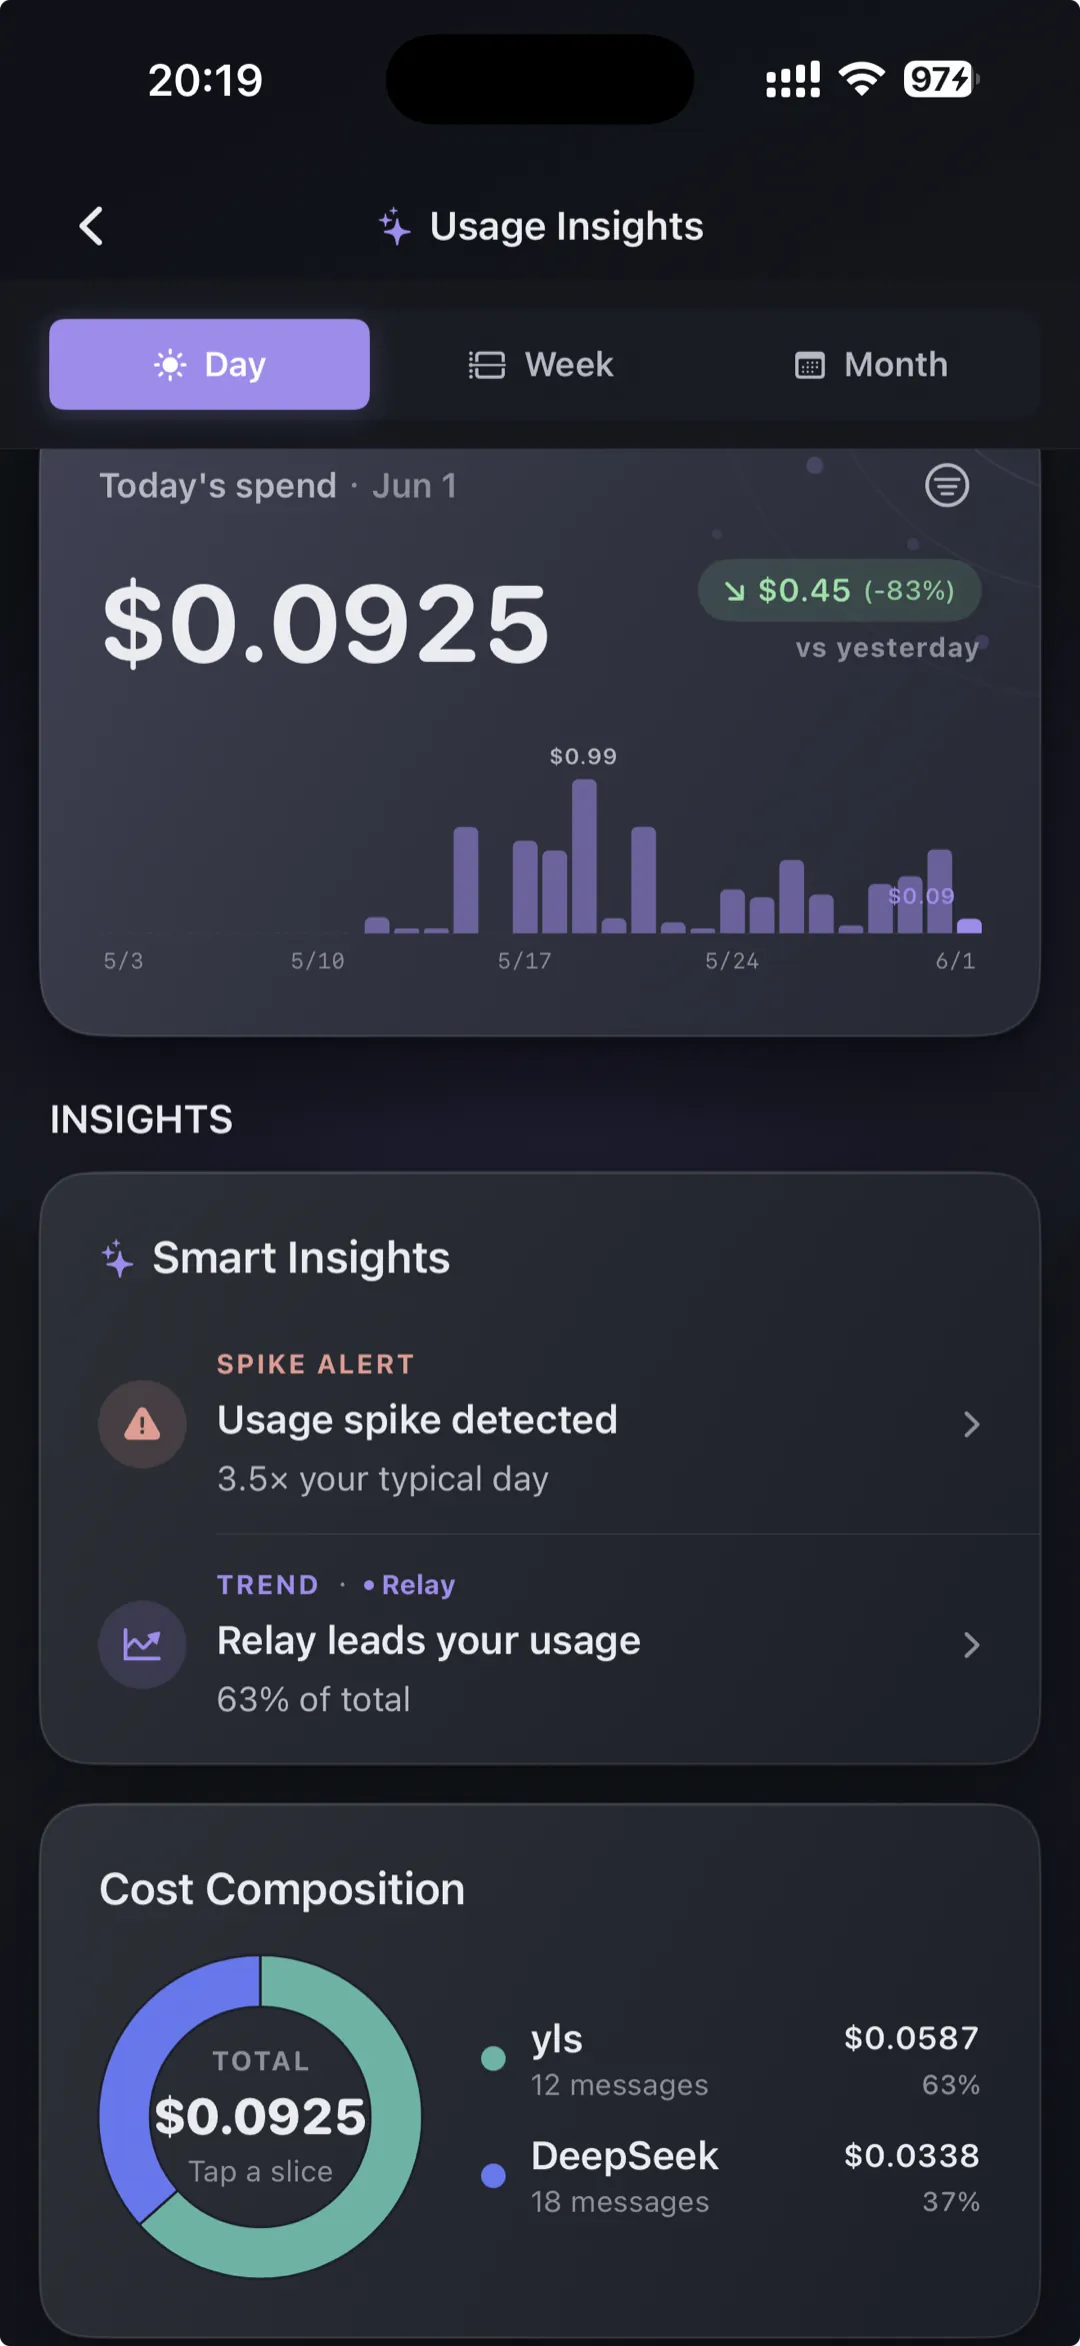
Cada mensagem no Oriveo carrega um custo estimado, calculado a partir do preço por token publicado pelo provedor e dos tokens de fato reportados, no instante em que a resposta termina. Essa estimativa existe em todas as camadas, inclusive na sem login, porque um custo que só aparece num plano pago não ajuda a decidir se vale pagar por alguma coisa. O mesmo feed de metadados das tabelas acima é o que fornece esses preços. Por isso o app não precisa que você mantenha uma tabela.
É uma estimativa, e está rotulada como tal. Os provedores aplicam o próprio arredondamento, unidades mínimas cobráveis, tarifas por conta e, de vez em quando, um preço promocional. As contagens de tokens são reportadas pelo provedor depois do fato. A estimativa serve para orientar decisões ao longo do mês. A fatura do seu provedor é a palavra final, e, quando as duas discordam, a fatura é que está certa.
A análise mais funda fica nos planos pagos. O Usage Insights — gasto separado por provedor e por modelo, tendências mensais e alertas de orçamento — faz parte de Pro e Lifetime, que custam $9.99 por mês, $59.99 por ano ou $149.99 uma vez, em 24 de julho de 2026. Esses planos compram só recurso de software: não incluem uso de IA, nem créditos de modelo, nem assinatura de provedor. O preço do app e o preço dos seus tokens nunca se juntam num número que você não consegue abrir.
O que estes números não conseguem te dizer
Uma tabela de preço é um começo, não uma decisão. Três coisas que ela deixa de fora merecem ser ditas com clareza, porque com frequência invertem uma comparação que parecia fechada só no preço.
A primeira é tokens por tarefa. Dois modelos na mesma tarifa podem gastar quantidades bem diferentes de tokens até chegar à mesma resposta, e um modelo barato e verboso pode custar mais por trabalho terminado do que um caro e seco. A segunda é a taxa de nova tentativa: uma resposta que você precisa regenerar é cobrada duas vezes. A terceira é tudo o que fica fora do medidor de tokens: limites de ritmo, latência, janela de contexto, disponibilidade na sua região e se o modelo lê os formatos de arquivo com que você trabalha.
O jeito honesto de usar uma comparação como esta é tratá-la como filtro de lista curta. Tire as linhas que estão claramente fora do orçamento, teste dois ou três candidatos no seu trabalho real e olhe quanto custa uma tarefa terminada, não quanto custa um milhão de tokens. A estimativa por mensagem existe justamente para que essa experiência leve um dia, e não um ciclo de fatura.
Perguntas frequentes
Quanto custa, de verdade, uma mensagem para uma API de LLM?
Por que a saída é mais cara que a entrada?
O cache de prompt realmente reduz a fatura?
Uma API com pagamento por uso sai mais barata que uma assinatura mensal de IA?
Por que o mesmo modelo custa valores diferentes em plataformas diferentes?
Quão atuais são os preços deste artigo?
O Oriveo acrescenta sobretaxa ao que os provedores cobram?
Leituras relacionadas
Veja o custo de cada mensagem ao enviar
O Oriveo mostra um custo estimado em cada mensagem, pelo preço de tabela do provedor, em 15 provedores oficiais e 700+ modelos, no iPhone, no Android e na web, sem sobretaxa no uso do provedor.