KI-API-Kosten im Vergleich: Wie LLM-Preise funktionieren
Woraus LLM-API-Preise wirklich bestehen, was deine Rechnung treibt, und die echte Spanne der Input- und Output-Preise über 15 Anbieter, Stand 24. Juli 2026.
- LLM-APIs rechnen über bis zu vier getrennte Zähler ab, und die meisten Preisvergleiche sehen sich nur einen davon an.
- Output-Tokens kosten im Median das Vierfache der Input-Tokens, und bis zum Zwölffachen.
- Veröffentlichte Input-Preise über 15 Anbieter reichen Stand 24. Juli 2026 von $0.01 bis $150 pro Million Tokens.
Wie Preise von LLM-APIs wirklich funktionieren
Fast jeder Vergleich von KI-API-Kosten nennt eine Zahl pro Modell, und diese Zahl ist fast immer der Input-Preis. Er ist die am wenigsten nützliche der vier Zahlen, die ein Anbieter veröffentlicht. Ein Modell rechnet über getrennte Zähler ab: Tokens, die du hineinschickst, Tokens, die es zurückschreibt, Tokens, die aus einem Cache gelesen werden, und – bei manchen Anbietern – Tokens, die in diesen Cache geschrieben werden. Jeder Zähler hat seinen eigenen Satz, und die Sätze liegen nicht nah beieinander.
Ein Token ist ungefähr drei Viertel eines englischen Wortes, eine Million Tokens liegt also irgendwo bei 750.000 Wörtern. Preise werden pro Million Tokens genannt, weil einzelne Nachrichten so billig sind, dass ein Preis pro Nachricht nur aus Nullen bestünde. Diese Darstellung verdeckt, wie schnell sich die Zähler in einer echten Unterhaltung addieren, in der jede Runde alles noch einmal schickt, was vorher gesagt wurde.
Die Tabelle unten zeigt alle vier Zähler für eine Handvoll Modelle, aus demselben Metadata-Feed, der die Modellauswahl und den Kostenrechner auf dieser Seite speist. Achte darauf, wie wenig die Input-Spalte dir sagt: Hier liegen die Input-Preise zwischen 0,30 und 2,50 US-Dollar, die Output-Preise aber zwischen 1,20 und 15,00 US-Dollar – und der Output ist der Zähler, der sich am meisten bewegt.
- Input – alles, was du schickst: deine Nachricht, die Unterhaltung bisher, jeder System-Prompt, jeder angehängte Text.
- Output – alles, was das Modell zurückschreibt, einschließlich Reasoning-Tokens bei Modellen, die sie erzeugen.
- Cache-Lesen beim Input – wiederholter Kontext, den der Anbieter schon gesehen hat, abgerechnet zu einem viel niedrigeren Satz als frischer Input.
- Cache-Schreiben – was manche Anbieter dafür berechnen, diesen Kontext überhaupt erst in den Cache zu legen.
| Modell | Input (USD / 1M Tokens) | Output (USD / 1M Tokens) | Cache-Lesen, Input | Cache-Schreiben |
|---|---|---|---|---|
| Claude Haiku 4.5 | 1.00 | 5.00 | 0.10 | 1.25 |
| Claude Sonnet 5 | 2.00 | 10.00 | 0.20 | 2.50 |
| GPT-5.6 Luna | 1.00 | 6.00 | 0.10 | 1.25 |
| GPT-5.6 Terra | 2.50 | 15.00 | 0.25 | 3.125 |
| Kimi k2.5 | 0.60 | 3.00 | 0.10 | 0.60 |
| Qwen3.7 Plus | 0.50 | 3.00 | 0.05 | 0.625 |
| MiniMax-M2.5 | 0.30 | 1.20 | 0.03 | 0.375 |
Output-Tokens sind die teure Hälfte
Das verlässlichste Muster bei LLM-Preisen ist, dass Schreiben mehr kostet als Lesen. Um das in eine Zahl statt in einen Eindruck zu fassen, haben wir jedes Textmodell im Metadata-Feed von Oriveo genommen, das einen Preis pro Token veröffentlicht – über alle 15 Anbieter – und den Output-Satz jedes Modells mit seinem eigenen Input-Satz verglichen, Stand 24. Juli 2026.
Das Median-Modell berechnet für Output genau das Vierfache des Inputs. Etwa jedes zehnte Modell berechnet für beides dasselbe oder für Output weniger, typisch für Open-Weight-Modelle, die von Hosting-Anbietern betrieben werden. Am anderen Ende berechnet rund jedes siebte mehr als das Sechsfache, und die weiteste Lücke im Feed liegt beim Zwölffachen.
Das hat direkte Auswirkungen auf deine Ausgaben. Den Prompt zu kürzen ist die Optimierung, nach der fast alle zuerst greifen, und meist ist sie der kleinere Hebel. Eine kürzere Antwort zu verlangen, die Output-Länge zu deckeln oder ein Modell zu wählen, das nicht lange laut denkt, senkt die Rechnung stärker, als der Frage einen Absatz abzuschneiden. Reasoning-Modelle verdienen hier einen zweiten Blick, denn die Thinking-Tokens, die sie erzeugen, werden als Output berechnet, auch wenn du sie nie siehst.
| Output-Preis im Vergleich zum Input-Preis | Anteil der bepreisten Textmodelle |
|---|---|
| Gleich oder günstiger (1× oder weniger) | 10% |
| 1× bis 2× | 11% |
| 2× bis 4× | 39% |
| 4× bis 6× | 25% |
| Mehr als 6× | 15% |
Was deine Rechnung tatsächlich treibt
Die erste API-Rechnung überrascht meist aus einem von vier Gründen, und keiner davon ist der Listenpreis des Modells in der Überschrift. Die Mechanik unten gilt bei jedem Anbieter, weil sie aus der Funktionsweise von Chat-APIs folgt und nicht aus der Richtlinie irgendeines Anbieters.
Der größte Punkt ist, dass der Kontext erneut geschickt wird. Ein API-Aufruf ist zustandslos: Das Modell hat keine Erinnerung an deine vorige Nachricht, also muss der Client bei jeder Nachricht die ganze Unterhaltung erneut schicken. Ein Thread, der vierzig Runden gelaufen ist, schickt in Runde einundvierzig vierzig Runden Verlauf als Input. Die Kosten einer Unterhaltung wachsen deshalb ungefähr mit dem Quadrat ihrer Länge. Deshalb kann ein langer Thread mehr kosten als zwanzig kurze, in denen es um dasselbe geht.
Prompt-Caching ist das Gegengewicht, und es lohnt sich, es zu verstehen, bevor du es abtust. Anbieter, die es unterstützen, lassen wiederholten Kontext als Cache-Lesen abrechnen statt als frischen Input. Im Feed, den wir gemessen haben, veröffentlicht etwa jedes fünfte Modell einen Preis fürs Cache-Lesen, und wo es ihn gibt, liegt der Cache-Satz im Median bei 10 % des eigenen Input-Preises dieses Modells. Der niedrigste, den wir gefunden haben, liegt unter 1 %, der höchste um 58 %. Manche Anbieter berechnen auch das Schreiben des Caches, typischerweise mit einem Aufschlag auf normalen Input. Caching lohnt sich also, wenn derselbe Kontext mehrmals wiederverwendet wird, und nicht, wenn er einmal genutzt wird.
- Gesprächsverlauf – in jeder Runde vollständig erneut geschickt, deshalb kosten lange Threads überproportional mehr.
- System-Prompts und Presets – wiederverwendbare Anweisungen werden jeder einzelnen Nachricht vorangestellt und vervielfachen ihre Token-Zahl unbemerkt.
- Anhänge – ein Dokument oder Bild, das in einen Chat fällt, wird zu Input-Tokens und bleibt für jede spätere Runde in diesem Thread im Kontext.
- Reasoning-Tokens – als Output berechnet bei Modellen, die sie erzeugen, ob das Reasoning angezeigt wird oder nicht.
- Wiederholungen und Neugenerierungen – eine neu erzeugte Antwort ist eine zweite voll berechnete Anfrage, keine kostenlose Korrektur.
Die Preisspanne über 15 Anbieter
Die Tabelle unten ist eine Momentaufnahme der veröffentlichten Input-Preisspanne bei jedem der 15 Anbieter, mit denen sich Oriveo verbindet. Gezählt werden nur Textmodelle mit einem veröffentlichten Preis pro Token, gezeigt werden das günstigste und das teuerste davon bei diesem Anbieter. Die Tabelle zeigt, wo jeder Anbieter sitzt, und ist keine Empfehlung: Das günstigste Modell eines Anbieters und das teuerste sind selten Ersatz füreinander.
Quelle und Methode, damit du es prüfen kannst: Jede Zahl kommt aus dem Produktions-Metadata-Feed von Oriveo unter api.oriveoai.com/api/metadata, Contract-Version 47, erzeugt 2026-07-24T01:00:09Z – derselbe Feed, mit dem die App Nachrichten bepreist, und derselbe hinter dem Kostenrechner auf dieser Seite. Preise sind in US-Dollar pro Million Tokens, Stand 24. Juli 2026. Modelle zur Bilderzeugung und Modelle, die der Anbieter pro Anfrage statt pro Token bepreist, sind ausgeschlossen, weil eine Zahl pro Token für sie bedeutungslos wäre.
Zwei Dinge fallen auf. Das erste ist die Spanne: Der günstigste Input-Preis im ganzen Feed ist $0.01 pro Million Tokens und der teuerste ist $150, ein Faktor von fünfzehntausend zwischen zwei Zeilen in derselben Auswahl, Stand 24. Juli 2026. Das zweite ist, dass ein breiter Katalog und ein niedriger Preis auf verschiedenen Achsen liegen. Die Aggregatoren tragen die weiteste Spanne, weil sie viele Anbieter weiterverkaufen, während ein Anbieter mit nur eigenen Modellen eng an der eigenen Preisstaffel sitzt.
Behandle jede Zahl hier als verderblich. Anbieter setzen Preise neu, starten günstigere Stufen und nehmen Modelle laufend vom Markt. Mehrere der Zeilen unten haben sich innerhalb des letzten Quartals geändert. Jeder Artikel, der Modellpreise zitiert, ist ein Foto. Deshalb gibt es den Live-Feed und den Rechner, und deshalb nennt diese Seite ihr Aufnahmedatum, statt die Zahlen als dauerhaft hinzustellen.
| Anbieter | Textmodelle mit veröffentlichtem Token-Preis | Niedrigster Input (USD / 1M) | Höchster Input (USD / 1M) |
|---|---|---|---|
| OpenAI | 49 | 0.05 | 150 |
| Anthropic (Claude) | 10 | 1.00 | 15 |
| Google Gemini | 21 | 0.075 | 2.00 |
| xAI Grok | 6 | 1.00 | 2.00 |
| DeepSeek | 4 | 0.14 | 0.435 |
| Mistral | 32 | 0.04 | 2.00 |
| Qwen | 49 | 0.035 | 2.80 |
| Kimi | 9 | 0.20 | 2.00 |
| MiniMax | 7 | 0.30 | 0.60 |
| Z.ai | 12 | 0.07 | 1.40 |
| Groq | 7 | 0.03 | 0.59 |
| Together AI | 69 | 0.02 | 3.50 |
| Fireworks AI | 15 | 0.07 | 2.80 |
| OpenRouter | 305 | 0.01 | 150 |
| SiliconFlow | 49 | 0.04 | 1.74 |
Warum dasselbe Modell mehr als einen Preis hat
Öffne zwei Modellverzeichnisse, und du findest dasselbe Modell zu verschiedenen Sätzen. Das ist meist kein Fehler. Open-Weight-Modelle werden von mehreren Hosting-Anbietern betrieben, jeder mit eigener Hardware, eigenem Durchsatz und eigener Marge. Ein Modell kann auf einem Host legitim das eine kosten und auf einem anderen etwas anderes. Im Feed oben erscheint dieselbe Open-Weight-Familie bei mehreren Anbietern zu tatsächlich verschiedenen Sätzen.
Der zweite Grund ist die Zwischenschicht, über die du kaufst. Aggregatoren sitzen zwischen dir und dem darunterliegenden Anbieter und müssen diese Position irgendwie finanzieren: über eine Spanne auf Token-Preisen, eine Aufladegebühr, einen Prozentsatz auf Anfragen, oder ein Credit-System, dessen Umrechnung in Tokens die Plattform festlegt und nicht die Preisliste des Anbieters. Nichts davon ist an sich schlecht. Es kommt darauf an, ob der Mechanismus veröffentlicht ist. OpenRouter zum Beispiel dokumentiert die Bedingungen offen: Stand 24. Juli 2026 ist die veröffentlichte Regel eine Gebühr von 5,5 % auf Karten-Aufladungen mit einem Minimum von $0.80, und für Keys, die du selbst mitbringst, die erste Million Anfragen im Monat ohne Berechnung, darüber hinaus 5 % des normalen Modellpreises, abgezogen in Credits.
Wenn du Plattformen vergleichst, lautet die Frage, die sich lohnt, nicht „was kostet ein Credit“, sondern „welcher veröffentlichte Weg führt vom Listenpreis eines Anbieters zu dem, was mir berechnet wird“. Wenn eine Plattform in Credits bepreist und diese Umrechnung nicht veröffentlicht, vergleichst du nicht mit dem Preis des Modells. Du vergleichst mit der Preispolitik der Plattform, und diese Politik kann sich ändern, ohne dass sich der Preis des Modells überhaupt ändert.
Abo oder nutzungsbasiert: was für dich günstiger ist
Mit dieser Frage kommen die meisten eigentlich an, und eine allgemeine Antwort hat sie nicht. Ein pauschales Monatsabo und eine gemessene API kreuzen sich bei irgendeinem Nutzungsvolumen, und dieser Kreuzungspunkt hängt von deinen eigenen Nachrichten ab: wie lang sie sind, wie lang die Antworten sind, welches Modell du wählst und wie lang deine Threads laufen. Wer einen Prozentsatz an Ersparnis nennt, ohne deine Zahlen zu haben, rät.
Du kannst es in etwa fünf Minuten ausrechnen, und die Arithmetik ist nicht schwer. Nimm eine wirklich typische Woche, nicht deine stressigste. Zähl die Nachrichten. Schätz die durchschnittliche Länge der Antworten, die du bekommst, in Wörtern, und multipliziere mit ungefähr 1,35, um auf Tokens zu kommen. Rechne die Input-Seite dazu und denk daran, dass jede Runde den bisherigen Thread erneut schickt. Multipliziere mit den veröffentlichten Input- und Output-Sätzen des Modells und vergleich das mit der Monatsgebühr, die du erwägst. Der Kostenrechner auf dieser Seite tut das gegen Live-Preise, damit du die Sätze nicht selbst pflegen musst.
Ein paar strukturelle Muster sind stabil genug, um sie zu nennen, ohne Zahlen zu erfinden. Gemessener Zugang gewinnt meist, wenn die Nutzung leicht oder stoßweise ist, wenn du mehrere Modelle gelegentlich nutzt statt eines intensiv, und wenn viel deiner Arbeit kurze Fragen mit kurzen Antworten sind. Abos gewinnen meist bei gleichmäßig hohem Tagesvolumen, und sie haben einen echten Vorteil, der kein Geld ist: eine vorhersehbare Rechnung. Gemessener Zugang ohne Sicht auf die Kosten pro Nachricht ist das Schlechteste aus beiden, und genau dieses Scheitern soll eine Kostenschätzung an jeder Nachricht verhindern.
Wie du die Ausgabe wirklich senkst
Sobald du die Zähler siehst, kommt der größte Teil der Ersparnis aus einer kleinen Zahl von Gewohnheiten und nicht daher, den günstigsten Anbieter zu jagen. In grober Reihenfolge, wie stark sie die Zahl bewegen, für eine typische Chat-Last:
Was meist nicht funktioniert, ist, alles auf das günstigste Modell im Katalog umzustellen. Ein Modell zum Fünftel des Preises, das drei Versuche braucht, bis die Antwort stimmt, spart nichts, und es kostet dich obendrein die Zeit. Die brauchbare Form dieses Rats ist, das Modell zur Aufgabe zu passen: günstige Modelle für Extraktion, Formatierung, Zusammenfassen und Übersetzen, teure für die Arbeit, für die du sonst einen Menschen bezahlt hättest.
- Fang für ein neues Thema eine neue Unterhaltung an. Das ist der einzelne größte Hebel, weil du aufhörst, dafür zu zahlen, einen irrelevanten Verlauf erneut zu schicken.
- Bitte um kürzere Antworten, wenn du eine kürzere Antwort willst. Output ist der teurere Zähler bei etwa neun von zehn Modellen.
- Pass das Modell zur Aufgabe, statt für alles auf das stärkste zu setzen.
- Halt System-Prompts und wiederverwendbare Presets knapp, denn sie werden bei jeder Nachricht berechnet, die sie nutzt.
- Nutze Prompt-Caching, wo der Anbieter es unterstützt und du denselben langen Kontext wiederholt verwendest.
- Nimm Anhänge aus einem Thread, sobald du mit ihnen fertig bist, statt sie durch jede spätere Runde mitzuschleppen.
- Schau auf die Schätzung an einer Nachricht, bevor du dieses Muster hundertmal wiederholst.
Wie Oriveo dir die Kosten zeigt
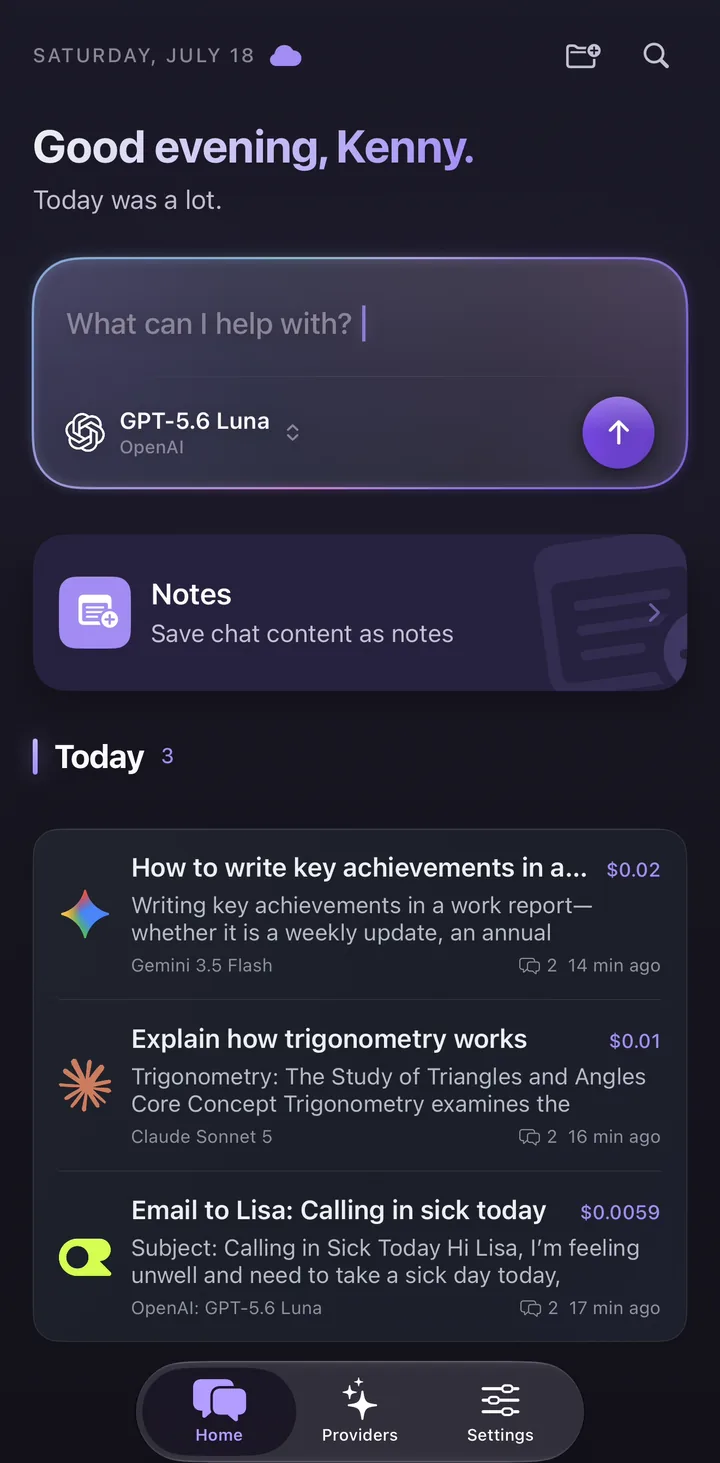
Jede Nachricht in Oriveo trägt geschätzte Kosten, berechnet aus dem veröffentlichten Token-Preis des Anbieters und den tatsächlich gemeldeten Tokens, in dem Moment, in dem die Antwort fertig ist. Diese Schätzung gibt es in jeder Stufe, auch in der ohne Anmeldung, denn Kosten, die du nur in einem bezahlten Plan siehst, helfen dir nicht zu entscheiden, ob du für irgendetwas zahlen sollst. Derselbe Metadata-Feed, der in den Tabellen oben steckt, liefert diese Preise. Deshalb musst du in der App keine Preisliste pflegen.
Es ist eine Schätzung und wird auch als solche gekennzeichnet. Anbieter wenden eigene Rundung an, kleinste abrechenbare Einheiten, Sätze je Konto und gelegentliche Aktionspreise, und Token-Zahlen meldet der Anbieter nachträglich. Die Schätzung soll Entscheidungen während des Monats steuern. Die Rechnung deines Anbieters hat das letzte Wort, und wenn die zwei voneinander abweichen, hat die Rechnung recht.
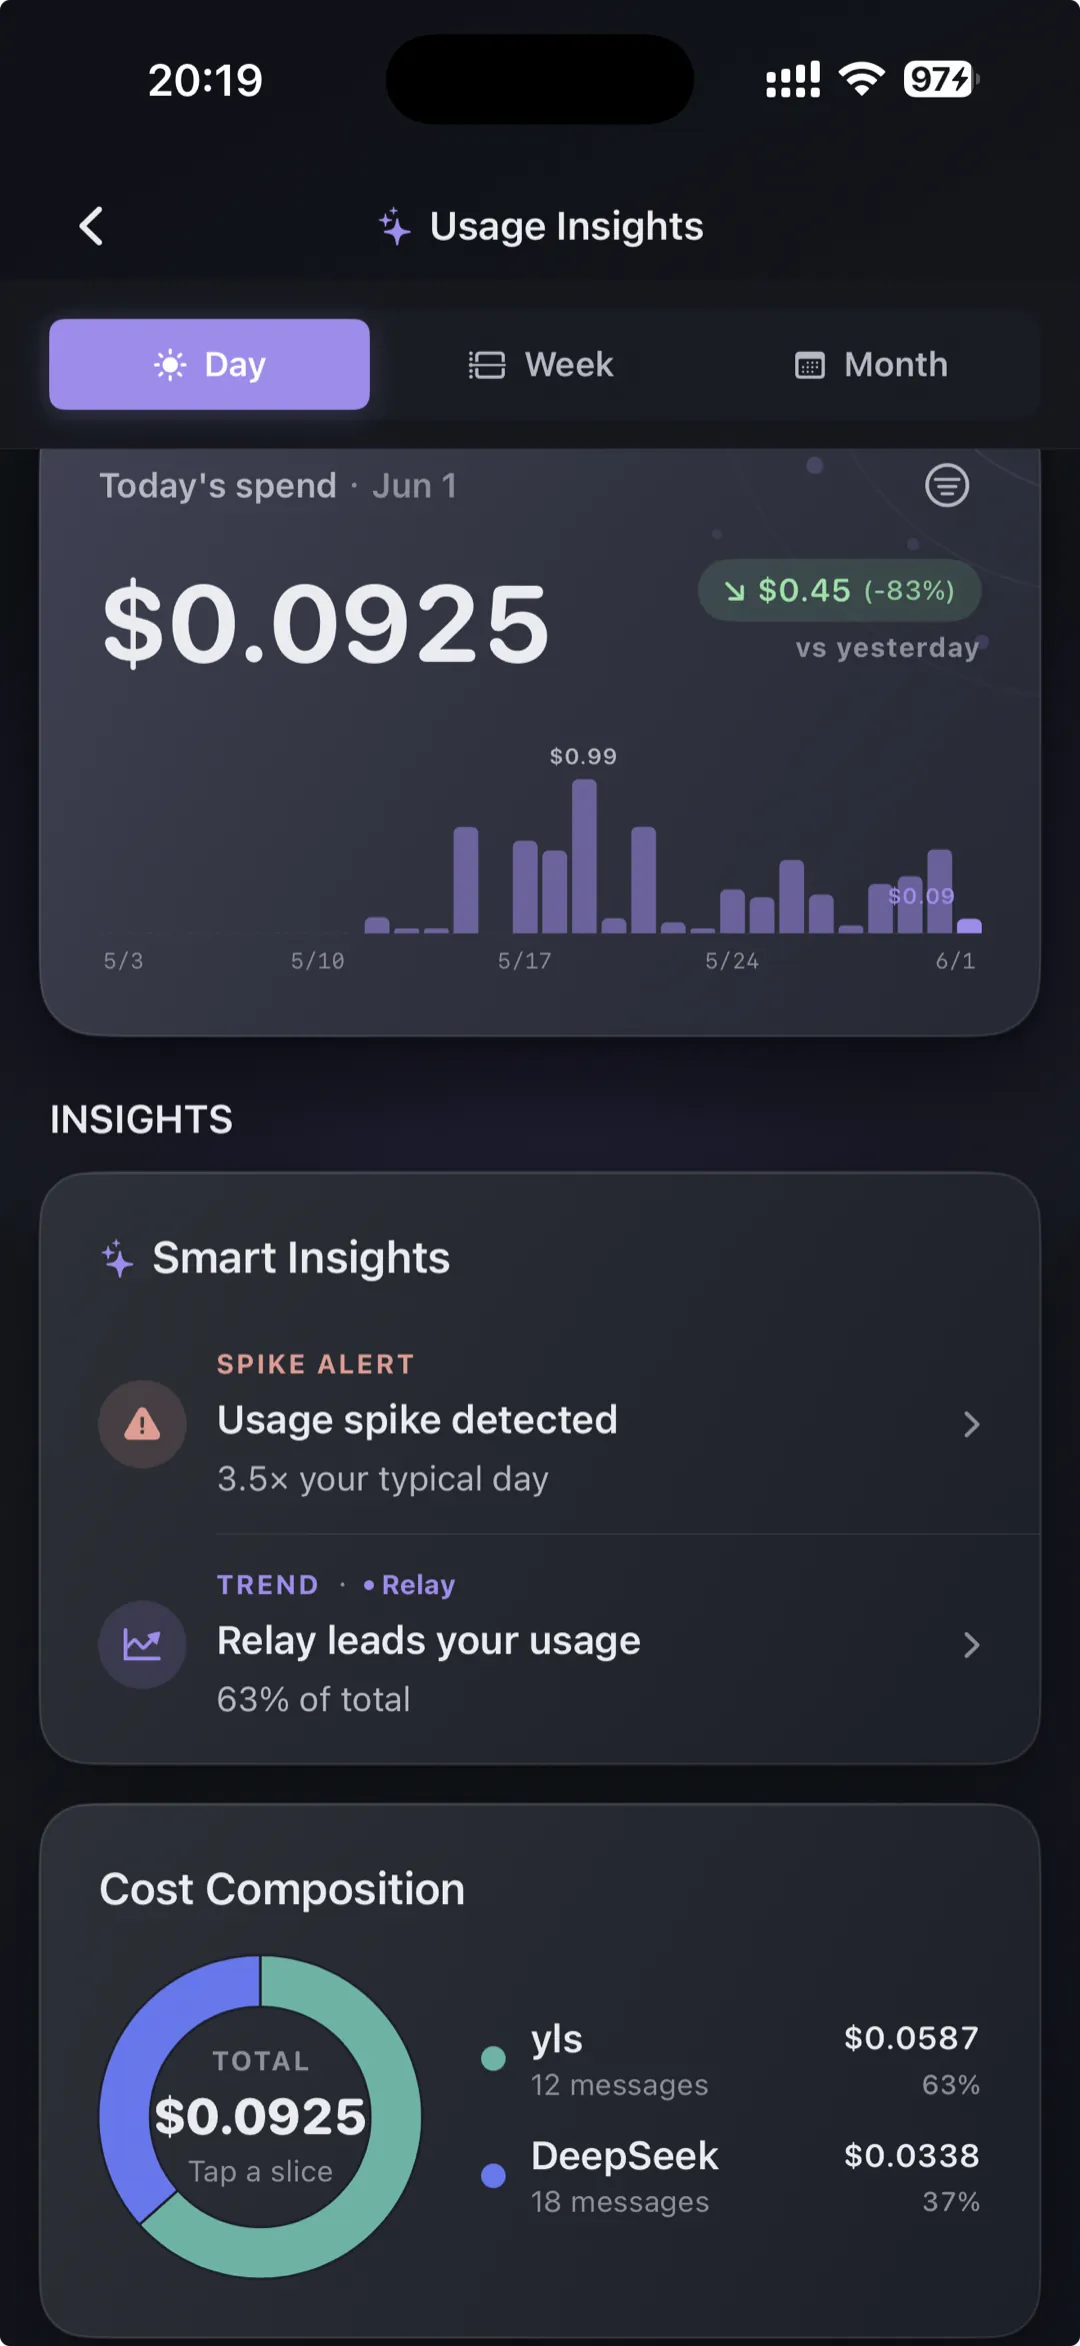
Die tiefere Auswertung sitzt hinter den bezahlten Plänen. Usage Insights – Ausgaben aufgeschlüsselt nach Anbieter und Modell, Monatstrends und Budget-Warnungen – gehört zu Pro und Lifetime, die Stand 24. Juli 2026 $9.99 im Monat, $59.99 im Jahr oder einmalig $149.99 kosten. Diese Pläne kaufen nur Software-Funktionen und enthalten keine KI-Nutzung, keine Modell-Credits und kein Anbieter-Abo. Der Preis der App und der Preis deiner Tokens werden also nie zu einer Zahl gebündelt, die du nicht mehr auseinandernehmen kannst.
Was diese Zahlen dir nicht sagen können
Eine Preistabelle ist ein Anfang, keine Entscheidung. Drei Dinge, die sie auslässt, sollten klar dastehen, weil sie einen Vergleich, der allein am Preis entschieden aussah, regelmäßig umdrehen.
Das erste ist Tokens pro Aufgabe. Zwei Modelle zum selben Satz können sich deutlich darin unterscheiden, wie viele Tokens sie brauchen, um dieselbe Antwort zu liefern, und ein wortreiches günstiges Modell kann pro fertiger Aufgabe mehr kosten als ein knappes teures. Das zweite ist die Wiederholungsrate: Eine Antwort, die du neu erzeugen musst, wird zweimal berechnet. Das dritte ist alles außerhalb des Token-Zählers: Ratenlimits, Latenz, Kontextfenster, Verfügbarkeit in deiner Region, und ob das Modell die Dateiformate lesen kann, mit denen du arbeitest.
Die ehrliche Art, einen Vergleich wie diesen zu nutzen, ist als Vorauswahl. Streich die Zeilen, die klar außerhalb deines Budgets liegen, probier zwei oder drei Kandidaten an deiner eigenen echten Arbeit, und schau, was eine fertige Aufgabe kostet, nicht was eine Million Tokens kostet. Die Schätzung pro Nachricht gibt es genau dafür, damit dieses Experiment einen Tag dauert und nicht einen Abrechnungszyklus.
Häufig gestellte Fragen
Was kostet eine Nachricht an eine LLM-API wirklich?
Warum ist Output teurer als Input?
Senkt Prompt-Caching die Rechnung wirklich?
Ist eine nutzungsbasierte API günstiger als ein monatliches KI-Abo?
Warum kostet dasselbe Modell auf verschiedenen Plattformen verschieden viel?
Wie aktuell sind die Preise in diesem Artikel?
Schlägt Oriveo auf das auf, was Anbieter berechnen?
Passende Beiträge
Sieh beim Senden, was jede Nachricht kostet
Oriveo zeigt geschätzte Kosten an jeder Nachricht zum Listenpreis des Anbieters, über 15 offizielle Anbieter und 700+ Modelle, auf iPhone, Android und im Web – ohne Aufschlag auf die Nutzung beim Anbieter.